
エンベディングとは
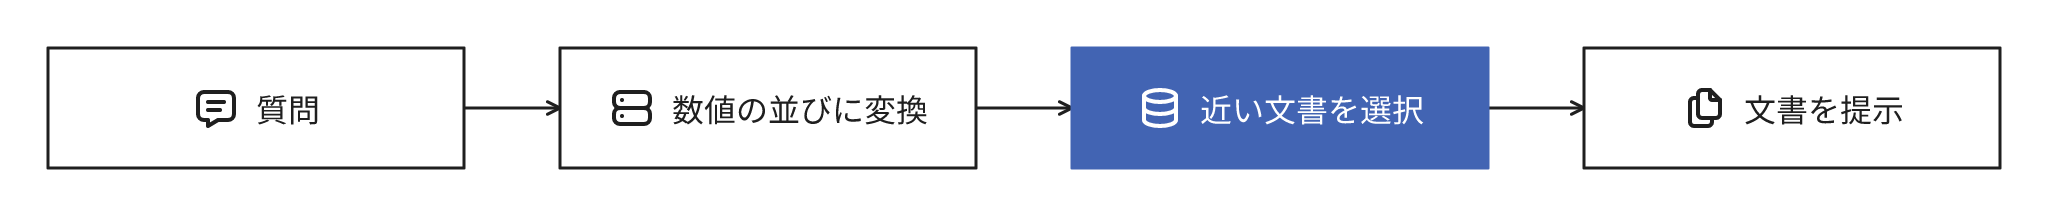
エンベディングは、文章や画像の意味を数値の並びに変換したもので、意味の近い文書の検索などに利用します。テキストは浮動小数点数の並びとして表現され、2つの並びの距離の近さが意味の近さに対応します。この数値の並びをベクトルと呼び、日本語では埋め込みベクトルとも呼びます。エンベディングを利用した検索はベクトル検索と呼ばれます。
たとえば社内の文書検索で「経費精算の締め日はいつか」と入力すると、「精算の申請期限」と記載された規程の該当箇所が上位に表示されます。質問と文書で語が一致していなくても、意味の類似した文書も上位に表示されます。
エンベディングを利用すると、語の一致ではなく意味の近さで文書を比較できます。検索のほか重複した文書の検出、文章の分類、推薦、異常の検出に利用されています。
類似した用語との違いは変換した結果が何を表現するかです。エンベディングは文章の意味を、ベクトル空間の中の位置として表現します。キーワード検索が語を含む文書だけを抽出するのに対し、エンベディングは語が異なっても意味が類似した文書を候補に含めます。文章を分類するモデルは事前に設定した区分のどれに該当するかを出力しますが、エンベディングは区分を前提とせず、位置だけを出力します。
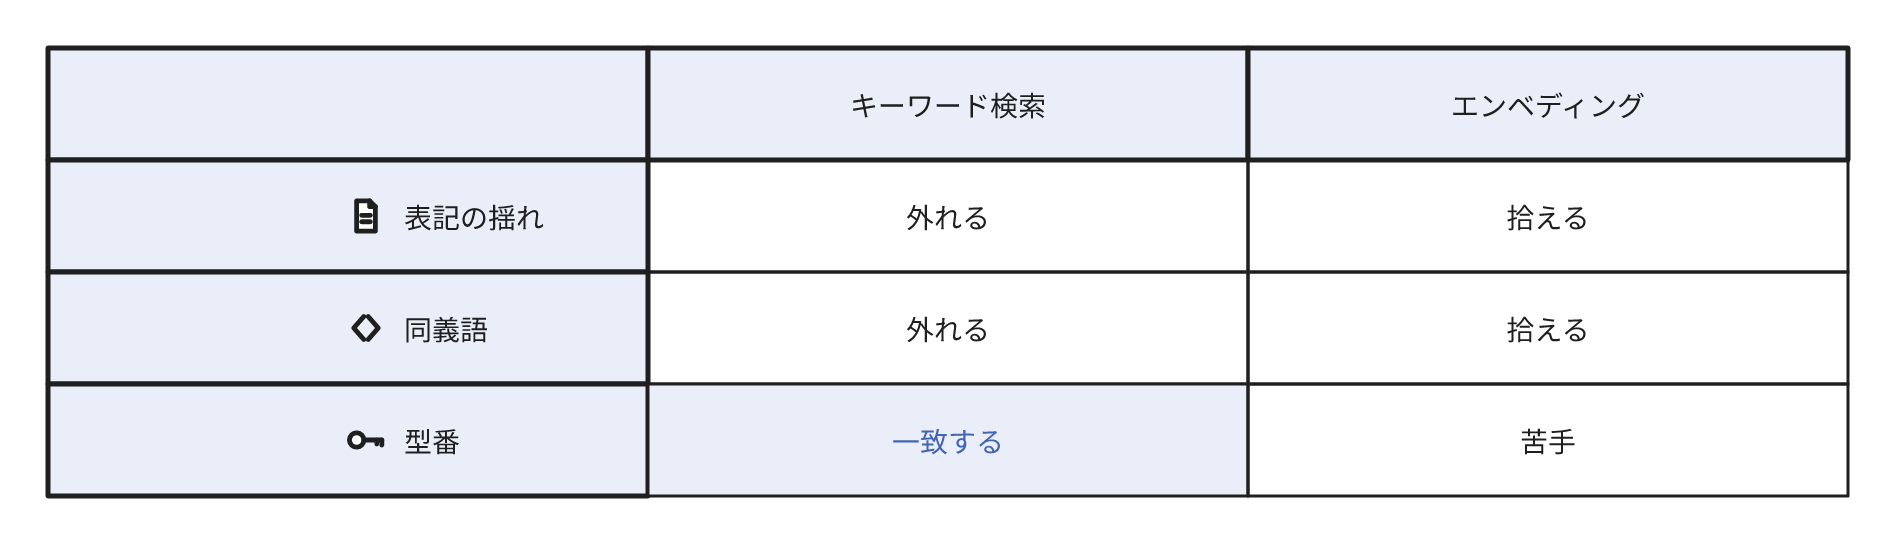
キーワード検索で該当文書を検出できない状況
キーワード検索は入力した語を含む文書を提示します。語の表記が文書によって異なる場合や、同じ意味を別の語で記載している場合は、該当する文書が候補に含まれません。
キーワード検索とベクトル検索を併用する方式はハイブリッド検索と呼ばれ、検索サービスの機能として提供されています。
何に利用するか
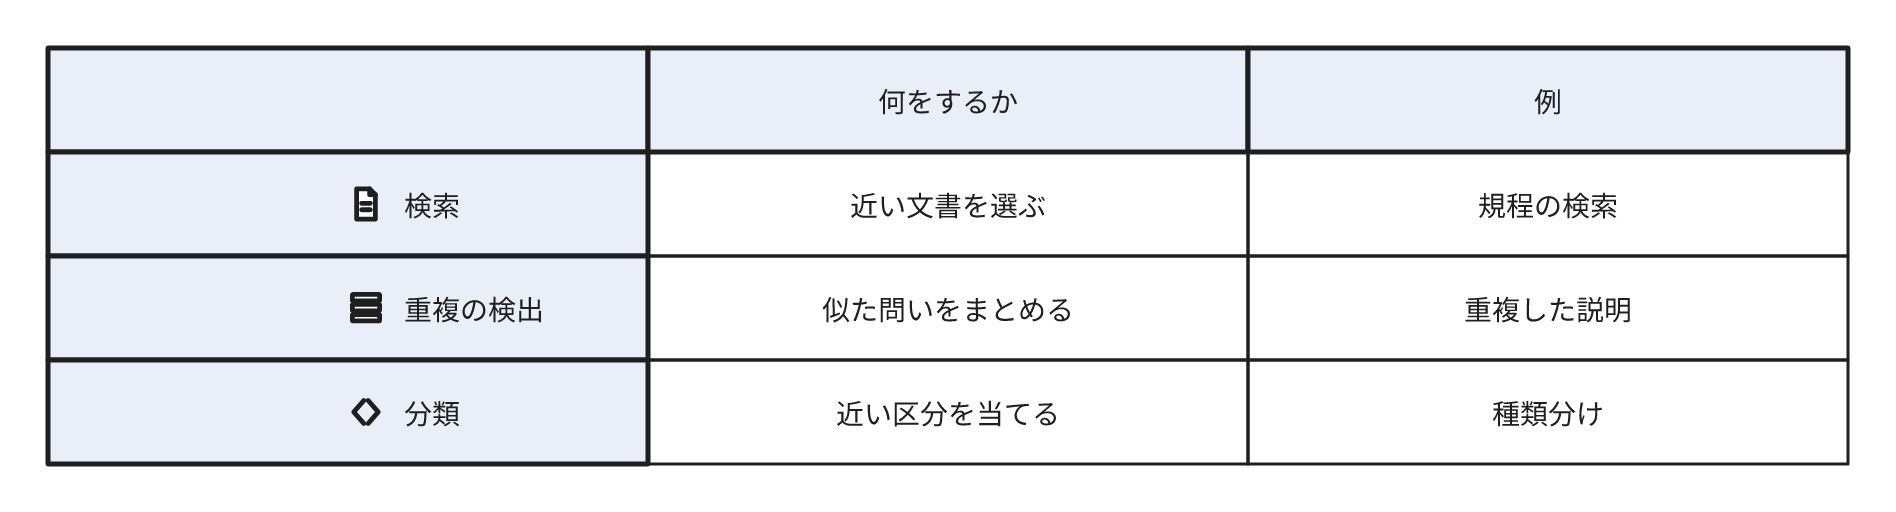
次の用途はいずれも意味の近さの測定を基礎にしています。
| 用途 | 何をするか | 例 |
|---|---|---|
| 検索 | 質問と意味が類似した文書を抽出する | 社内規程の検索、製品マニュアルの問合せ対応 |
| 重複の検出 | 類似した文書や問合せを集約する | 同じ内容の問合せの集約、重複した商品説明の検出 |
| 分類 | 区分の説明文や既存文書と比較し、最も近い区分を付与する | 問合せの種類分け、文書のタグ付け |
| 推薦 | 利用者が閲覧した文書に類似した文書を提示する | 関連資料の提示、類似した記事の表示 |
| 異常の検出 | ほかの文書との距離が一定以上のものを検出する | 通常と異なる報告の検出 |
生成AIに社内の資料を参照させる仕組みはRAG(Retrieval-Augmented Generation)と呼ばれ、資料を検索する工程にエンベディングを利用することが多くあります。ただし、回答は生成AIが作成するため、エンベディングは回答の正確性を保証しません。
検索の精度を左右する要素
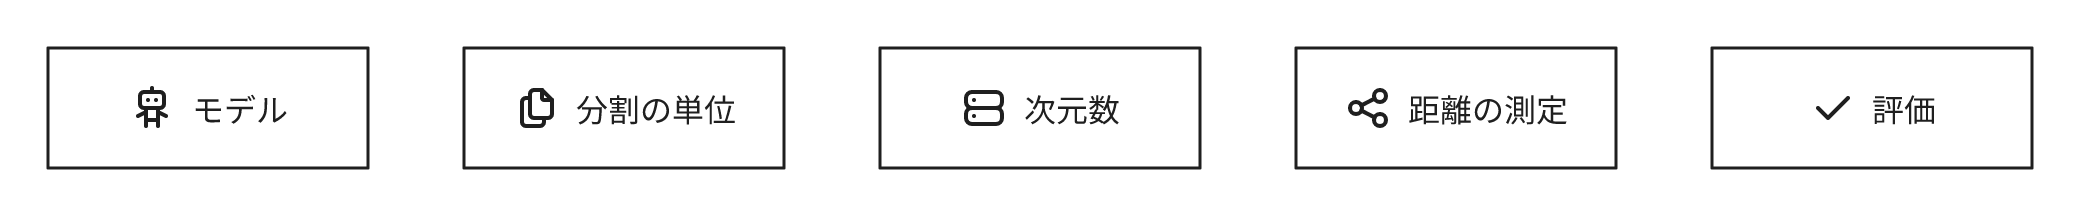
同じ文章でも変換に利用するモデルや分割の単位などによって検索の結果が異なります。
- モデルの選択。モデルごとに学習に利用した言語や分野が異なるため、日本語の文書には日本語を含むデータで学習したモデルを選択する
- 分割の単位。長い文書をそのまま変換すると、複数の話題が1つのベクトルに混在し、個々の話題と質問との近さが測定しにくくなる。見出しや段落の単位に分割して変換する
- 次元数。モデルが出力する数値の並びの長さで、1536や3072といった値が採用されている。次元数が多いほど微細な違いを表現できる余地は増加するが、保存と計算の量も増加する。精度は学習の方法にも依存するため、次元数だけでは判断できない。モデルの提供者によっては出力する次元数を指定して削減できる
- 距離の測定方法。2つのベクトルの角度で近さを測定するコサイン類似度が一般的に利用される。ベクトルの長さではなく向きだけを比較するため、文書の長さに左右されにくい
- 評価。目安として過去の質問を50件程度選択し、キーワード検索で該当文書を検出できなかった質問も含める。キーワード検索とベクトル検索のそれぞれで、上位5件に該当文書が含まれる割合を比較する。改善が10ポイント未満なら、分割の単位とモデルを再検討する
費用と運用
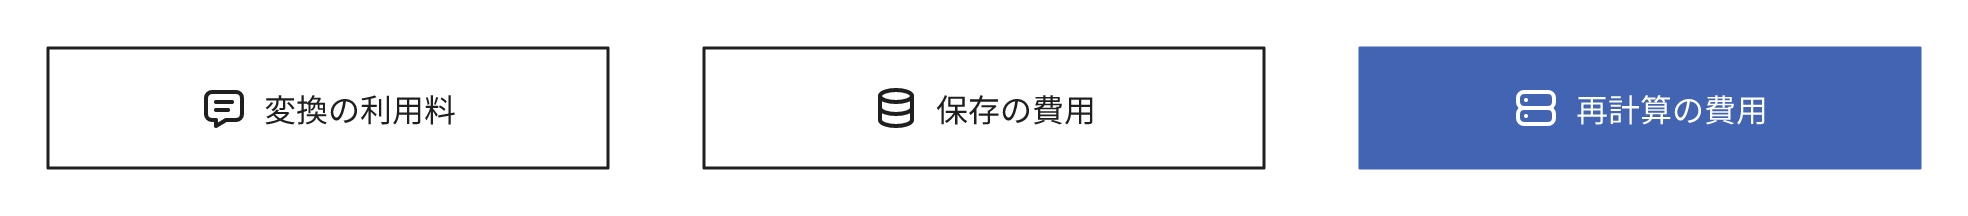
費用には変換の都度発生する利用料、変換した結果の保存費用、モデル変更時の再計算費用があります。
- 変換の利用料。入力した文章の量に比例し、量はトークンという単位で計測する。text-embedding-3-smallの料金は100万トークンあたり0.02ドル、text-embedding-3-largeが0.13ドル。日本語は英語と比較して同じ内容でもトークン数が多くなる傾向があるため、実際の文書でトークン数を計測して算定する
- 保存の費用。数値1つを4バイトで保存する場合、ベクトル1件の容量は次元数×4バイトで、1536次元なら約6キロバイト。100万件で約6ギガバイトとなり、検索用の索引の分が加算される
- 再計算の費用。モデルを変更すると、変更前と変更後のモデルではベクトル空間が異なり、変換済みのベクトルを変更後のベクトルと比較できないため、すべての文書を再計算する。100万件を1件500トークンで再計算すると5億トークンで、text-embedding-3-smallの料金では約10ドルになる
運用では文書の追加と更新のたびに変換と保存を実施します。文書の閲覧権限を変更したときは、ベクトルと一緒に保存した閲覧可能な部署や利用者の情報も同時に更新します。検索結果を利用者の権限で限定しないと、権限のない文書が候補に含まれます。
モデルの提供者が最新のバージョンを公開した場合は、移行の要否を評価します。利用中のモデル名とバージョンを記録しておきます。
主な費用は変換の利用料ではなく、評価用の質問と正解文書の作成、分割方法の設計、再計算と再評価の作業時間です。設計と初回評価で、目安として数人日を想定します。
エンベディングを利用しないほうがよい状況
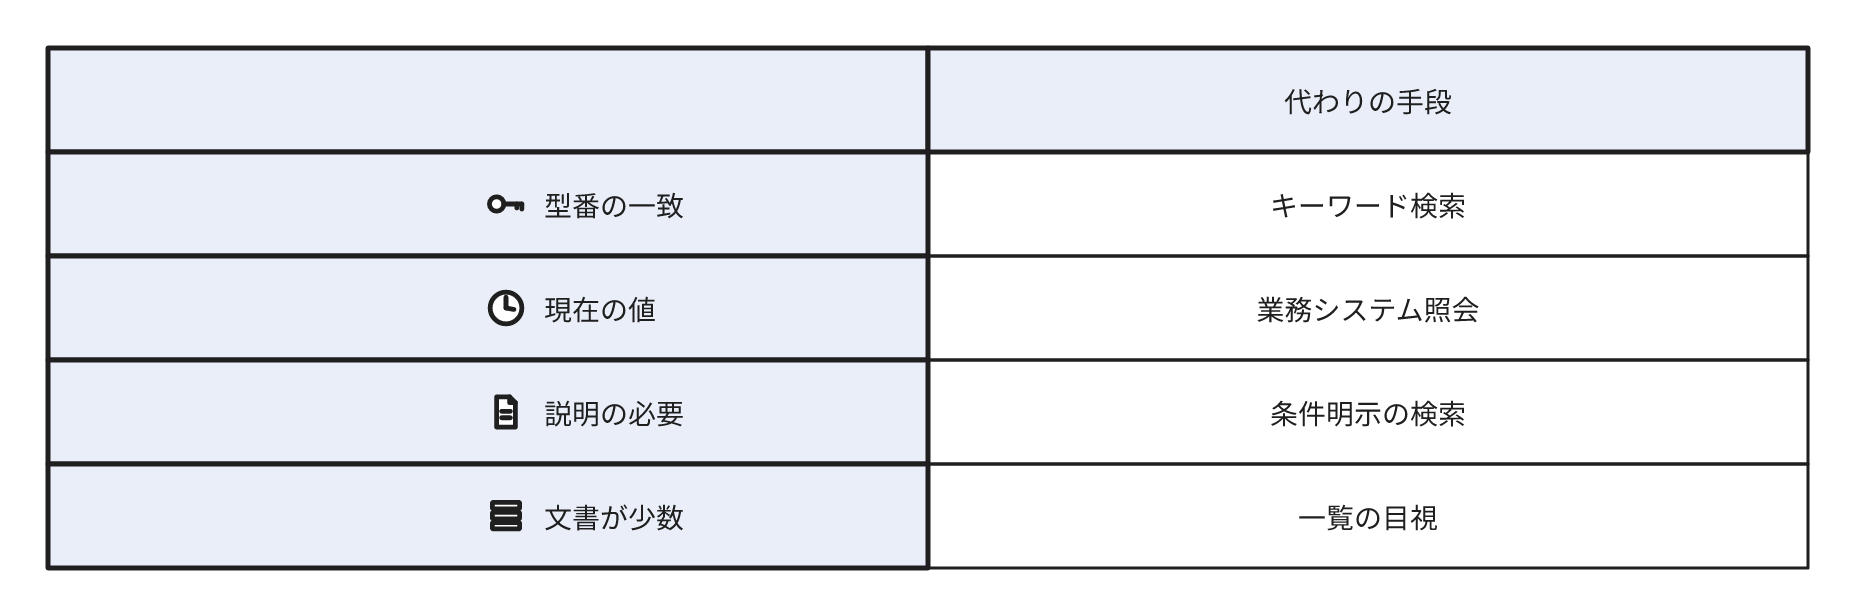
- 型番、条文番号、社員番号のように、文字の一致で検索する項目。意味の近さだけでは候補に含まれないことがあるため、キーワード検索を利用する
- 在庫数や残高のように、現在の値が必要な状況。業務システムから値を取得する
- 判断の理由の説明が必要な状況。なぜその文書が選択されたかを数値の並びから説明できないため、条件を明示した検索や人の確認で対応する
- 文書が数十件で、一覧を人が確認できる規模。検索の仕組みを用意せず、人が一覧を閲覧する
型番や条件による絞り込みはキーワード検索やフィルターで実施し、検索で得た候補をリランカーと呼ばれる順位付け用のモデルで、質問との関連度の順に並べ替える構成もあります。
よくある誤解
エンベディングは文章の内容を理解している
エンベディングは文章の意味の近さを数値の位置として表現するもので、内容の正確性を判定するものではありません。事実と異なる文書でも内容が類似していれば上位に表示されます。検索の結果を業務に利用する場合は、原典で内容も確認します。
次元数を増加させれば検索の精度が向上する
次元数が多いほど微細な相違を表現できますが、精度は学習の方法と対象の文書によっても変化し、保存と計算の量も増加します。
一度作成すれば再作成は不要
文書を追加、更新するたびに、その文書の変換と保存が必要です。モデルを変更した場合はすべての文書を再計算します。更新した文書の変換が遅延すると、検索の結果に更新前の内容が表示され続けます。
関連用語
RAG
成熟度:
大規模言語モデル
成熟度:
生成AI
成熟度:
セマンティックレイヤー
成熟度:
ファインチューニング
成熟度:
同じ分野の用語
AI・機械学習の用語をすべて見るお問い合わせ・ご相談
システム開発、データ活用、プロダクトづくりのことならお気軽にご相談ください。要件が固まる前の整理や、お見積もりだけのご依頼も承ります。