
RAGとは
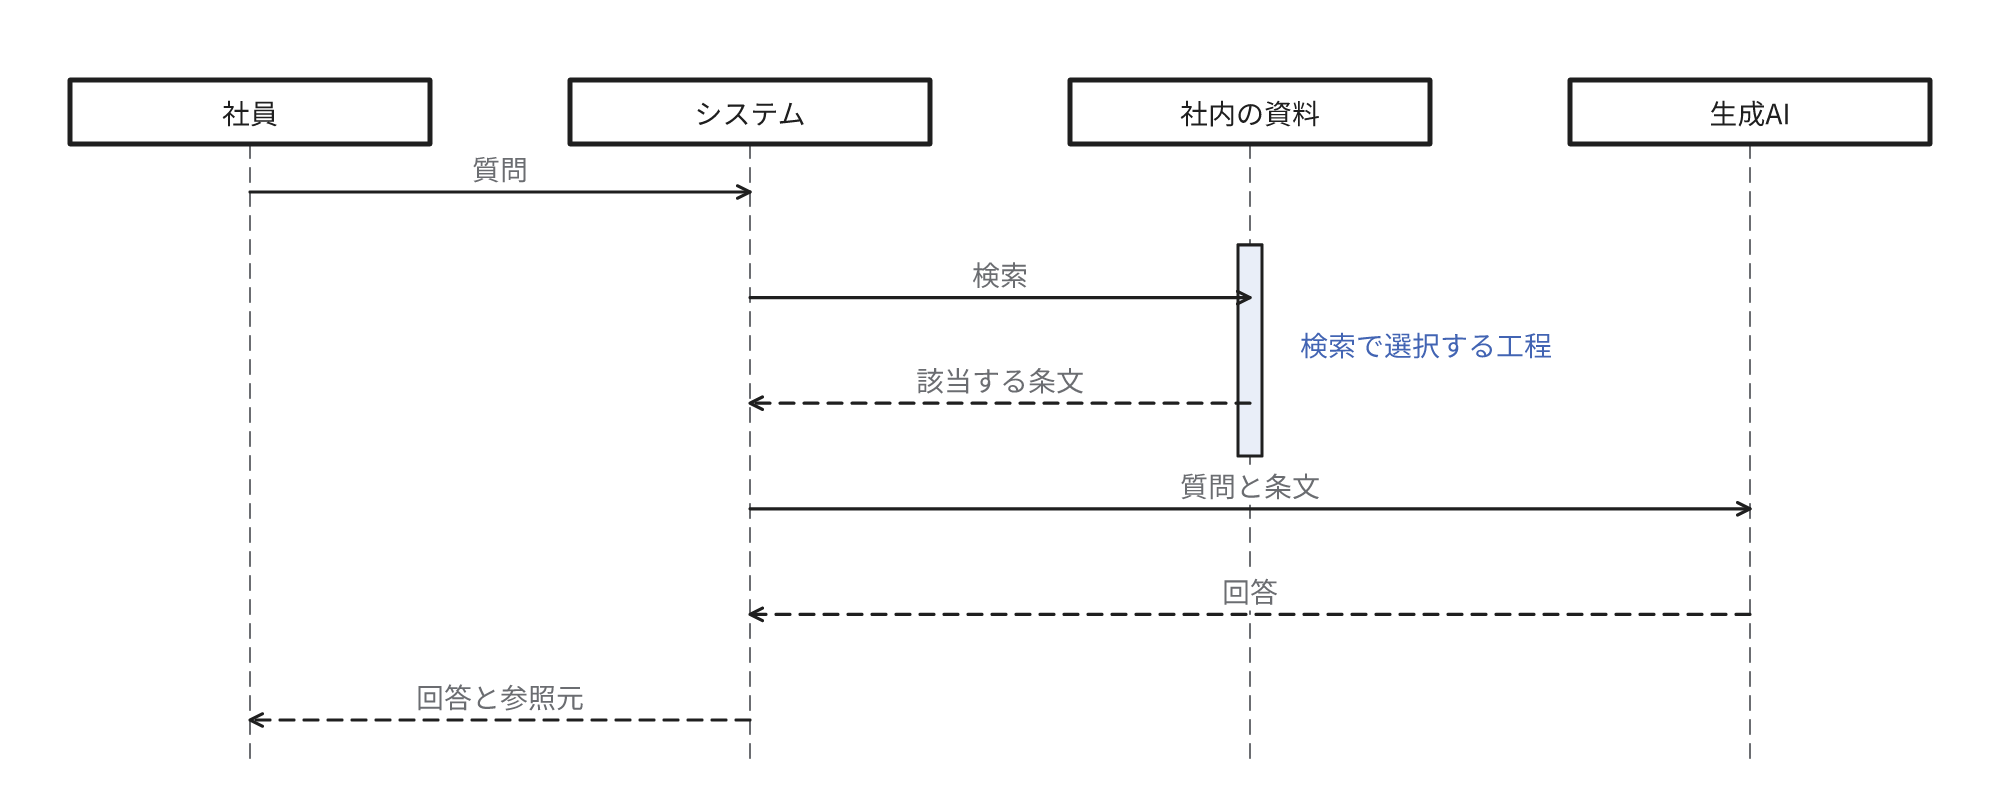
RAG(Retrieval-Augmented Generation)は、質問に関係する資料を検索で抽出し、該当した文章を質問とともに生成AIへ入力し、回答を作成させる仕組みです。日本語では検索拡張生成と呼びます。回答を作成する生成AIのモデルを再学習させずに、自社の知識を回答へ反映できます。
たとえば社員がチャット画面で出張の日当の金額を質問すると、システムが旅費規程から該当する条文を検索し、その条文を基に回答を作成して、参照した規程の名称と箇所を併記して表示します。記憶だけで回答する人ではなく、書庫から該当する資料を取得し、参照しながら回答する担当者に近いです。
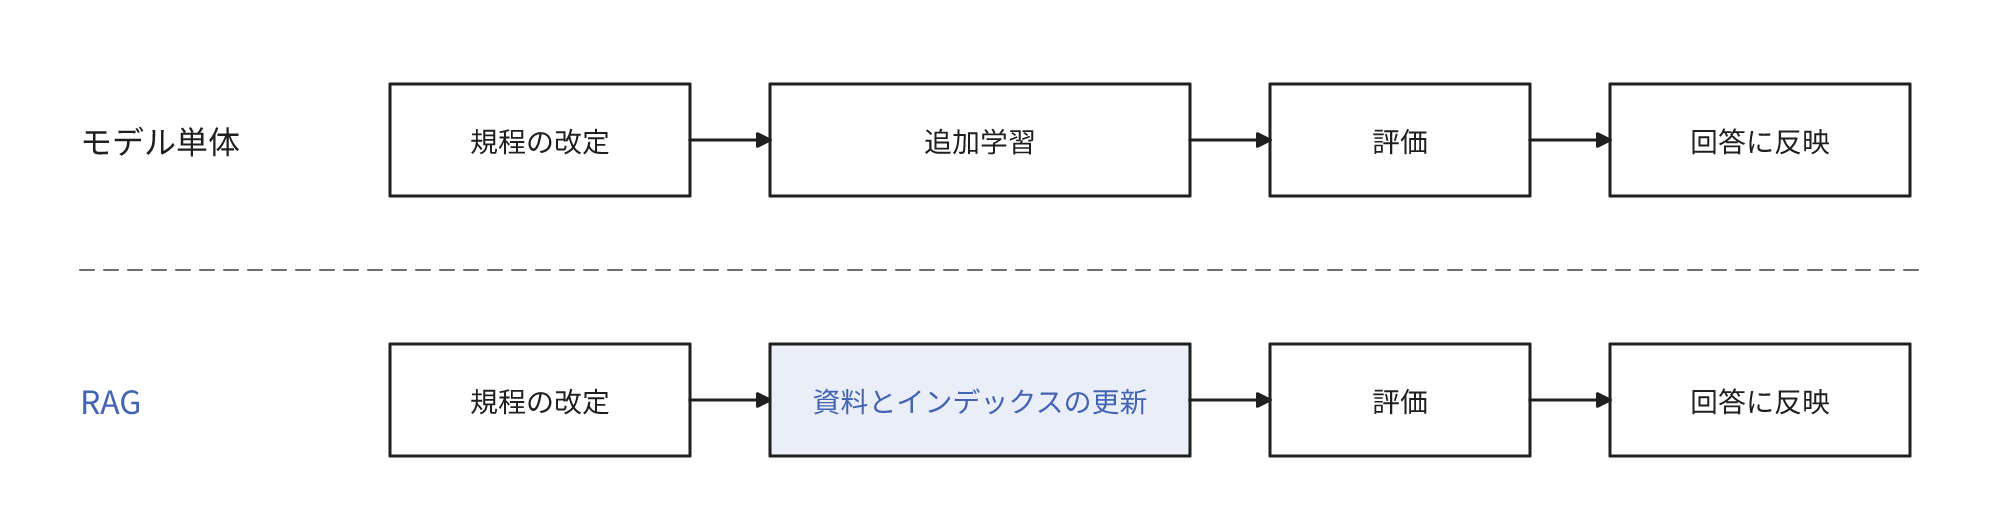
目的はモデルが学習していない自社の規程、手順書、製品仕様を回答に含めることです。ファインチューニングは学習済みのモデルに追加のデータを学習させてモデル自体を変更する方法です。RAGはモデルを変更せず、回答のたびに入力する資料を再選択します。
RAGは社内の全文検索とも異なり、検索結果の一覧ではなく、資料を基に作成した文章で回答します。利用者が資料を手作業で添付する使い方や、特定の資料の全文を毎回入力する方法は、検索で選択する工程がないためRAGとは呼びません。
生成AI単体では社内の質問に回答できない理由
外部の資料を参照しないモデル単体は、学習した時点までの情報から回答を作成します。学習データと質問文のどちらにも含まれていない自社の規程や過去の対応記録は、正確に回答できません。知識をモデルの学習に反映する方式では、規程が改定されるたびに追加学習と評価が必要になります。
RAGでは資料を改定版に置換し、検索のために資料から作成するインデックスの更新が完了すれば、以後の回答に改定後の内容を反映できます。回答に参照元を表示でき、利用者がその資料を閲覧して内容を確認できる点も利点として紹介されています。
適合する業務と適合しない業務
答えが社内の文書のどこかに記載されていて、参照元の確認で十分な業務がRAGに適合します。
- 就業規則、経費精算、情報システムの利用手順に関する社内の問合せ対応
- 製品マニュアルや仕様書を参照する問合せ窓口の回答案の作成
- 過去の報告書、議事録、障害対応記録からの類似事例の検索
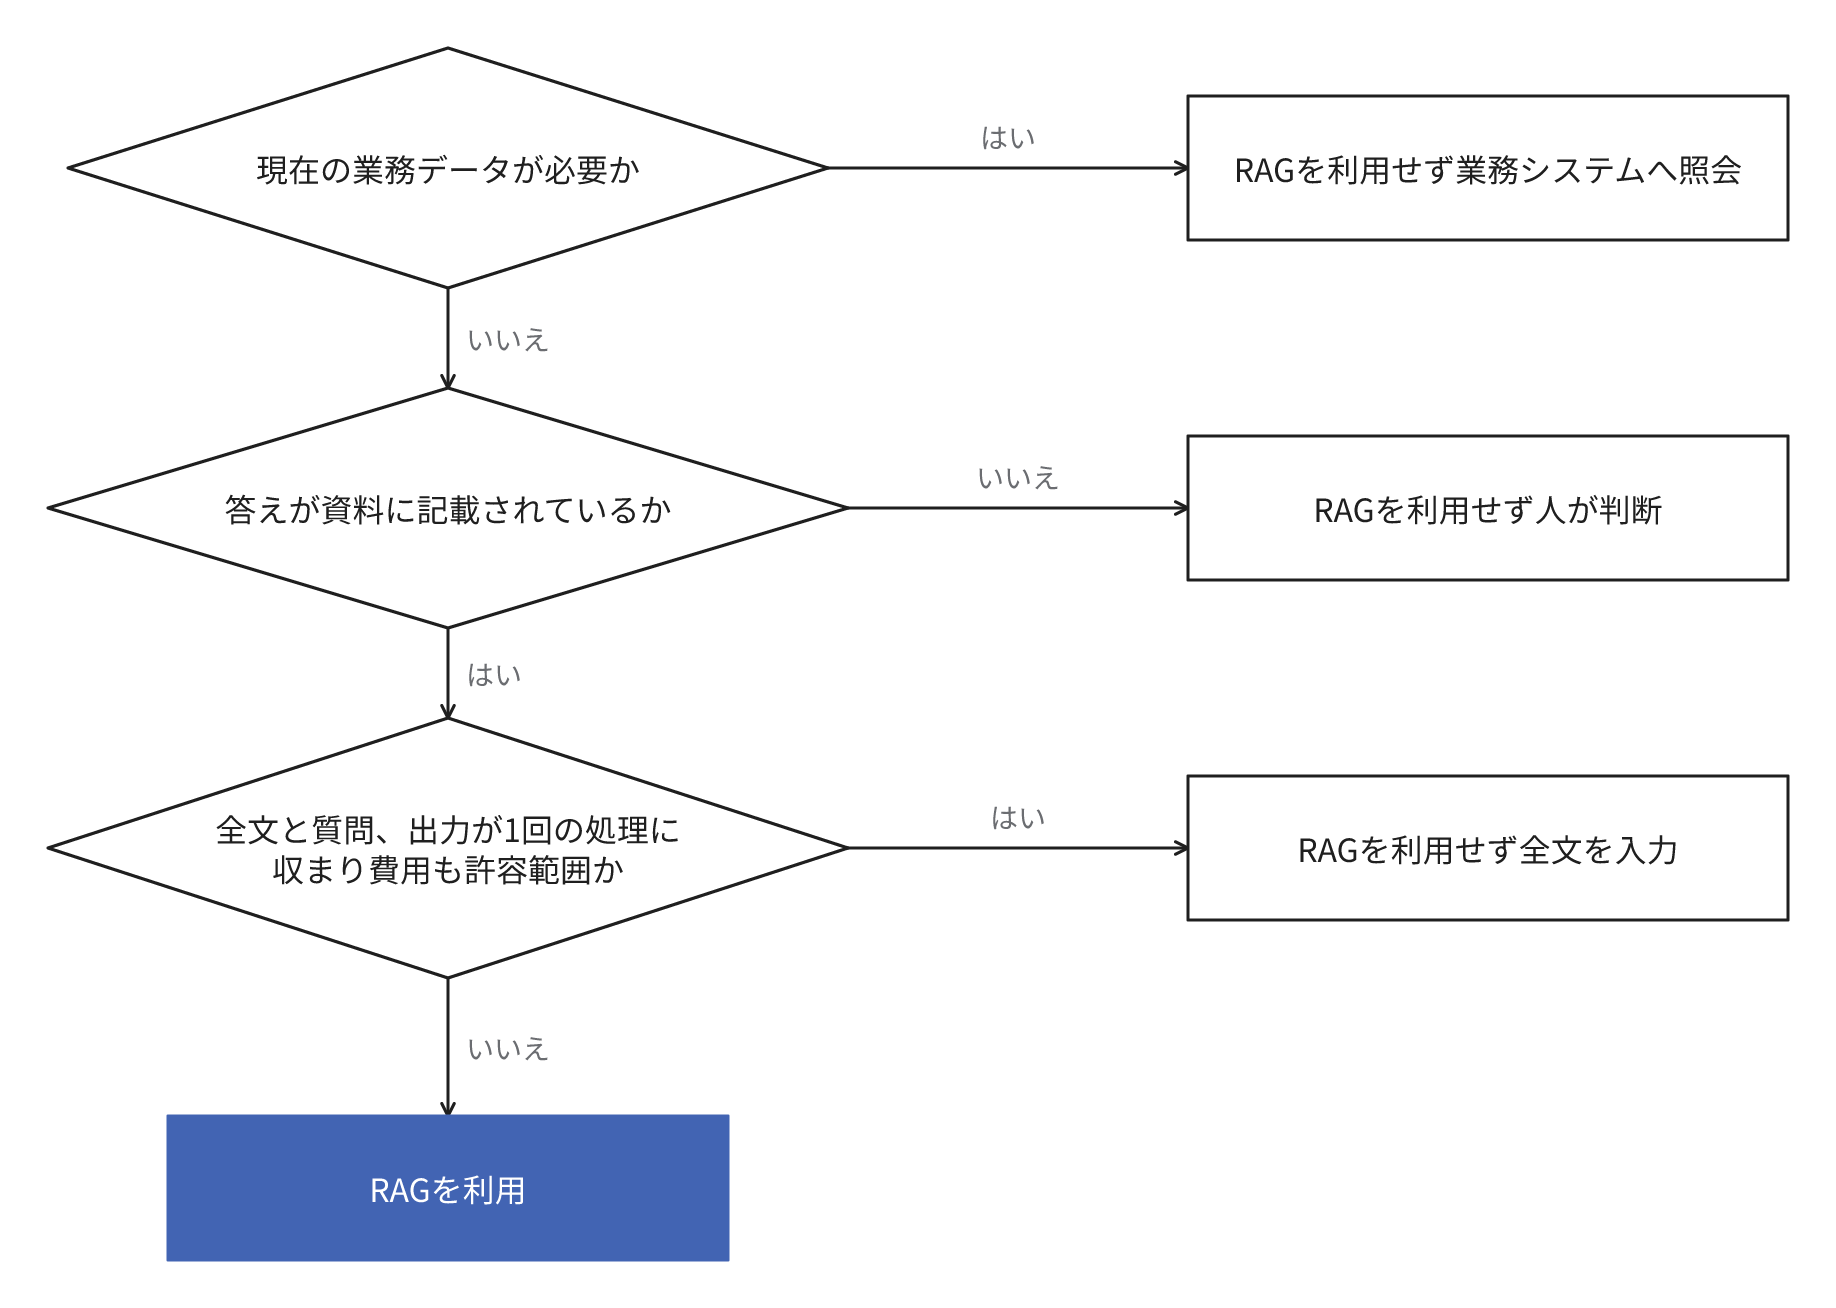
次の業務の質問は文書を検索するRAGでは回答の正確性を保証できないため、RAGを利用せずに別の手段で対応します。
- 在庫数、価格、残高のような現在の業務データが必要な質問。値の変化に対して文書とインデックスの更新が遅延する場合があり、更新前の値で回答するおそれがあるため、業務システムへ照会する。生成AIから業務システムのAPIを呼び出して回答させる構成も可能
- 資料に答えが記載されていない企画や個別の判断。検索した資料だけでは結論の正確性を保証できないため、人が判断する
コンテキストウィンドウは生成AIが1回に処理できる情報量の上限です。入力する資料や質問のほかに出力と、モデルによっては推論の分も含みます。契約書1本の要約や2つの版の比較で、全文と質問、出力の分の合計がコンテキストウィンドウの範囲内で欠落なく処理でき、費用と待ち時間も許容範囲なら、検索で資料を選択する必要がないため、RAGを利用せずに全文を入力します。
RAGに適合する業務でも社内の資料を検索対象とする前に、利用する生成AIの契約と環境でその資料を入力してよいかを確認します。
精度を左右する資料と検索
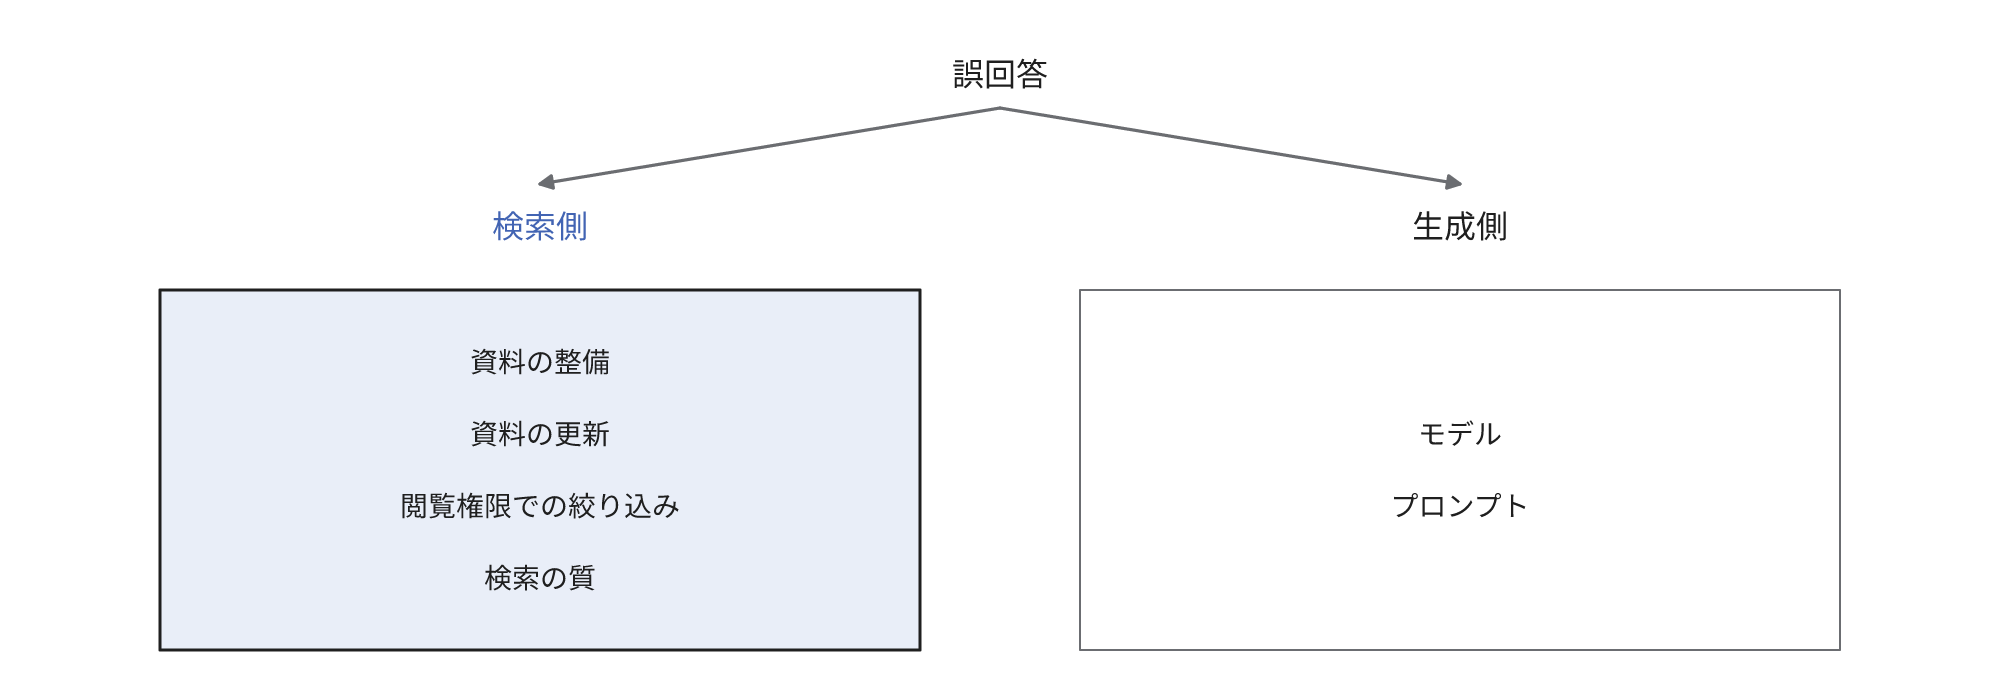
RAGの誤回答は検索側と生成側の2つの観点で確認します。検索側には必要な資料の不足や無関係な資料の混入があり、生成側には該当する資料を入力してもモデルが誤答する場合があります。誤回答が発生したらまずどちらに原因があるかを確認します。検索の問題はモデルを性能の高いものに変更するだけでは解決できません。生成側ではモデルと、生成AIへの指示であるプロンプトを確認します。
資料と検索の側で精度を左右するのは次の4点です。
- 資料の整備。旧版と新版の規程が併存すると旧版で回答することがある。図表やスキャンした書類の文字は取り込みで欠落することがある
- 資料の更新。改定した資料とインデックスを、定期的またはその都度更新し続ける必要がある
- 権限。閲覧権限のない資料が回答に含まれないよう、システム側で利用者の権限を判定し、文書単位で検索結果を絞り込む
- 検索の質。文章を数値に変換して意味の近さで検索するベクトル検索は、型番や条文番号のような正確な一致を検出できないことがあり、語の一致で検索するキーワード検索との併用で補完する
資料の側では安全面の対策も必要です。登録する文書に命令文が混入していると、モデルがそれを指示として処理するプロンプトインジェクションという攻撃も起こり得るため、検索対象とする文書の範囲を限定します。
評価の仕方
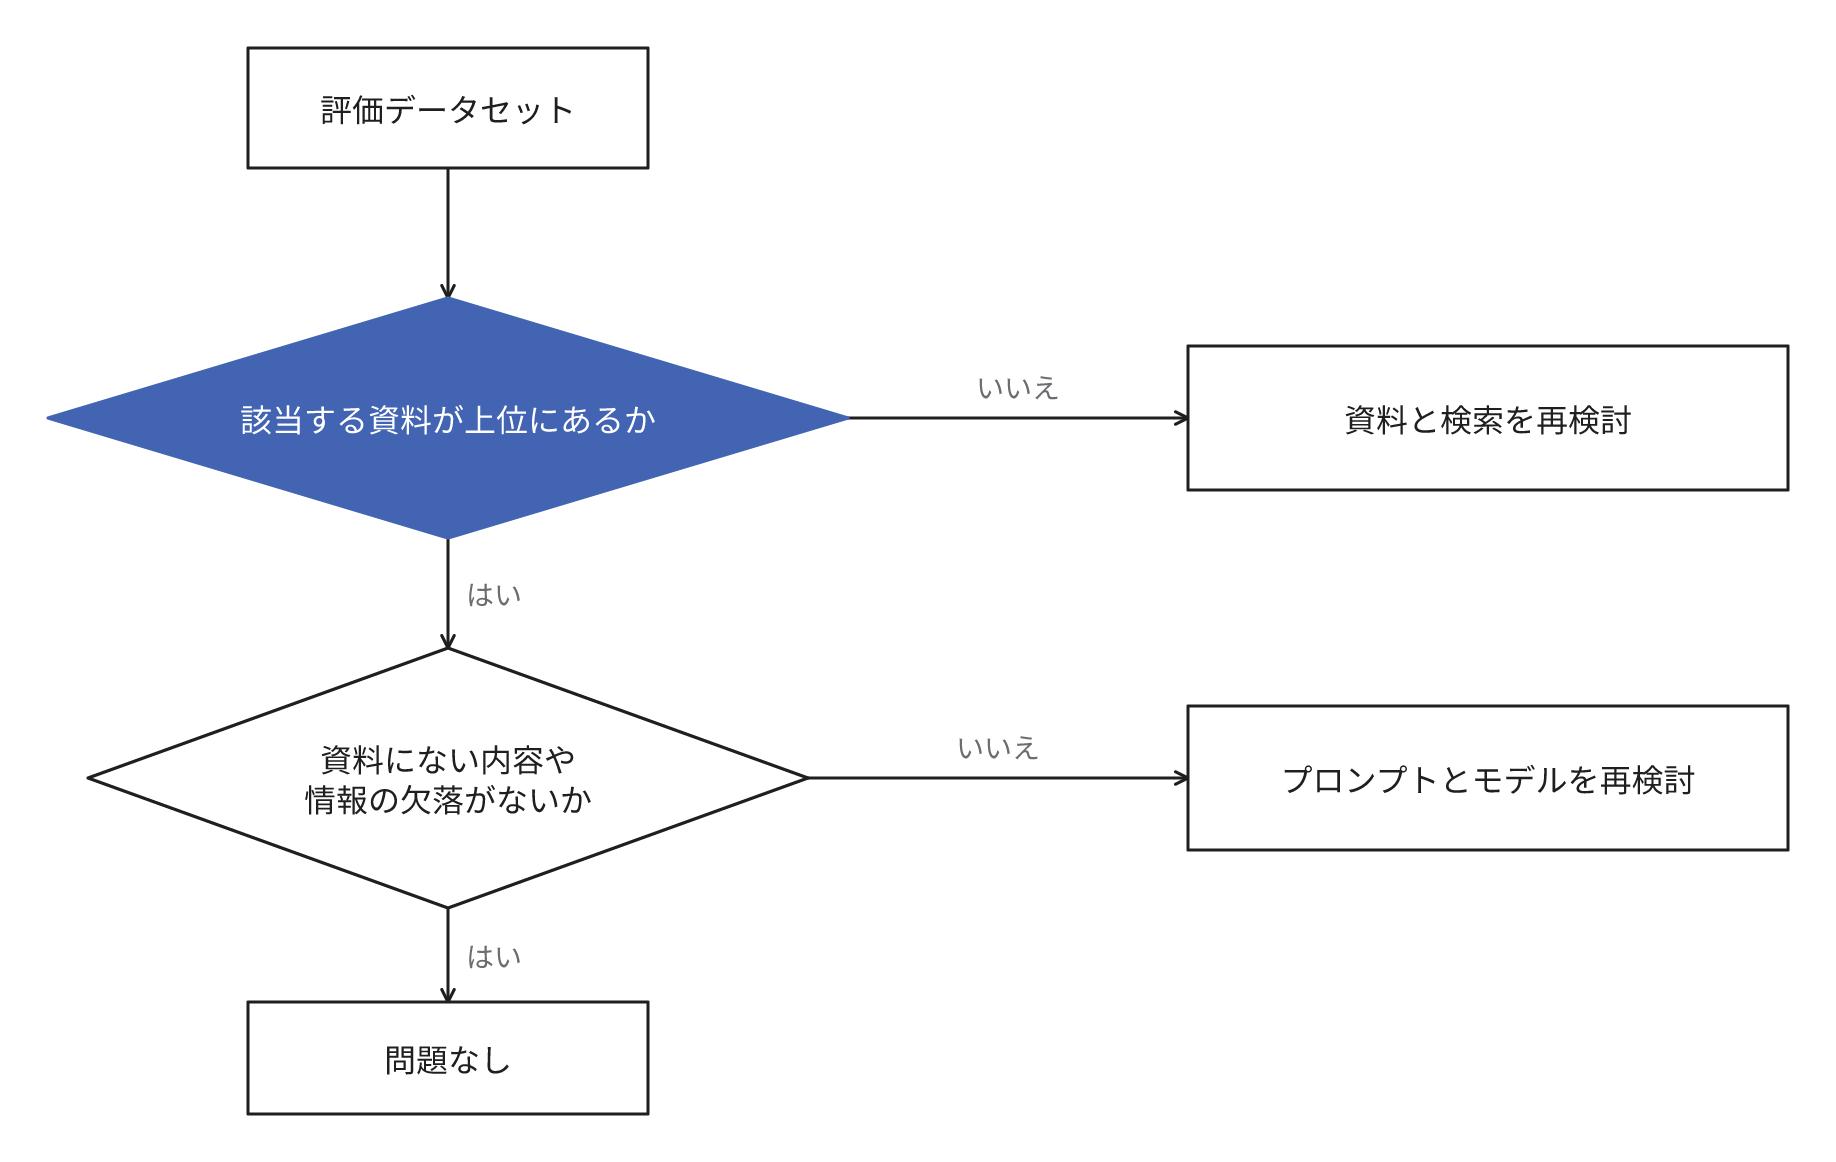
評価は検索と回答で個別に行います。回答だけを採点すると誤りの原因が資料と検索にあるのか、生成の側にあるのかを特定できません。
- 実際の問合せと、その答えが記載された資料の箇所を組にし、精度の評価に利用する評価データセットを作成する。初期の診断なら数十問からが目安で、部署、権限、改定前後の差を含める
- 検索の評価。該当する資料が検索結果の上位に含まれたかを確認する。検索だけを評価する方式を備えた製品もある
- 回答の評価。入力した資料にない内容を含んでいないかと、必要な情報の欠落がないかを別々の観点で採点する
- 資料にない質問も含め、答えがない旨を回答できるかを確認する
採点の一部を別の生成AIに担当させる方法もあります。ただし、その採点にも誤りがあるため、基準は業務を把握している人が決定し、抜き取りで確認します。検索で該当する資料を抽出できなかった質問は資料と検索の設定を、検索は適切で回答に誤りがあった質問はプロンプトやモデルを再検討します。
運用で継続的に発生する作業と費用
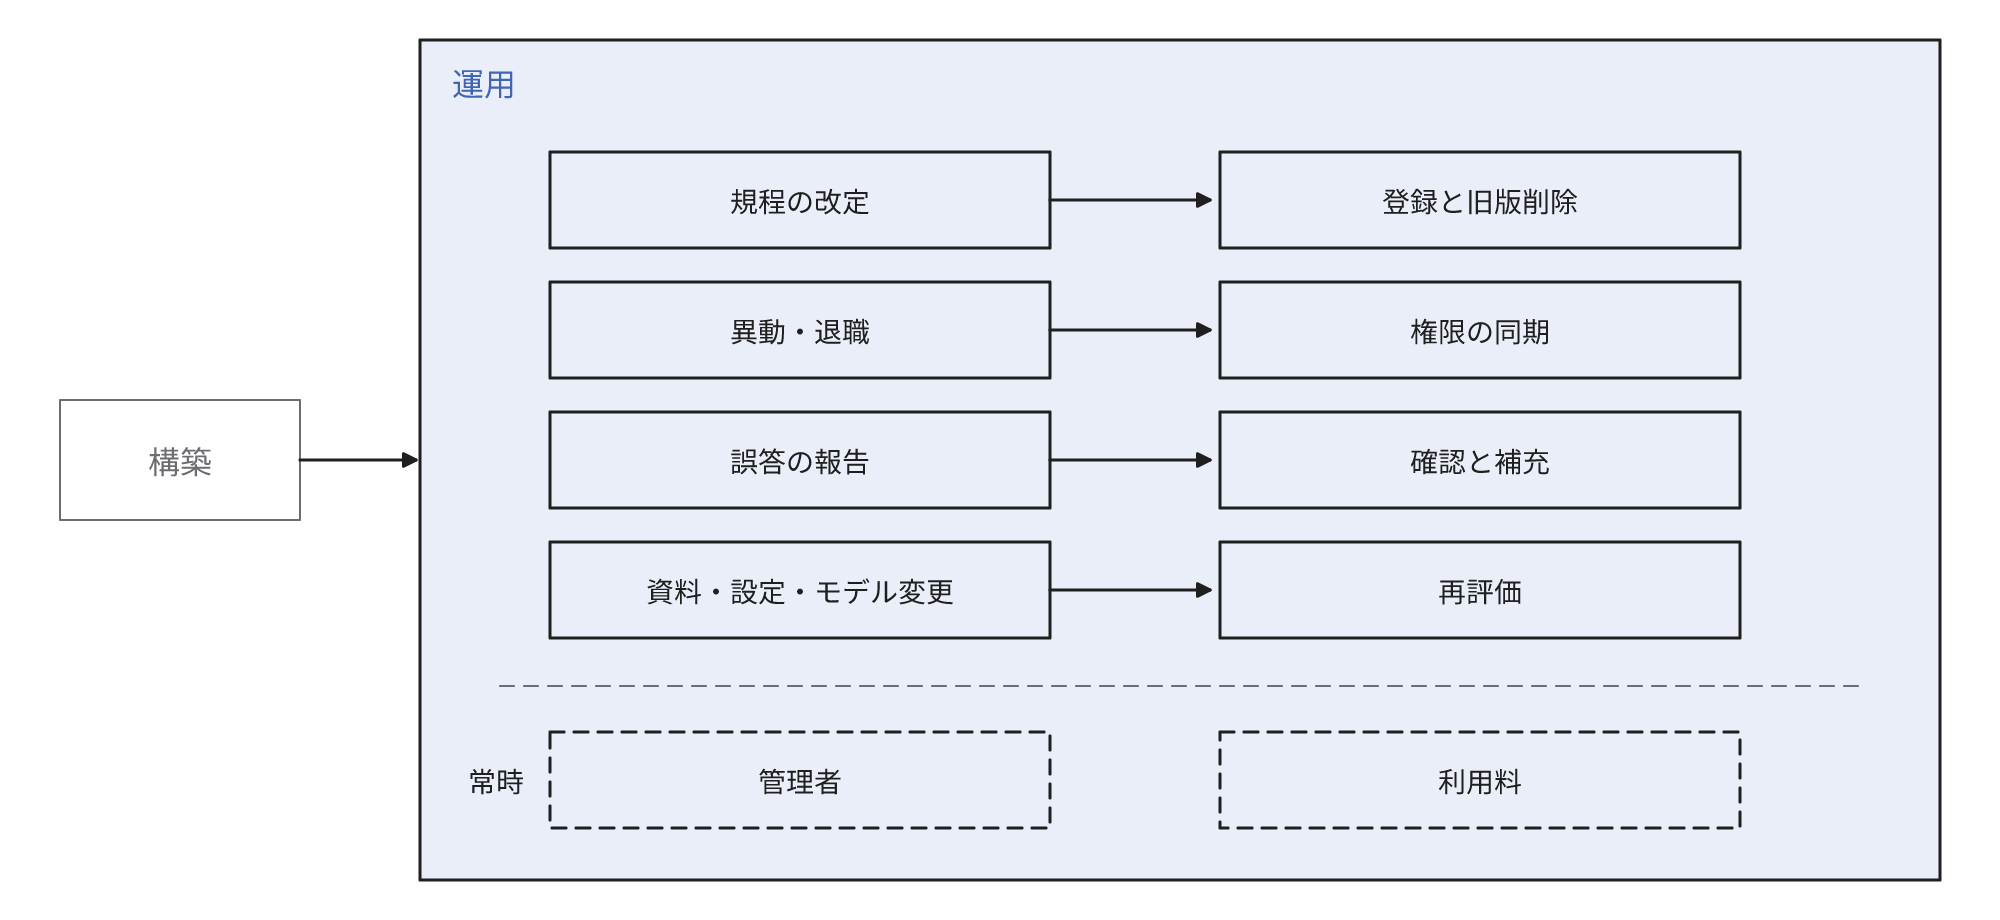
構築費のほか資料の整備と次の運用の費用を見積もります。
- 規程や手順書の改定のたびの資料の登録と旧版の削除
- 部署ごとに資料の正確性を管理する責任者の確保
- 異動や退職、資料の削除を、インデックスと保存した回答にも反映する権限の同期
- 回答できなかった質問と誤答の報告の確認、不足している資料の補充
- 資料、検索の設定、モデルを変更するたびの同じ評価データセットでの再評価
- 生成AIの利用料、文字の抽出とインデックスの作成、検索基盤の費用。料金体系は採用する製品による
RAG・全文の投入・ファインチューニングの使い分け
文書の知識を回答に利用するなら、全文を毎回入力する方法とRAGを比較してどちらかを選択します。ファインチューニングは文書の知識の提供には利用せず、出力の書式や口調を統一したいときに併用します。
| 方法 | 適する条件 | 注意点 |
|---|---|---|
| 全文を毎回入力 | 質問と出力の分を含めてコンテキストウィンドウ以内の資料量で、費用と待ち時間が許容範囲 | 入力量の増加に伴い、料金体系やキャッシュの利用状況によって費用や待ち時間が増加することがある |
| RAG | 資料が多く、必要な部分だけを選択して入力したい | 資料の整備、権限の同期、評価の運用が継続する |
| ファインチューニング | 書式や口調、分類の仕方を一定にしたい | 学習データの準備と再学習が必要 |
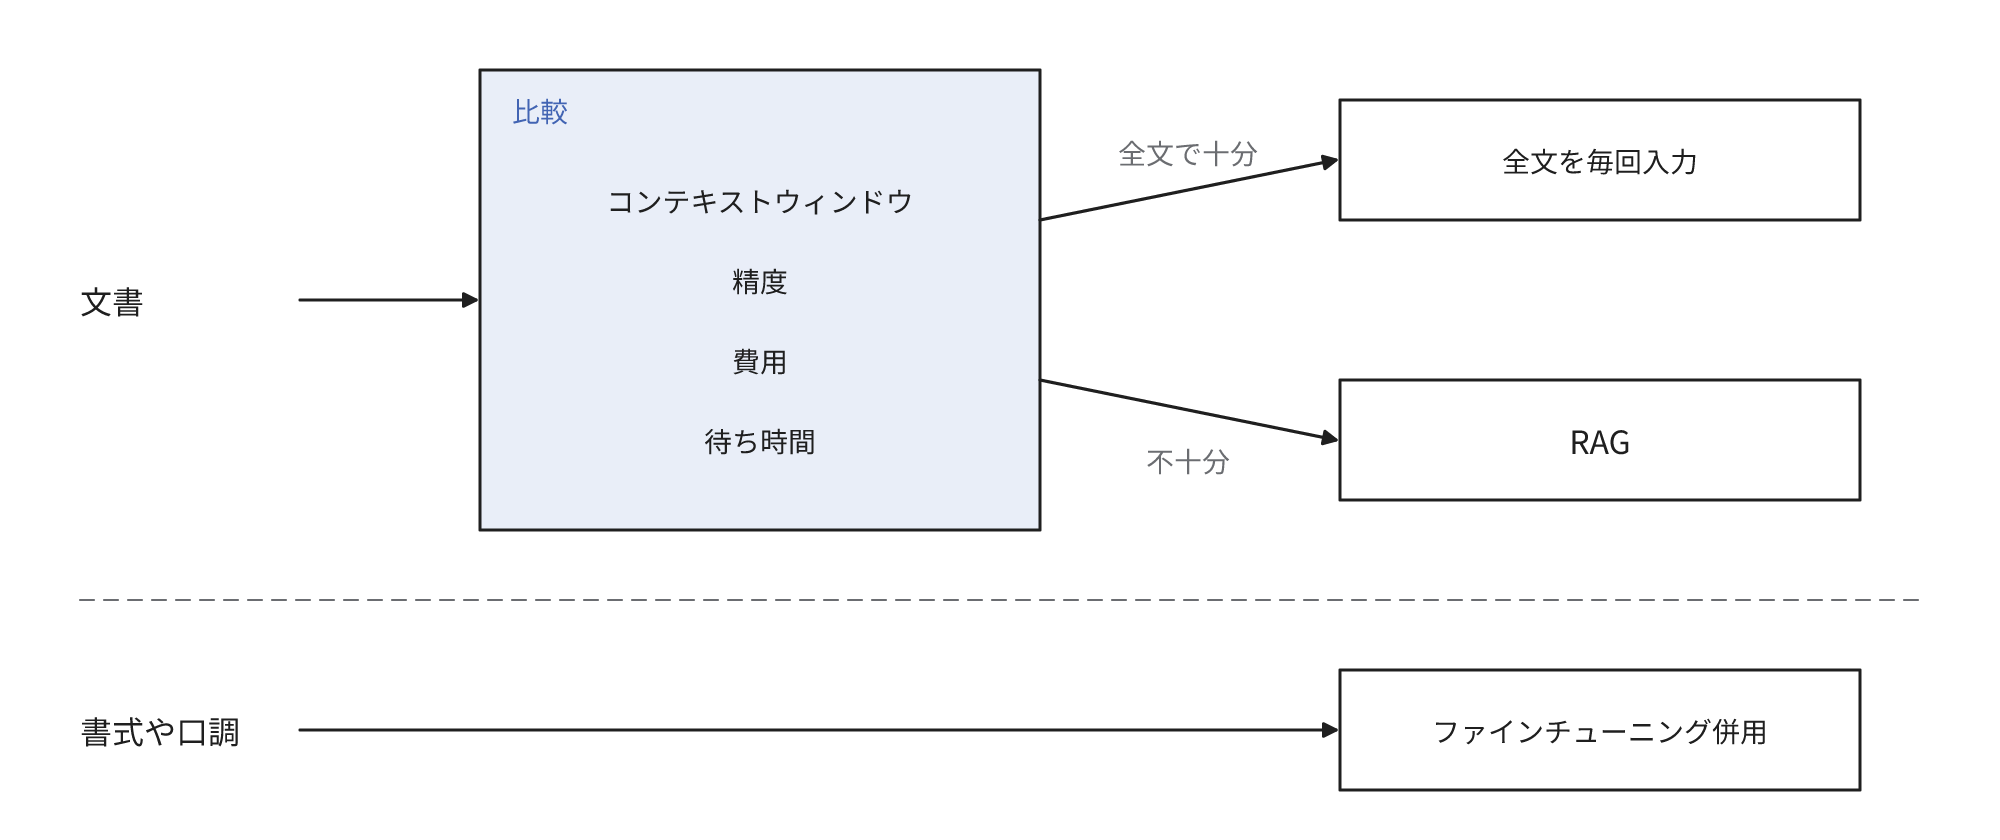
資料が少なければ全文を入力する方法が最も簡単で、繰り返し入力する部分を再利用するプロンプトキャッシュで費用と待ち時間を抑制できる場合もあります。どちらを選択するかはページ数ではなく実際の資料で、コンテキストウィンドウ、回答の精度、費用、待ち時間を比較して決定します。
どちらの方法でも利用者の閲覧権限に応じて、生成AIへ入力する資料を事前に絞り込む必要があります。
ファインチューニングで知識を学習させること自体は可能ですが、頻繁な更新、正確な取り出し、出典の提示、閲覧権限の制御には不向きなため、文書の知識はRAGを優先します。両者は併用もできます。
独自の検索基盤の要否は利用者の数と業務によっても異なります。利用者が少なく、必要な資料をその都度添付すれば対応できる業務なら、独自の検索基盤は不要な場合があります。
構築する場合は全社の資料を一度に登録せず、問合せの多い1部署の規程から開始し、資料の管理者を決定してから対象を拡大するほうが精度を維持しやすいです。
よくある誤解
RAGを導入すれば誤回答はなくなる
無関係な資料が大量に入力されるとモデルが該当する情報ではなく無関係な記述を基に回答することがあり、誤回答の原因になります。参照した資料が旧版であれば改定前の内容に基づいて回答するおそれがあります。参照元を表示し、利用者が原典を確認できる形にしておくことが前提です。
社内の資料をすべて登録すれば回答が正確になる
重複した資料や旧版が検索対象に存在すると検索結果に旧版が含まれ、改定前の内容で回答するおそれがあります。登録は管理者が決定済みで、内容が最新だと確認できた資料から開始します。
お問合せ
事業の課題や技術的な悩みなどどんなことでもお聞かせください