
ハルシネーションとは
生成AIが事実と異なる内容や存在しない出典を、正確な情報と同じ自信のある文体で生成する現象をハルシネーションと呼びます。
生成AIを業務に利用する組織が、どの出力をどこまで確認するかを決定する際の前提になる語です。
実在しない判例や論文の題名、人物の経歴や日付の誤りが実例として報告されています。
参照させた資料にない数字が要約に混入する、資料と逆の内容を記述するといった形でも発生します。
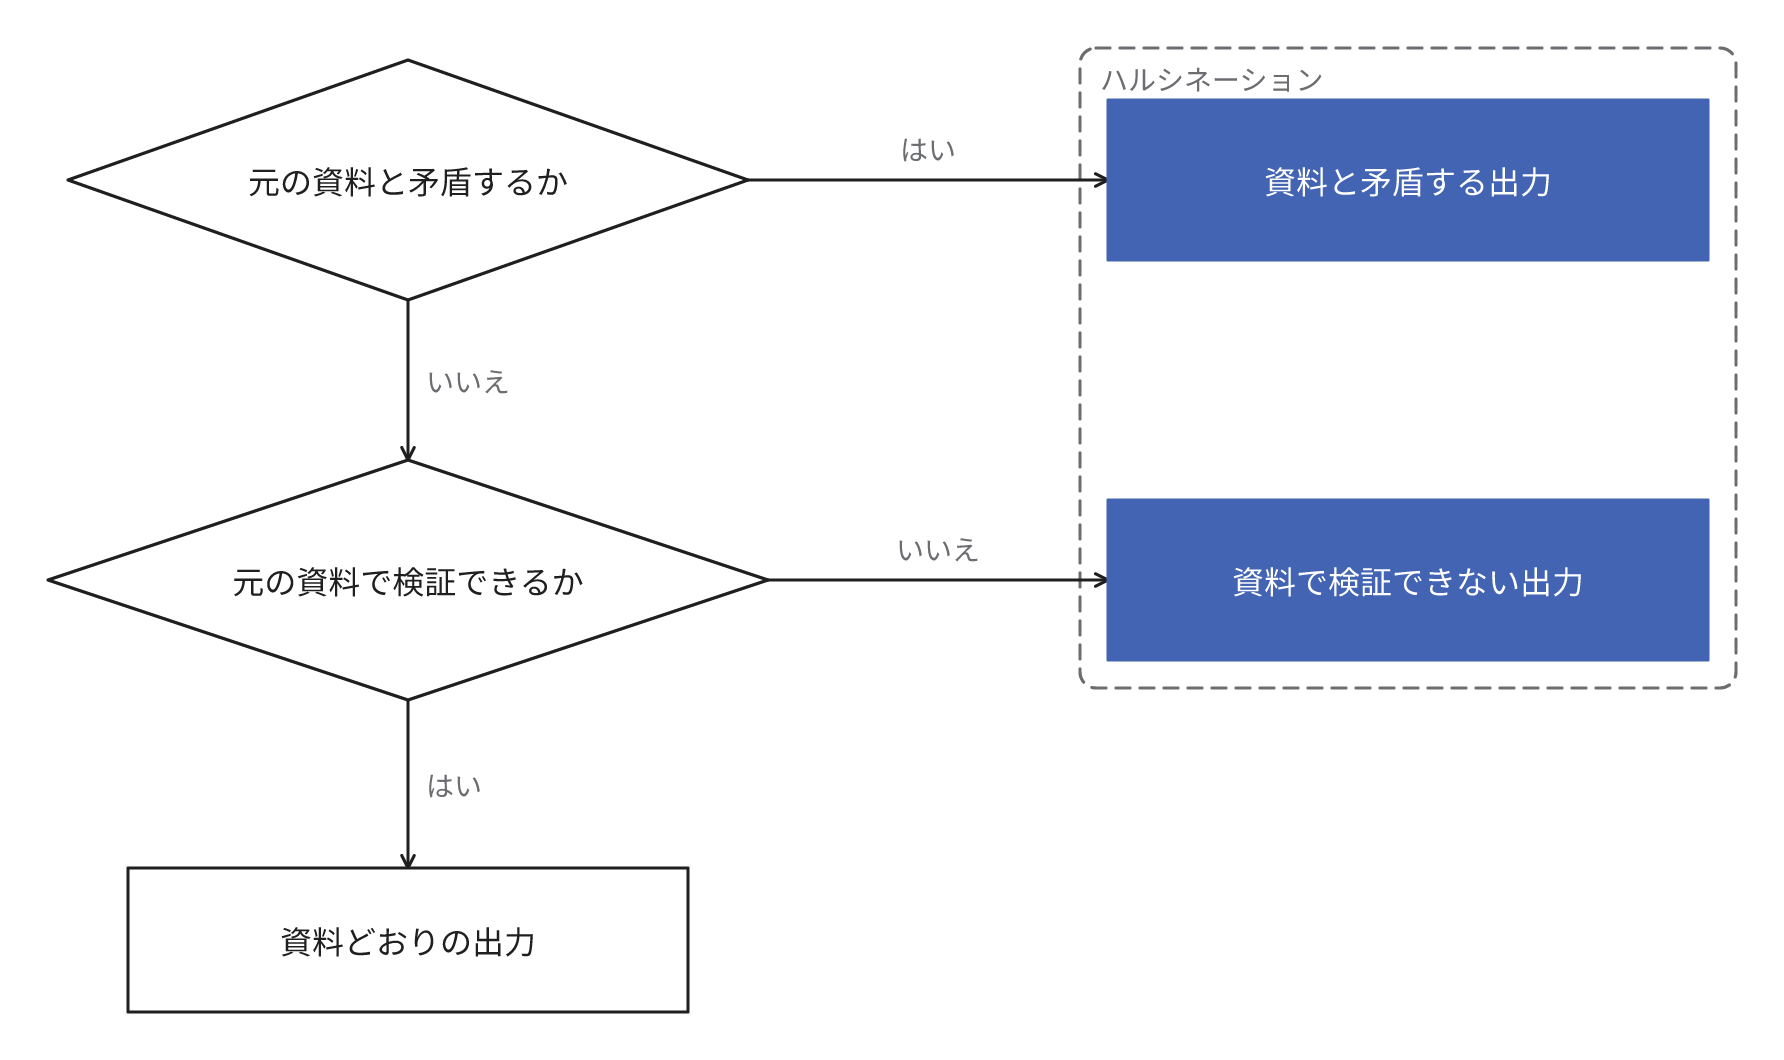
研究では元の資料と矛盾する出力と、元の資料からは検証できない出力の2種類に分類されています。
比喩としては、分からない試験問題を空欄にせず、もっともらしい答えを記入する受験者に近いです。
モデルが学習したデータの最終時点をナレッジカットオフと呼びます。
ナレッジカットオフより後の出来事を把握していないこと自体はハルシネーションではありません。
把握していない情報について、事実と異なる内容をもっともらしく回答すると該当します。
外部の資料などに含まれる命令文によって意図しない動作を誘発するプロンプトインジェクションは、ハルシネーションとは区別される問題です。
結果として事実と異なる出力を生じる場合もあります。
ハルシネーションが発生する理由
LLM(Large Language Model、大規模言語モデル)は、大量の文章から語の並びの傾向を学習したモデルです。
LLMは文章を、語や語の断片にあたるトークンという単位に分割して処理します。
文章の生成で広範に利用されるLLMは、直前までのトークンに後続するトークンを1つずつ予測して文を作成します。
この方式を自己回帰型と呼びます。
予測によって事実と一致する文章を生成できますが、事実性は保証されません。
こうした誤りは生成モデルの設計から生じる自然な結果です。
OpenAIの研究者らによる2025年の論文は、発生が継続する理由として次の2つを分析しています。
- 特定の人物の誕生日のように、学習データに少なく、他の知識から推論する規則性もない事実は、モデルだけでは正答しにくい
- 多くの評価は正答か誤答かだけで採点するため、分からないと回答するより推測で回答するほうの得点が高い
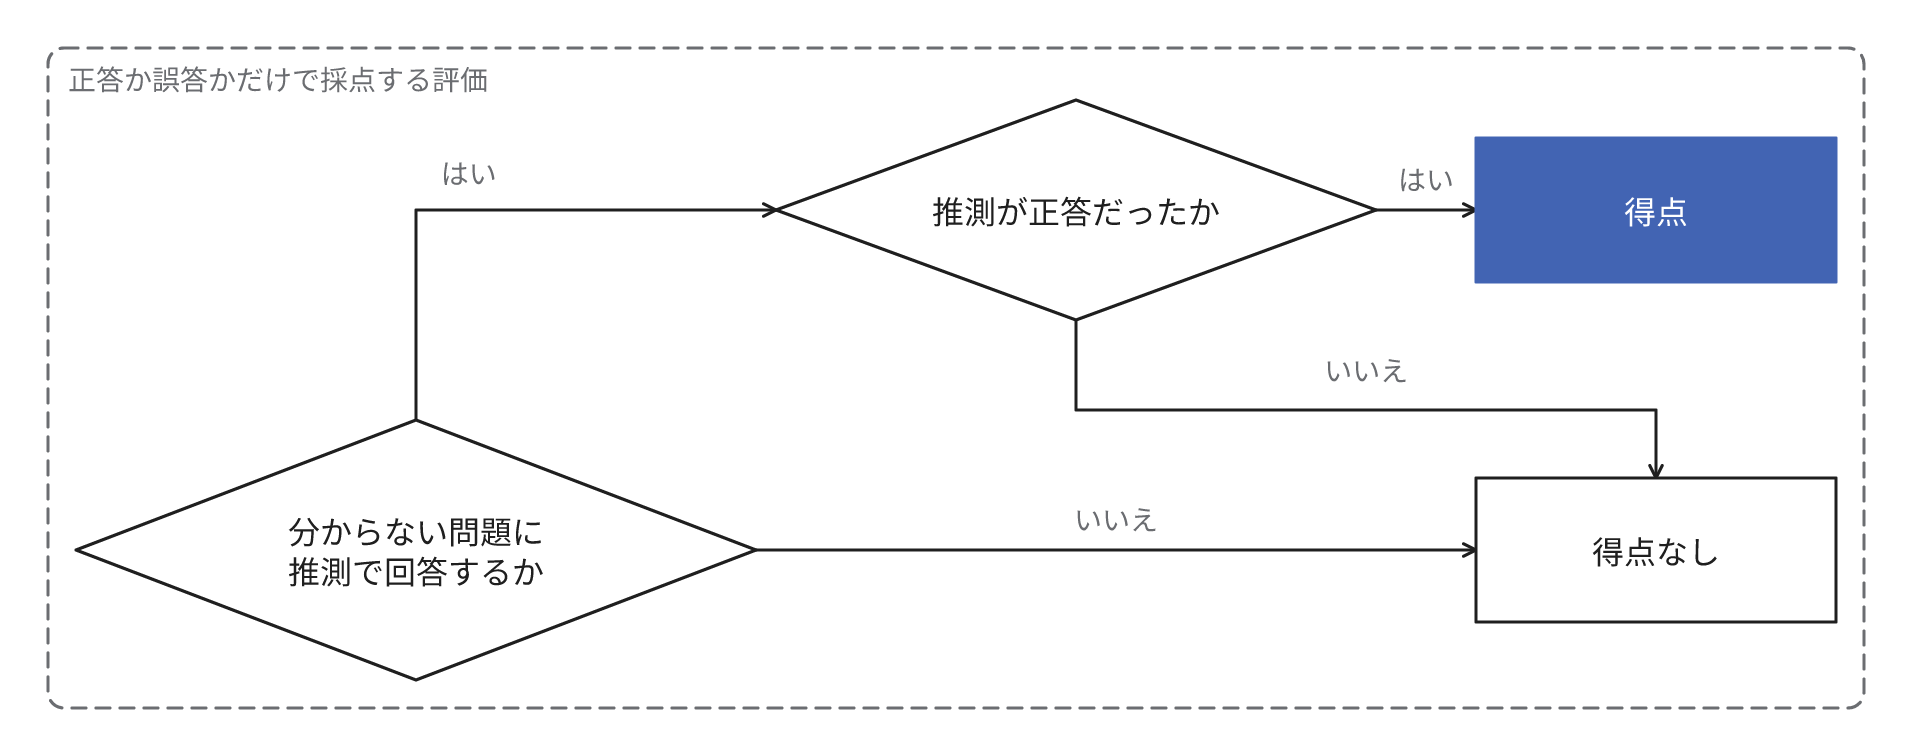
そのためモデルの性能の向上後も、こうした事実をモデルの知識だけで質問する限り、誤りは解消しない可能性があります。
自信のある文体のせいで利用者が誤りを含む内容を信用し、それに基づいて行動することも、生成AIのリスクの1つです。
原典で確認する情報
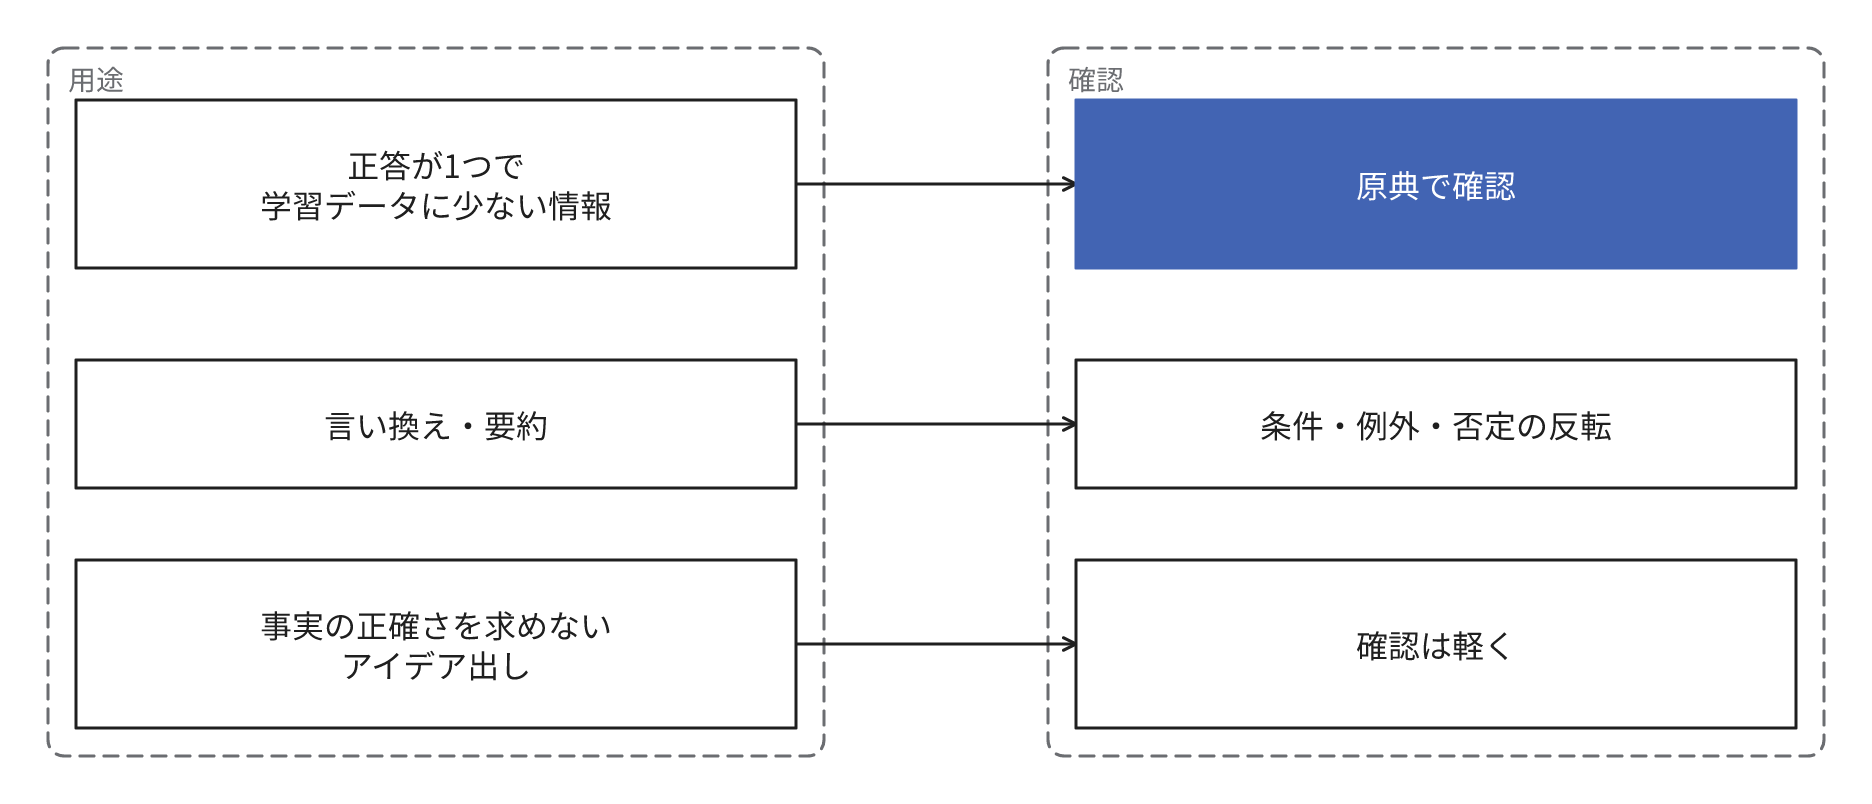
正答が1つに確定し、学習データに少ない情報を質問するときは、原典での確認を優先します。
原典で確認する情報の例は次のとおりです。
- 固有名詞: 取引先の担当者名、中小企業の沿革、製品の型番
- 数字: 売上、日付、法令の条番号、統計値
- 引用と出典: 判例、論文、記事の題名とURL、発言の引用
- 最新情報: 検索や最新の資料を提供せず、学習済みの知識だけで回答させる法改正、価格、人事
- 資料にない質問: 参照させた社内資料では回答できない問合せや規程の解釈
- 長い出力: 長い報告書の要約、複数の資料を統合した回答
既存の文書の言い換えや要約は、条件、例外、否定が反転していないかを確認します。
事実の正確さを求めないアイデア出しでは確認を軽くできます。
誤りを抑制する手段とその限界
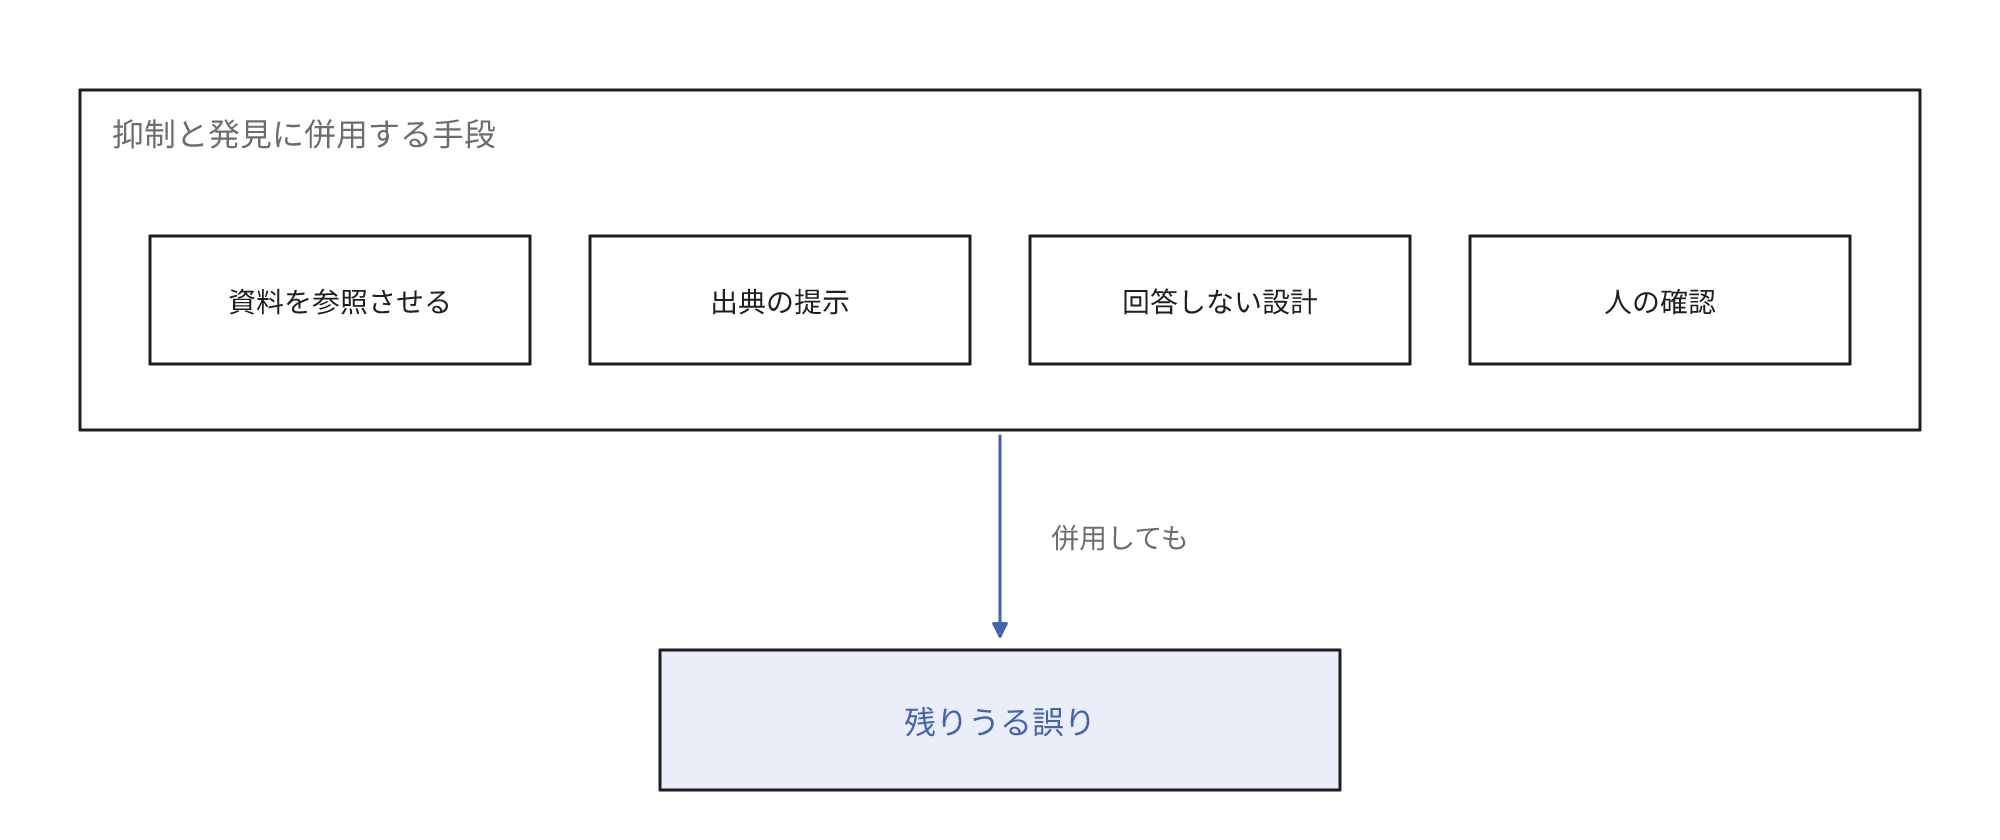
手段を併用すると頻度を低減し誤りを発見しやすくできることがありますが、汎用の用途で誤りがないことは保証できません。
Anthropicの公式ドキュメントも、分からない場合に分からないと回答させることや、回答に引用で出典を示させることなどを、誤りを抑制する手段として紹介しています。
| 手段 | 内容 | 限界 |
|---|---|---|
| 資料を参照させる | 社内規程や製品資料を提供し、資料の範囲だけで回答させる | 資料の誤りや更新前の情報が回答に引き継がれることがある |
| 出典の提示 | 回答の各記述に、裏付けとなる資料の該当箇所を明示させる | 出典そのものの作話。出典の資料を参照して内容を確認する工数 |
| 回答しない設計 | 資料に答えがない場合は分からないと回答させ、担当者へ引き継ぐ | 回答できる割合の低下。引き継ぎ先の窓口が必要 |
| 人の確認 | 公開、送付、決裁の前に人が原典で確認する | 件数に比例する工数。形式的な承認では誤りが通過 |
資料を検索して選択し、生成AIへ提供する仕組みはRAG(Retrieval-Augmented Generation、検索拡張生成)と呼ばれます。
RAGはAI事業者ガイドライン第1.1版でも、ハルシネーションの抑制が期待される手段として記載されています。
ただしRAGを利用する法律調査サービスを評価したスタンフォード大学の研究者らによる2024年の調査では、比較対象としたGPT-4よりハルシネーションは少ないものの、誤りがないという提供者の説明は誇張だと結論しています。
確認の重さを誤りの影響で決定する
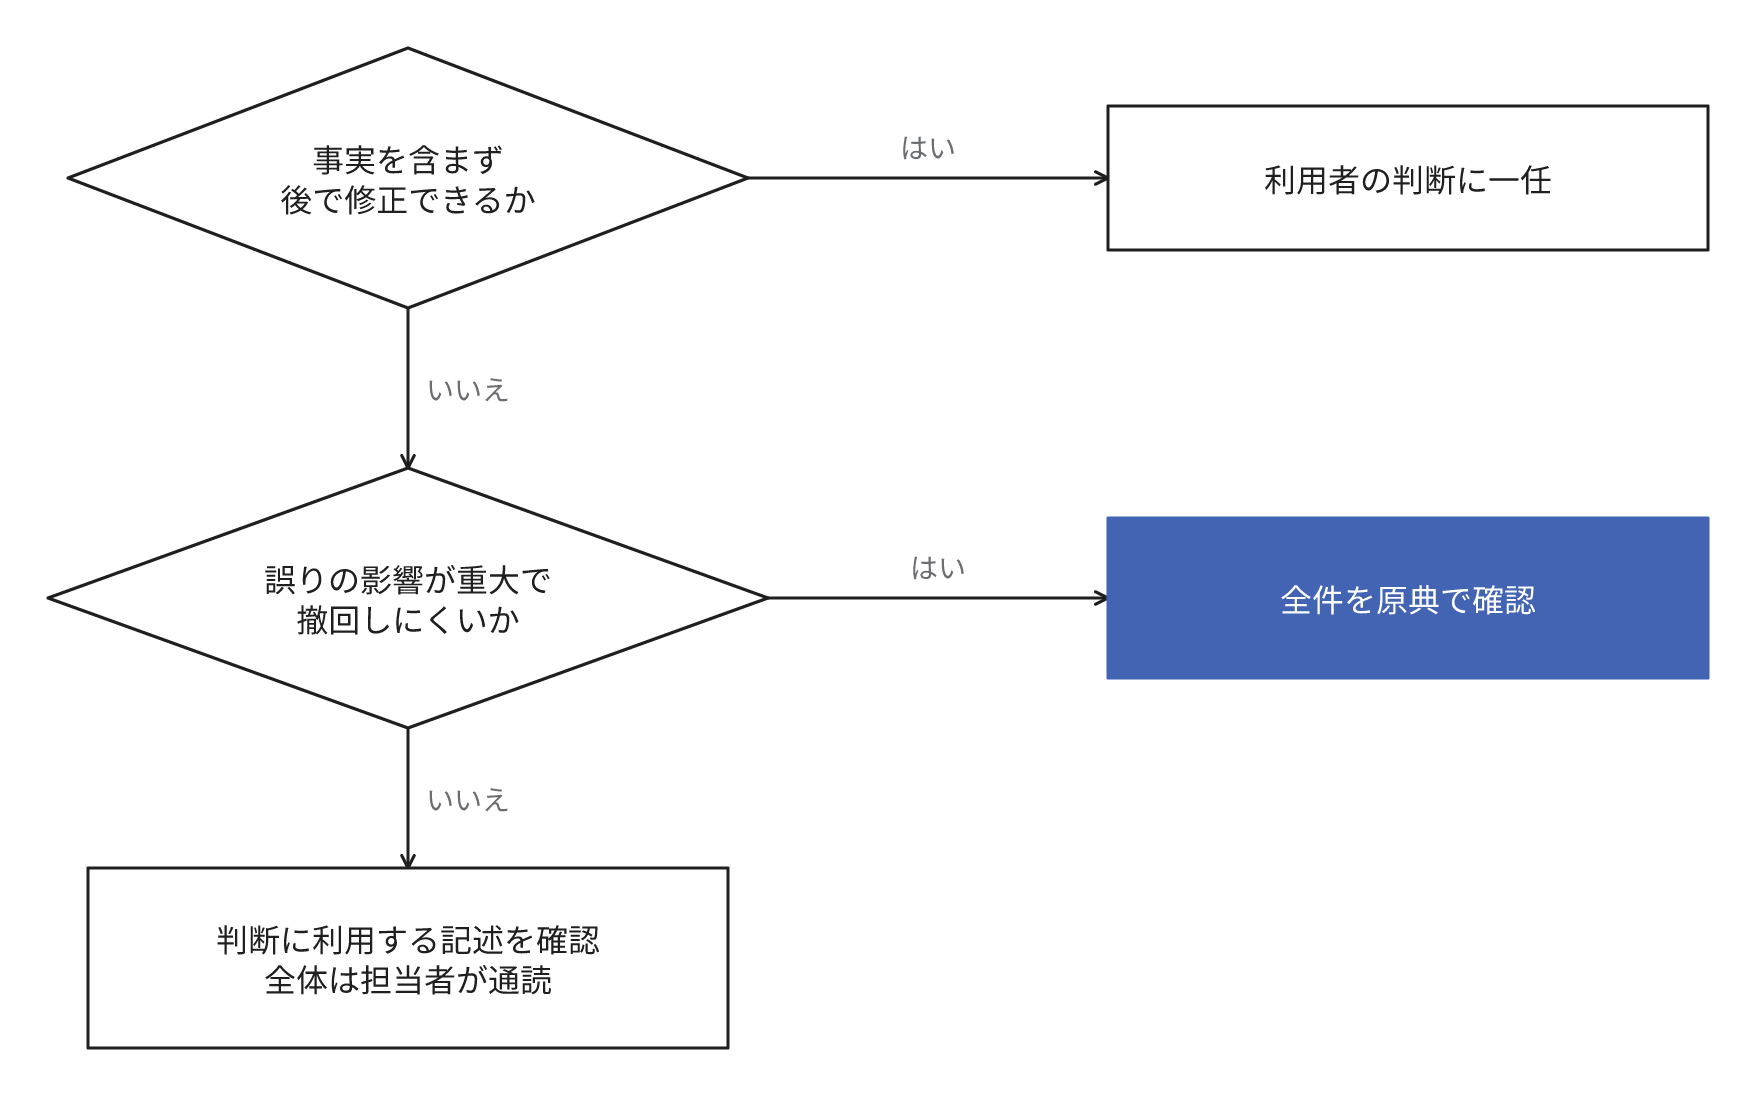
確認の重さは社内向けか社外向けかではなく、誤りの影響、発見のしやすさ、撤回できるかで決定します。
影響が重大かは金額、権利、安全、人の評価や処遇に関係するかで判定します。
| 区分 | 例 | 確認の重さ |
|---|---|---|
| 影響が重大で、誤りを撤回しにくい | 顧客への回答、契約書の条項、投資や与信の判断材料、人事情報の要約 | 全件。数字と固有名詞のほか、結論と条件、例外、否定が原典と一致するかを確認 |
| 影響は限定的だが、判断に利用する | 会議資料の要約、市場調査のまとめ | 判断に利用する記述を原典で確認し、文章全体は担当者が通読 |
| 事実を含まず、後で修正できる | アイデア出し、構成案の叩き台 | 利用者の判断に一任 |
全件や判断に利用する記述を原典で確認するときは、日付、適用範囲、一次資料かどうかも確認します。
原典同士が矛盾する場合は発行日が後の資料や発行元の資料を正とする規則を定めておきます。
導入の可否は確認にかかる工数も含めて決定します。
月間件数と1件で削減できる作業時間の積を、確認、利用料、構築、保守の費用と比較します。
たとえば1件3分の確認を1日200件行うと、確認だけで1日10時間になります。
速度や対応できる時間帯の拡大といった効果も含めて比較し、確認の工数が削減分を上回るなら、その業務は生成AIに担当させないほうが安価です。
自動化されたシステムへの過度の依存は、AI事業者ガイドライン第1.1版でも注意すべき現象として記載されています。
確認者が原典を参照せずにAIの出力を承認するだけの作業になると、確認したつもりで誤りを看過します。
原典で確認する対象を手順書に具体的に記載しておくほうが、承認だけの作業になりにくいです。
誤りが発生したときの責任と運用
法的な責任の判断は法域や契約によって異なりますが、AIの出力であることを理由に利用前の確認を省略しないほうが安全です。
2023年、米国の弁護士らがChatGPTで作成した書面に実在しない判例を引用して裁判所に提出し、存在を疑問視された後も主張を維持したため、裁判所は制裁金5,000ドルを科しました。
裁判所は信頼できるAIツールを補助として利用すること自体は不適切ではないものの、提出書面の正確性を確保する役割は弁護士にあると指摘しています。
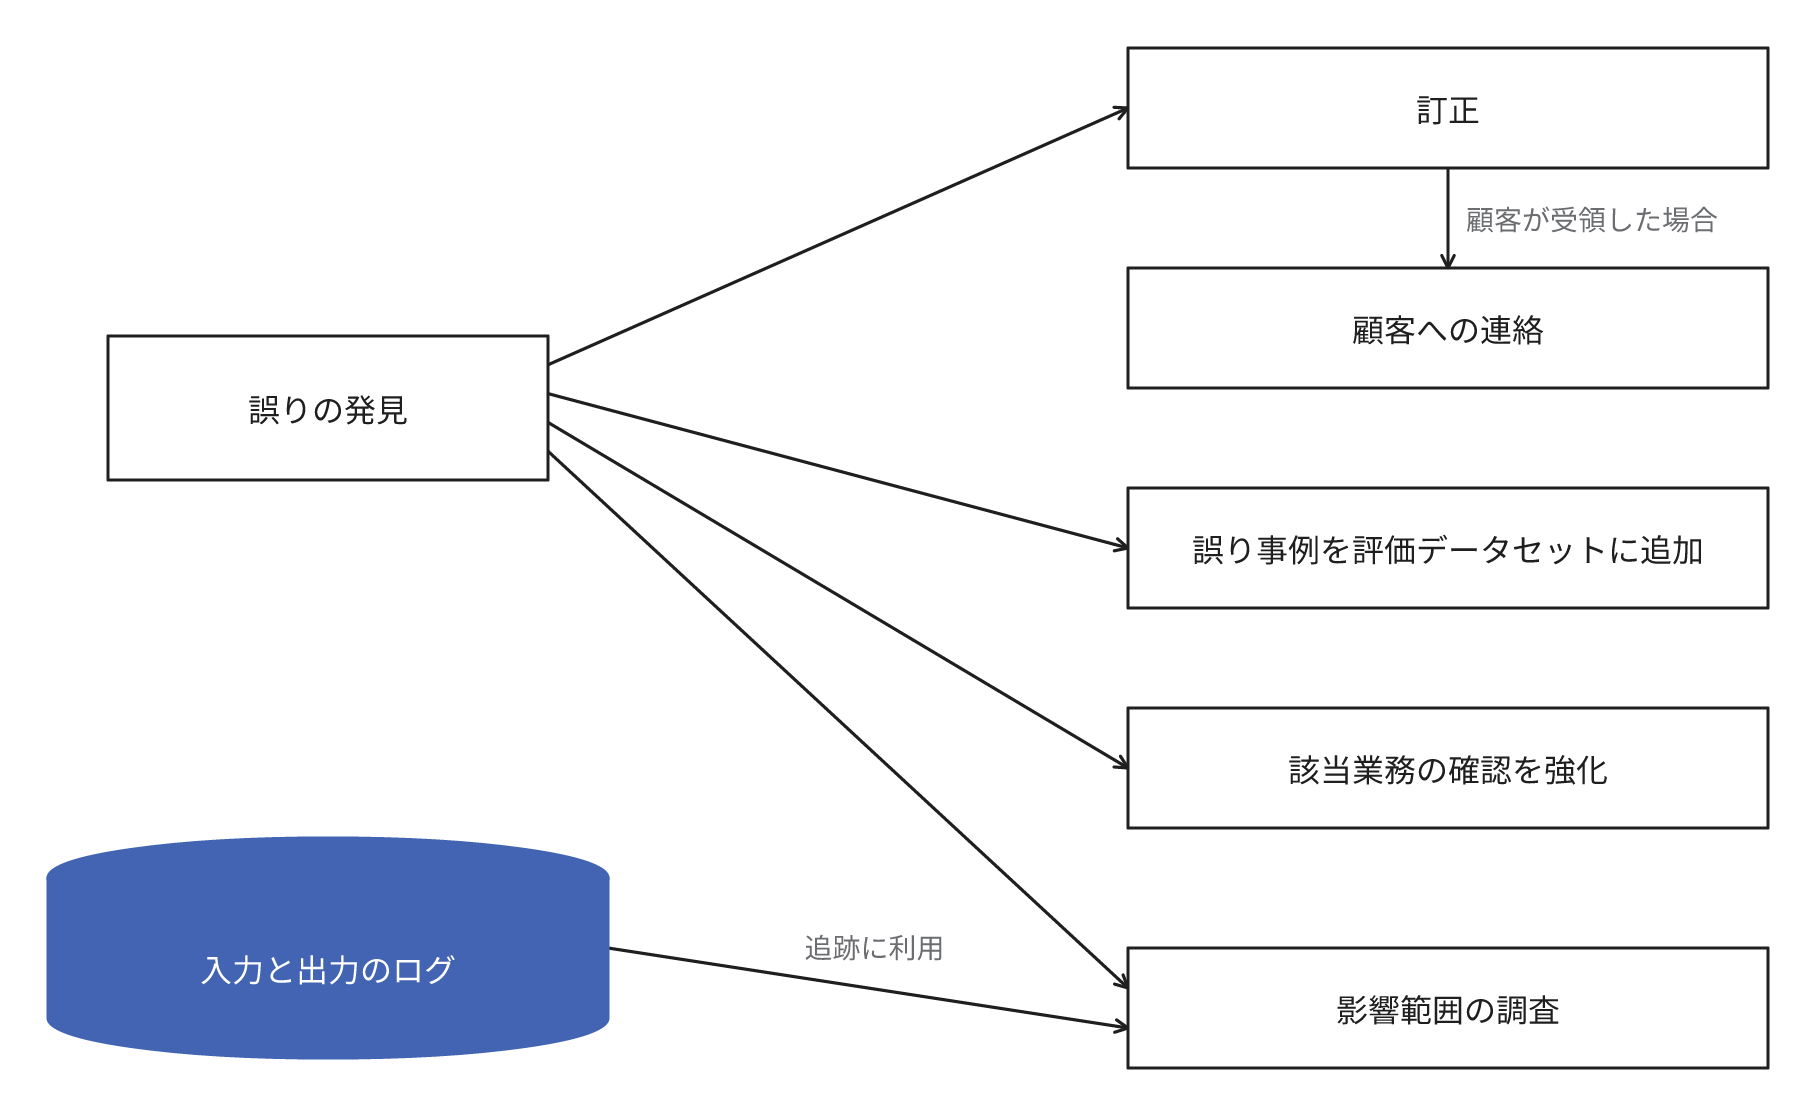
誤りが発生したときの運用は導入前に次を定めておきます。
- 入力と出力のログ。どの資料を参照し、誰が確認したかを後から追跡できる状態
- 訂正の手順。顧客が誤りを含む回答を受領した場合の連絡、訂正文の承認者、提供を停止する判断者
- 影響範囲の調査。同じ誤りを含む既出の回答と、関連する業務への波及の確認
- 誤り事例の蓄積。発生した誤りを、回答の正確さを測定する評価データセットに追加し、モデルや資料の更新時に再検証
- 確認の再設定。誤りが発見された業務は区分を1段重い確認へ移行
よくある誤解
生成AIに真偽を再質問すれば確認できる
再質問しても確認にはなりません。
架空の判例を提出した米国の弁護士らは、ChatGPTに判例が実在するかを質問し、実在するという回答を得ていました。
誤りを指摘すると認めることもありますが、訂正後の回答が正確である保証もありません。
確認は生成AI以外の原典で行います。
誤りを出力しないようプロンプトで指示すれば防止できる
誤りを避けるようプロンプトで指示するだけでは、モデルに不足する知識を補完できません。
Anthropicの公式ドキュメントが推奨するのは、分からない場合に分からないと回答してよいと明示し、回答を提供した資料の範囲に限定するプロンプトです。
こうしたプロンプトで頻度を低減できる場合でも、確認の工程は省略できません。
お問合せ
事業の課題や技術的な悩みなどどんなことでもお聞かせください