
生成AIとは
AI(Artificial Intelligence)のうち、指示に応じて文章や画像、音声やプログラムなどを作成するものを生成AIと呼びます。
文章の下書き、画像の生成、議事録の要約が代表例です。
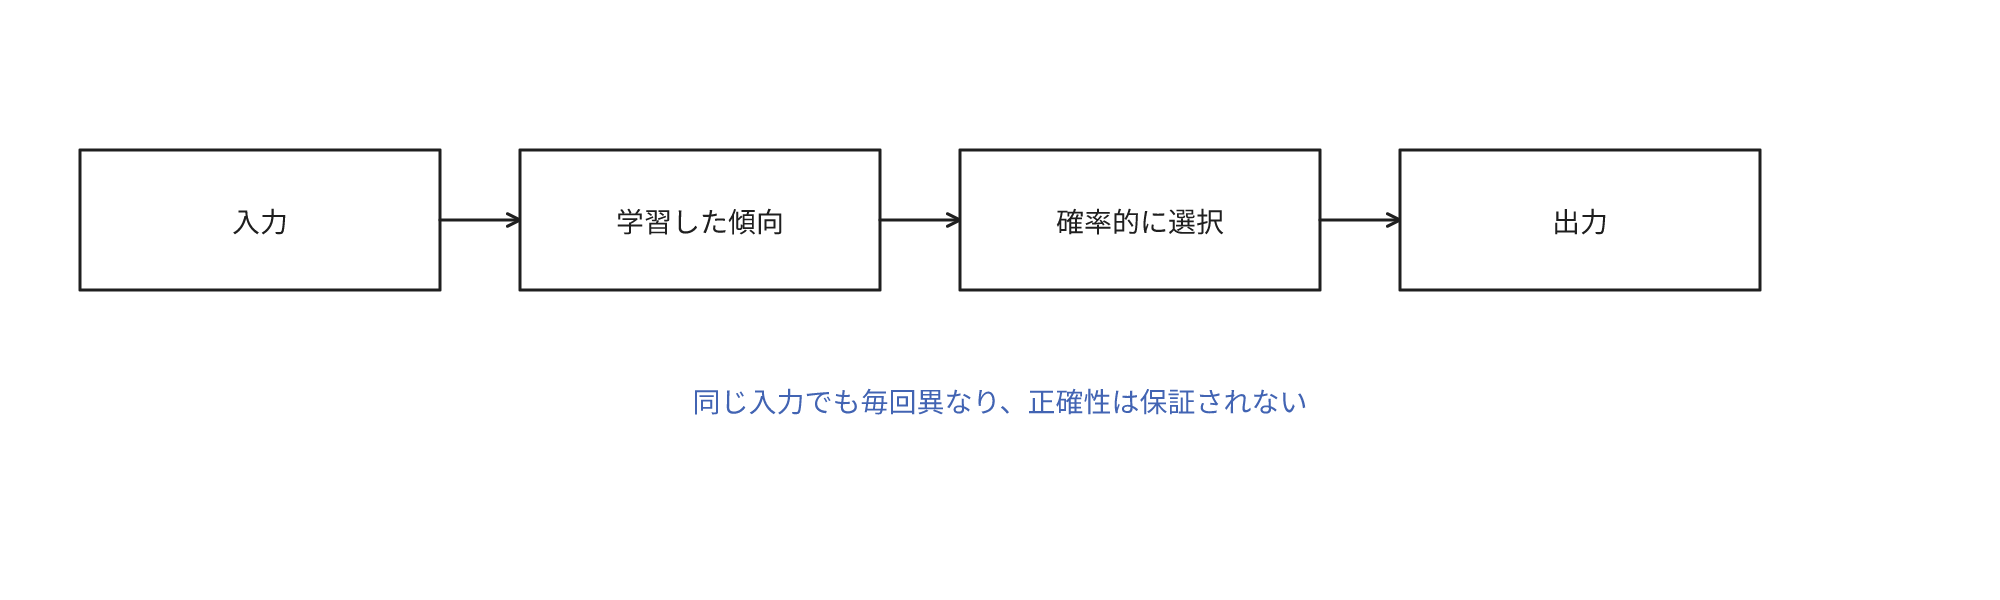
指示を入力すると学習した語や画素の並びの傾向から次のものを確率的に選択します。
検索は既存の答えを取得するのに対し、生成AIは学習した傾向から出力を生成します。
出力の性質は3つです。
- 同じ指示でも毎回異なる文になること
- 内容の正確さが保証されないこと
- 固有名詞や数字に誤りがあっても、自信ありげな文体が維持されること
自社の資料を検索し、その内容を回答へ含めるRAG(Retrieval-Augmented Generation)という使い方もあります。
外部の資料を参照せず、学習したデータだけを基に回答する点では、博識な人に近いです。
その人も学習していない分野の質問には回答できないのと同じく、自社固有の情報は回答に含まれません。
含めるには資料を提供するか人が補完します。
生成AIに担当させる仕事と担当させない仕事
議事録や提案書、社内の案内文、問合せへの返信は、これまで人が白紙から作成するか、費用と納期をかけて外注していました。
人数と作業時間が制約になり、繁忙期に停滞します。
生成AIを利用すると白紙から記述する作業が出力文の修正に変化します。
対話型の生成AIは多くの人が活用しやすい手段です。
適する仕事
量が多く、多少の誤りは許容でき、あとから確認できる仕事が適合します。
- 録音や走り書きから議事録の下書きを作成する
- 長い報告書や仕様書の要点を抽出する
- アンケートの自由回答を分類し、傾向が異なる意見を抽出する
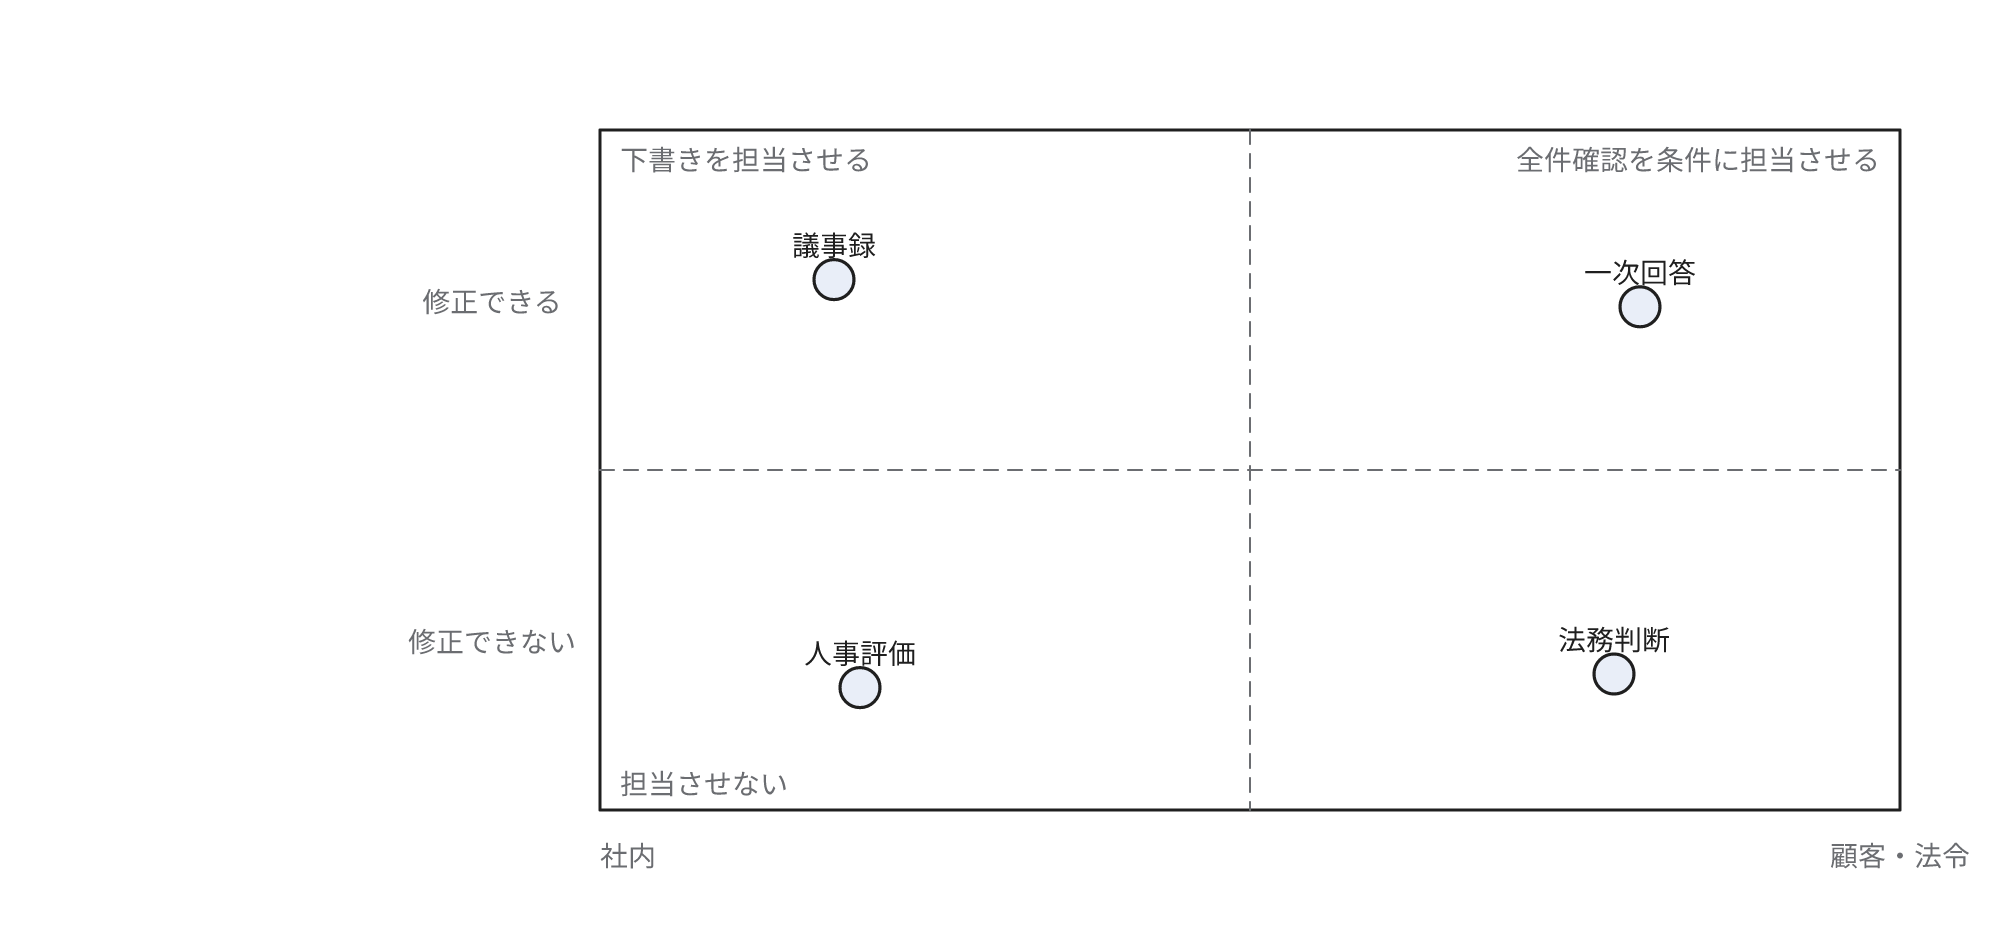
- 問合せの一次回答を作成し、担当者が確認してから送付する
担当させない仕事
誤りが業務の停止や法令違反に直結する仕事と、責任の所在を明確にする必要がある判断は担当させられません。
- 法務、税務、医療、与信の判断など、正確性が最優先される業務
- 稟議の決裁、人事評価、価格の設定など、誰が決定したかを説明する必要がある判断
- 為替、在庫、法令の施行状況など、その時点で値が正確かどうかを必ず確認する必要がある業務
- 人事情報や顧客の個人情報、まだ公開していない設計、契約条件など、外部に公開できない情報が伴うような業務
判断は誤りの影響範囲と検知できるかの2軸です。
数字の誤りが請求書に記載される場合や、案内の誤りが顧客に到達する場合は担当させません。
誤りを検知して修正できる工程が後ろにあるなら、下書きとして担当させられます。
効果と契約後のコストとリスク
効果
効果は初稿の時間短縮と確認前提の生産量の増加です。
- 初稿までの時間が短くなり、検討そのものに時間を充当できる
- 長文の要点把握が迅速になり、閲覧量の多い部署の負担が減少する
- 定型的な問合せの一次回答を用意でき、窓口の待ち時間を削減できる
- 言い換えと整形の下書きを作成できるが、体裁は統一されず、類似した言い回しが増加する
費用
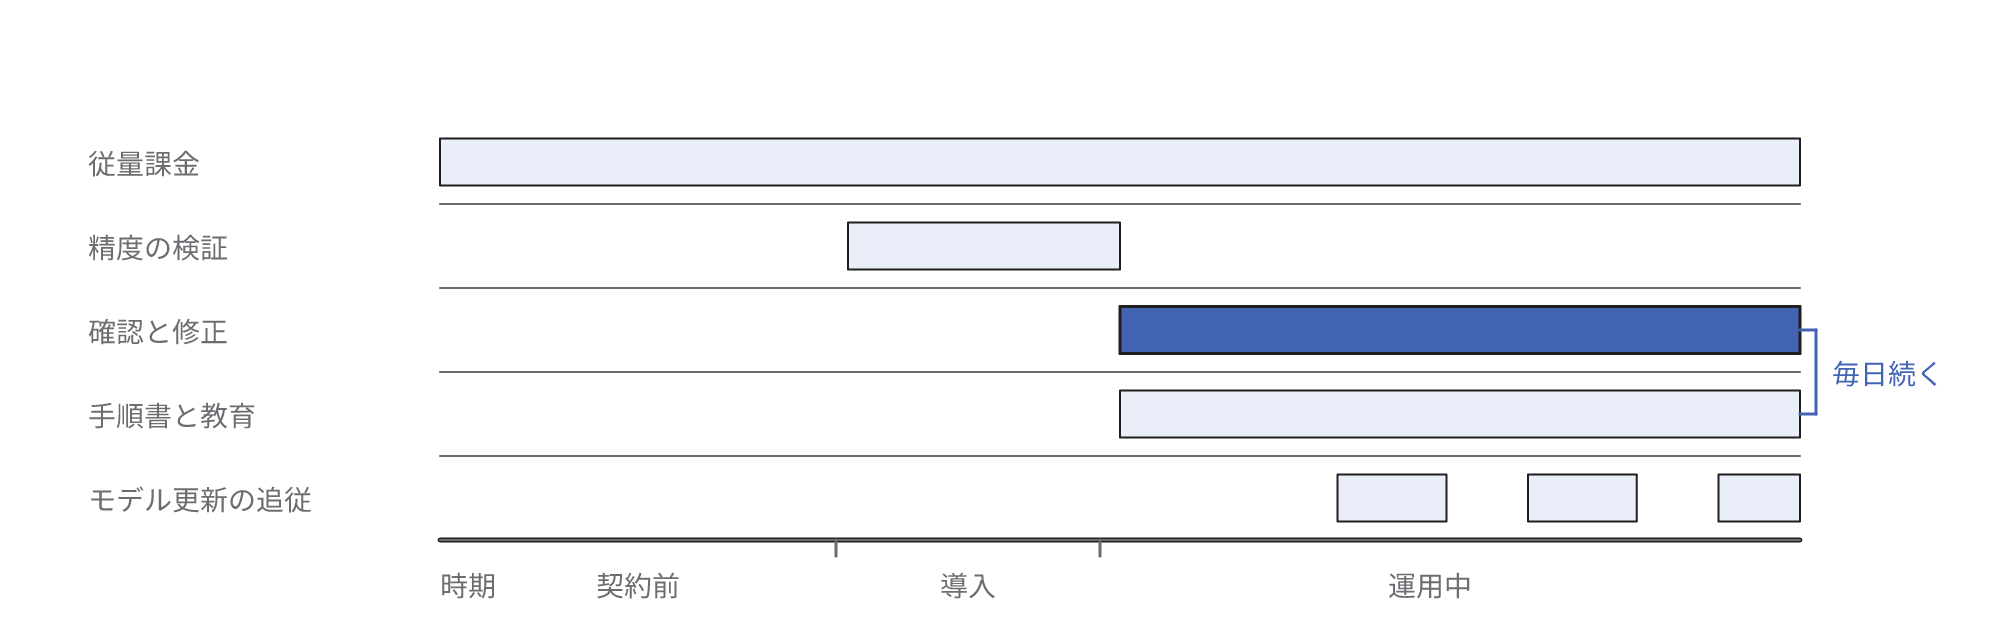
費用は契約前に把握できない運用が大半です。
- 利用量に応じた従量課金。人数に比例する分は見積もりやすく、1人あたり月3,000円から4,000円の製品を100人が利用すると、月30万円から40万円が目安になる
- 精度の検証にかかる人件費。業務ごとに数十件から数百件の正解データを用意し、出力と比較する
- 確認工程の人件費。人が目視して修正する時間が毎日発生する
- 手順書の維持と教育。入力してよい情報と確認の順序を文書にし、担当者を定めて改訂し続ける
- モデル更新への追従。モデルが更新されるたびに再検証が必要になる
リスク
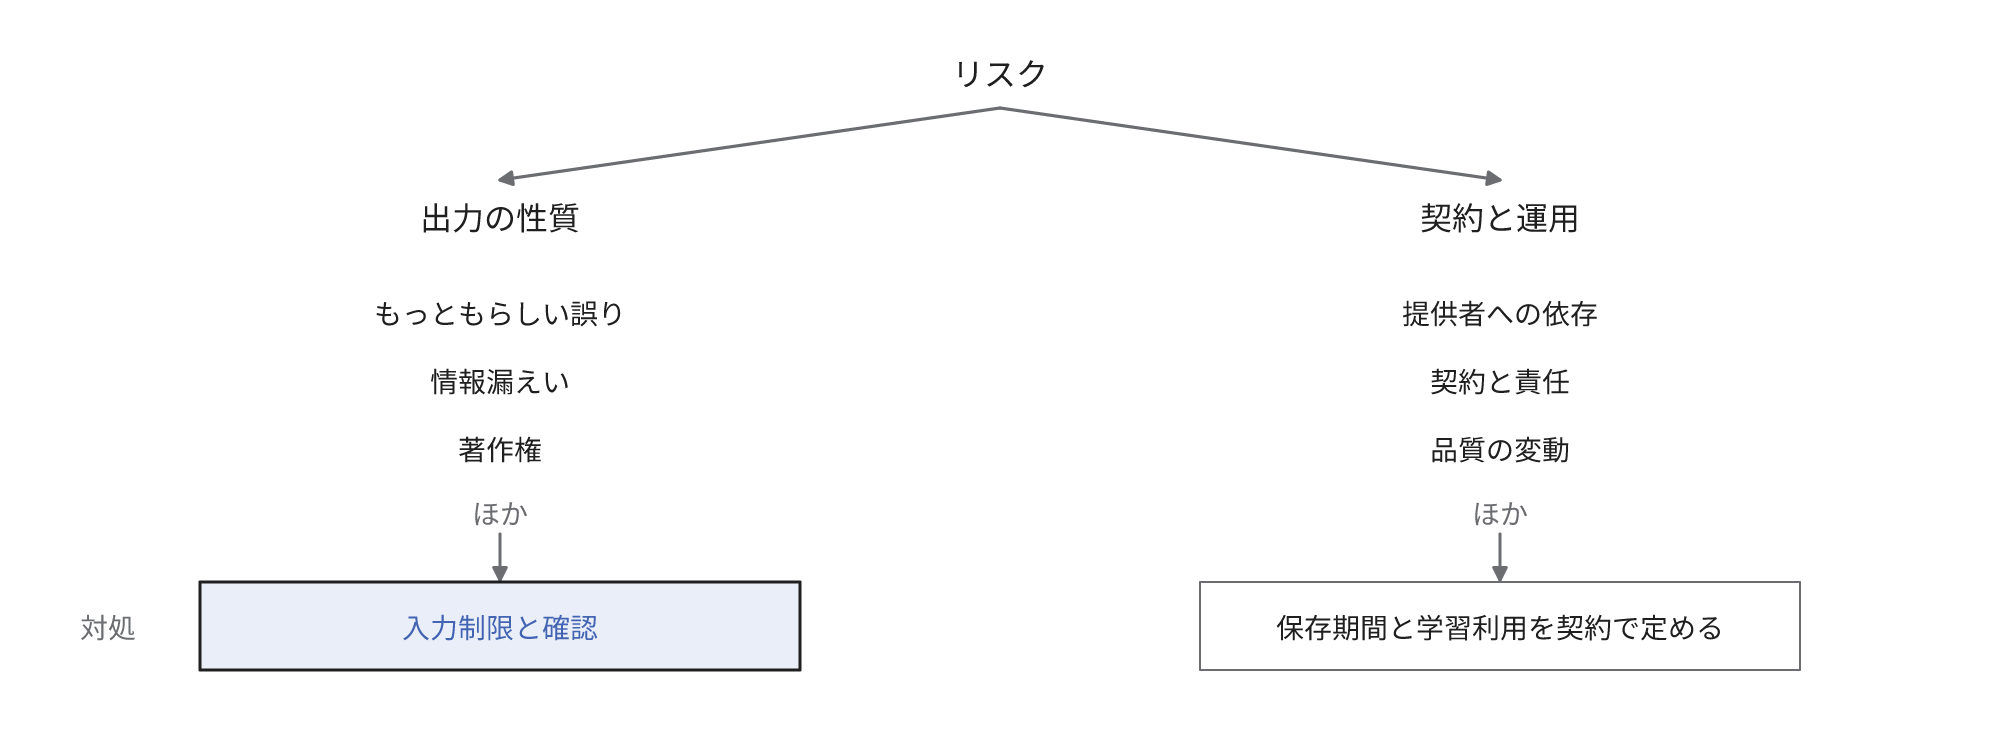
リスクは出力の性質と契約・運用の2つから生じます。
- もっともらしい誤り。自信ありげだが内容に誤りがある生成は、生成AIのリスクの1つである
- 機密情報と個人情報の入力。漏えいや目的外利用によるデータプライバシーのリスクがある
- 著作権。生成物が既存の著作物と創作的表現が共通し、それに依拠して作成したと認められ、権利制限規定の対象外であるなら、侵害になり得る
- 提供者への依存。仕様や料金、保存期間、学習への利用条件などは提供者が決定するため、自社だけでは変更できない
- 契約と責任。損害賠償と補償の範囲、出力の権利帰属、解約時のデータ削除を確認し、漏えいが生じたときの報告と停止の手順も定める
- 外部の資料を参照させる使い方。資料に含まれる間接的な指示を、モデルが指示として処理することがある
- 出力品質の変動。開発者には品質の記録と検証が、提供者には品質が変動し得ることの事前説明が求められる
導入する業務を決定する
生成AIの導入では担当範囲をどこまで拡大するかを定めます。
同じ文書を毎週作成し直す、問合せの一次回答が定型、大量の文章から要点を抽出する、いずれも対象です。
法令違反や人事評価に直結する判断、責任の所在を説明する必要がある業務は対象外です。
検証の終了条件
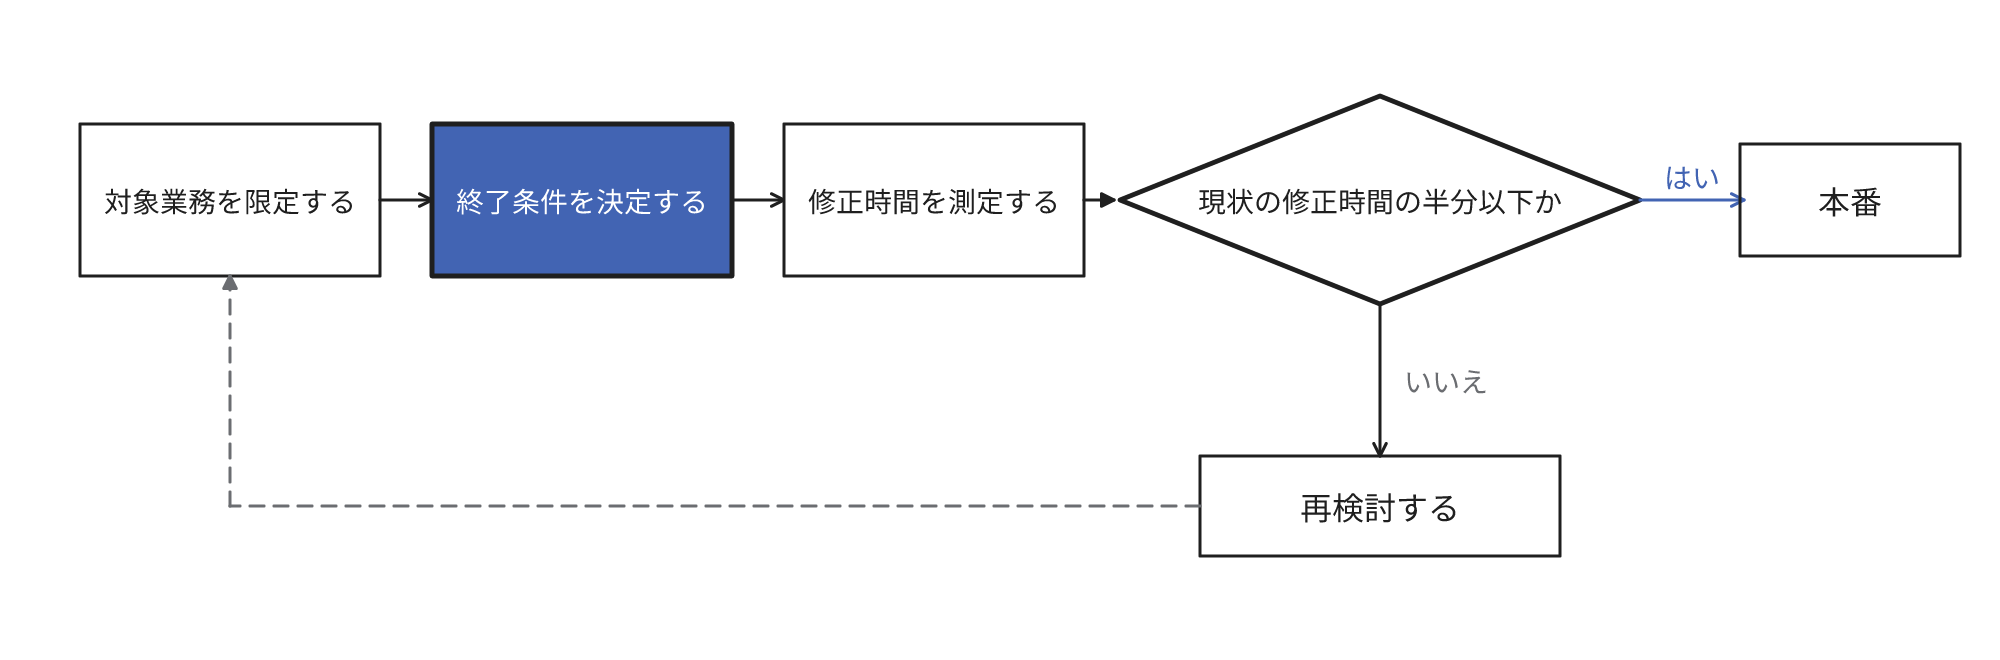
検証の終了条件を開始前に定めます。
業務を1つに限定し、例外と顧客種別を網羅する数十件から数百件を用意し、同じ入力100件で修正時間を測定し、現状の半分以下を目安に本番へ移行します。
定めずに開始すると検証そのものが目的になり、効果の判定が先延ばしになります。
確認工程の位置づけ
人が確認する工程を業務の流れに位置づけます。
その工程の維持はリスクに応じて事業者が決定する事項です。
顧客に提出する文書、金額、法令や契約に関する内容は全件を人が確認し、社内の下書きと要約はリスクの高い文書から順に確認します。
社内利用と顧客向けの基準
社内利用と顧客向けの基準は異なります。
社内の下書きは誤りが社内で完結します。
顧客向けは誤りがそのまま顧客に提示され、信用と法令の責任に直結します。
顧客向けに利用するなら生成物であることの開示も含め、確認する人と訂正の手順を定めてから開始します。
入力できる情報の制限
入力できる情報はあらかじめ定め、顧客の個人情報や人事情報、まだ公開していない契約条件、認証情報は入力対象から除きます。
学習に利用しない設定があるかどうか、保存期間を契約で確認します。
著作権の望ましい方策は次の4点です。
- 利用規約の確認
- 従業員への著作権教育
- 社内ルールの策定
- 著作権侵害が生じた場合の対応の事前の想定
生成AIを要しない仕事
定型の伝票や請求書の転記、集計、既存システムの画面操作は、生成AIではなく既存の自動化で迅速かつ安価に完了します。
数行の社内連絡も人の手で作成するほうが迅速です。
下書きの作成、要点の抽出、分類という3つは担当させ、判断と対外説明は人が担当します。
よくある誤解
モデルを変更すれば精度が向上する
上位モデルへ移行すればベンチマーク上の平均的な性能は向上する傾向があります。
ただし向上するのは学習したデータの傾向に対する精度です。
自社の業務の例外や言い回しは学習しません。
仕組み上、もっともらしい誤りは残存し、自動化されたシステムへの過度の信頼はリスクとして指摘されています。
モデルを変更するたびに同じ入力で出力を比較し、確認の工程を再設計します。
生成AIが作成した文章の著作権は自分にある
生成AIが作成した文章の著作権が自分にあるとは限りません。
創作的寄与がない生成物は著作物に該当しません。
簡単な指示も同様で、作成の手段として利用したと認められれば著作物になり得ますが、指示の具体性が問題になります。
社内ルールを定めれば情報は保護される
ルールの整備は必要ですが、それだけでは保護されません。
利用できる手段がないまま禁止すると、顧客の個人情報を含む問合せを私的なアカウントに貼り付けて下書きを作成する、といった運用が生じやすくなります。
入力してよい情報と確認する人を最初に定め、契約と設定で対象を限定し、業務で利用できる環境を用意するほうが実効性は高いです。
お問合せ
事業の課題や技術的な悩みなどどんなことでもお聞かせください