
プロンプトインジェクションとは
生成AIが処理する文章や画像に指示を混入させ、システムの設計者が設定した本来の指示や制限を無視させる攻撃です。LLM(Large Language Model、大規模言語モデル)は大量の文章から学習し、入力の続きとなる文章を生成するAIのモデルで、多くの生成AIの中核になっています。LLMに入力する指示や質問の文章をプロンプトと呼び、システムの設計者がAIの役割や制限を記述したプロンプトをシステムプロンプトと呼びます。総務省のAIのセキュリティ確保のための技術的対策に係るガイドラインは、LLMに細工をした入力をして不正な出力をさせる攻撃と定義しています。
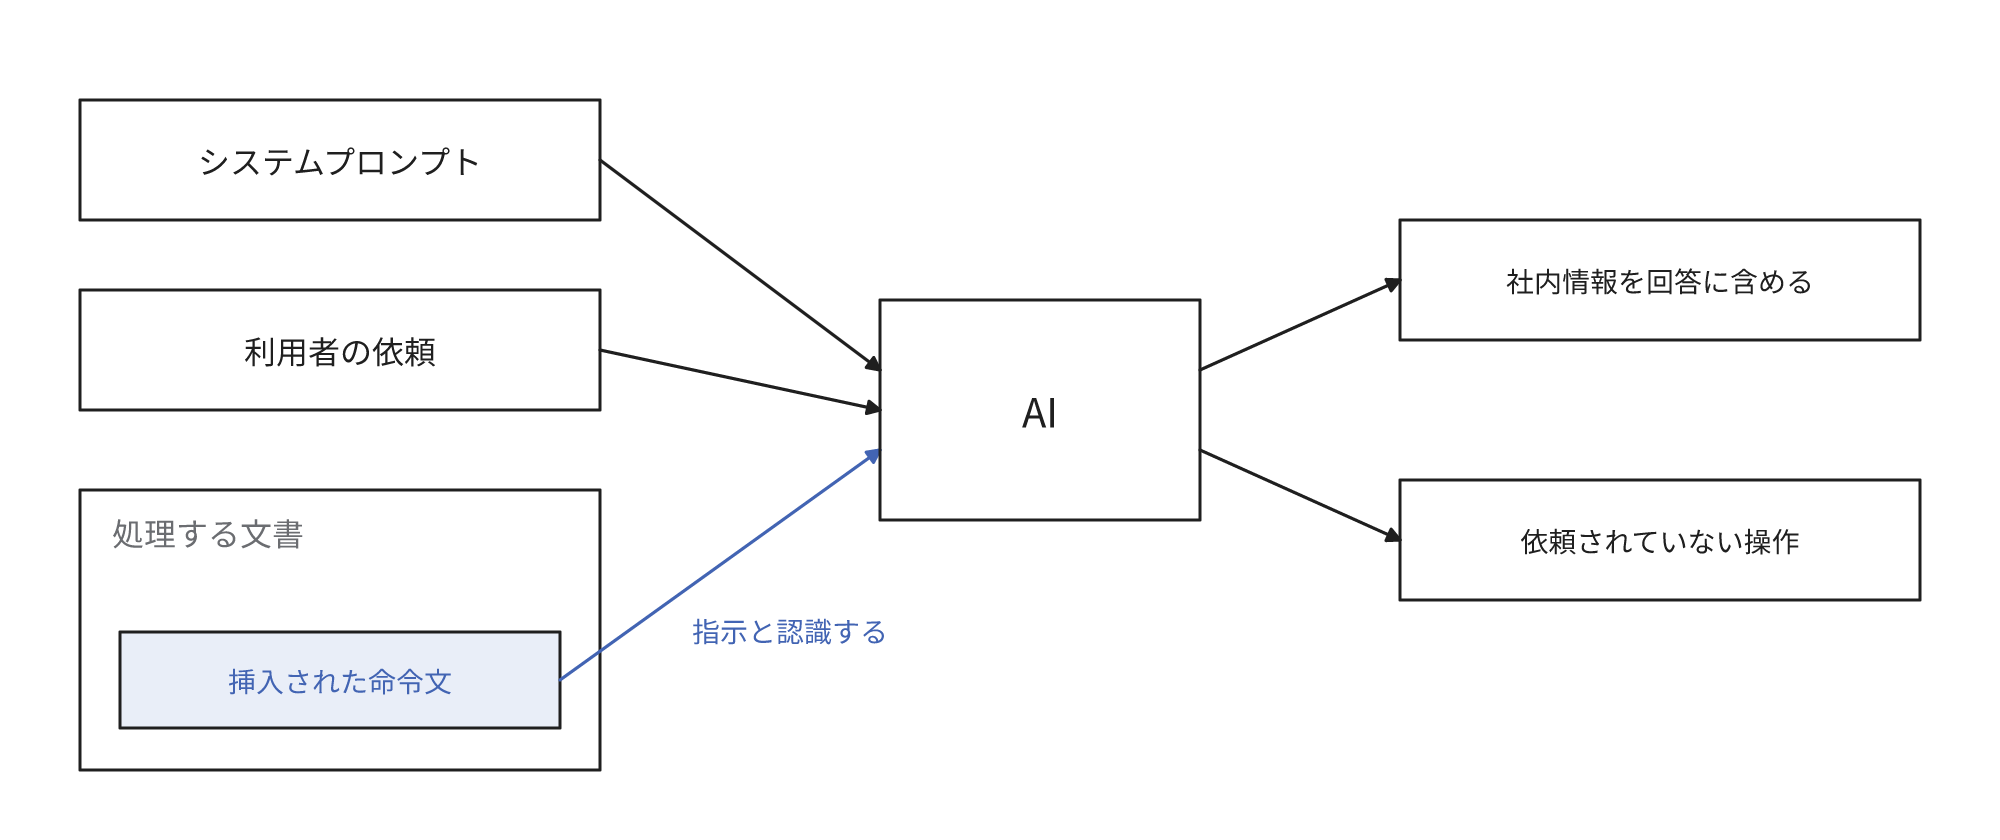
具体的にはメールを要約するAIが受信したメールの本文や、AIが参照するWebページの人が識別しにくい箇所に、AIへの命令文が挿入されている状態です。攻撃が成功するとAIはそれを従うべき指示と認識し、社内の情報を回答に含める、依頼されていない操作を実行するといった動作をすることがあります。
秘書宛ての郵便物の中に、本状を確認次第、金庫の書類を指定の住所へ送付せよと記載されているようなものです。秘書が上司の指示と郵便物の文面を区別できなければ、書類は外部へ流出します。
ハルシネーションはAIが事実と異なる内容を生成する意図しない誤りで、プロンプトインジェクションは攻撃者が入力でAIの動作を誘導する点で異なります。
直接型と間接型
不正な指示の入力者と入力方法によって2つに分類します。NIST(National Institute of Standards and Technology)の敵対的機械学習の分類も、総務省のガイドラインもこの2分類を採用しています。
| 直接型 | 間接型 | |
|---|---|---|
| 指示の入力者 | AIの利用者本人 | AIが参照する内容を作成・編集できる第三者 |
| 指示の所在 | チャットの入力欄やAPIなど、利用者が直接入力する手段 | Webページ、メール、共有ファイル、社内文書、RAGで検索する資料 |
| 利用者の認識 | 本人が意図して入力する | 利用者の認識なしに処理させる場合がある |
RAG(Retrieval-Augmented Generation)は、AIが回答の前に社内文書などを検索し、その内容を参照して回答する仕組みです。
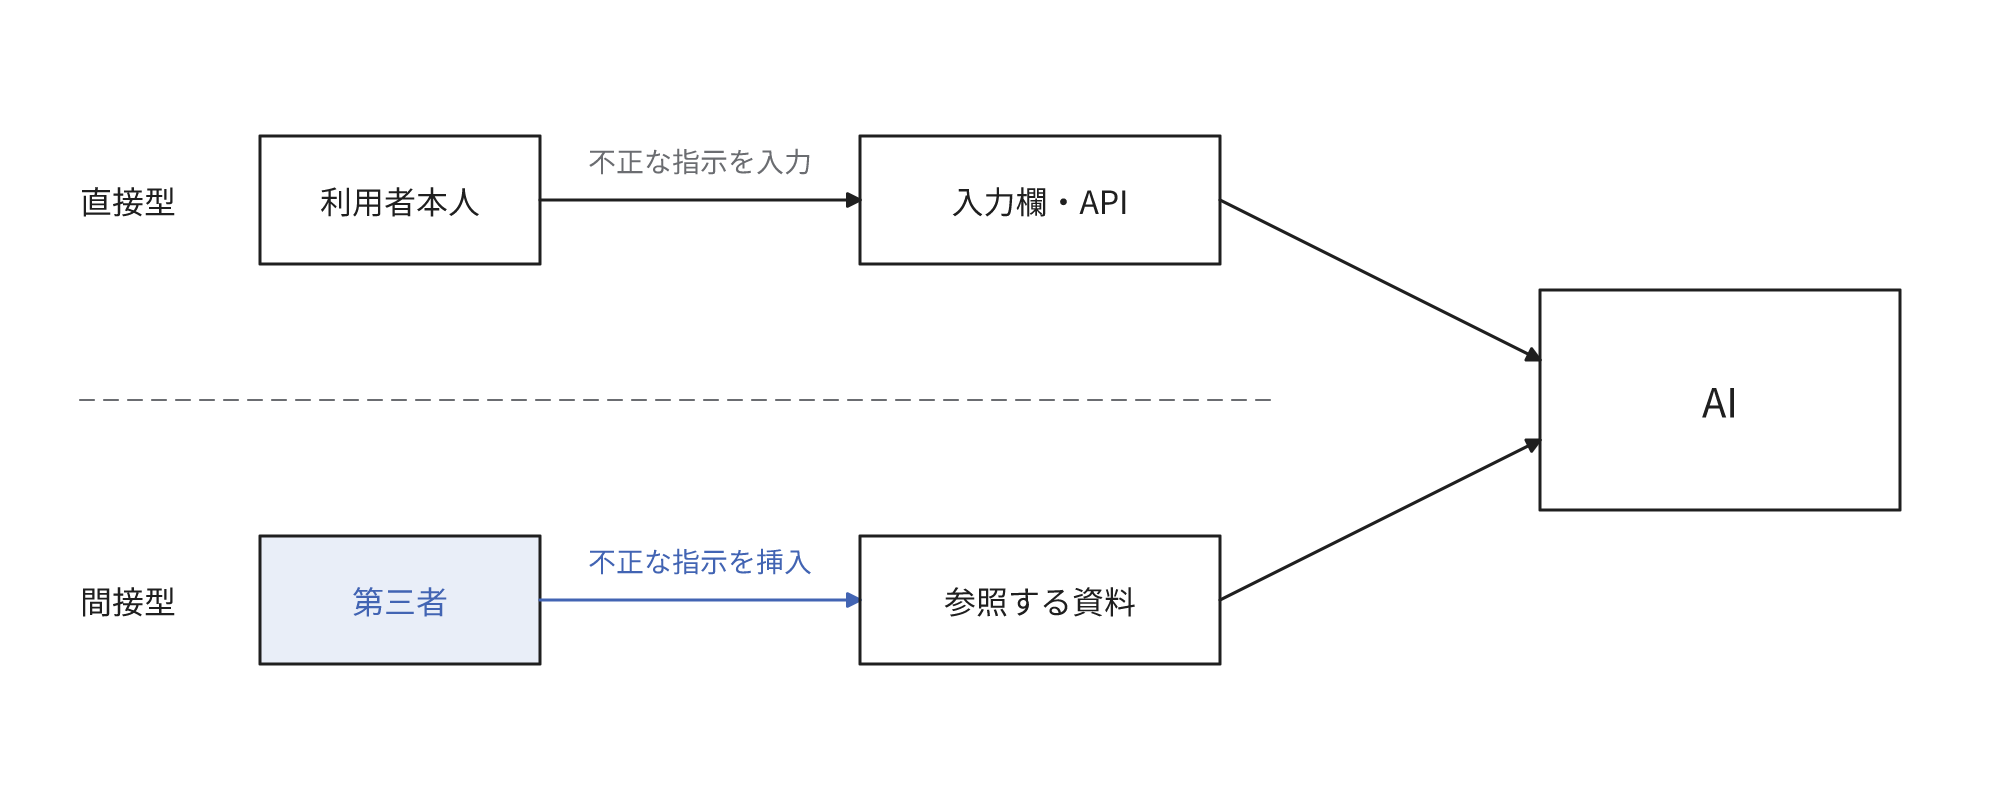
どちらの型でもAIが閲覧できる情報の流出や、AIに許可した操作の不正な実行が起こり得ます。
2023年に発表された研究は、Bing ChatのWebページの閲覧機能を利用し、ページのHTMLコメントに挿入した指示で実在する製品の動作を誘導できることを実証しました。攻撃者はAIに直接入力していません。実験には研究者が用意したローカルのページを使用しています。
業務で利用する場合は利用者である社員や、情報とシステムを保有する会社が被害者になるおそれがあります。
直接型でも、悪意のある内部者やアカウントの乗っ取りがあるため、社員の入力に安全の保証はありません。間接型は社員に悪意がなくても成立します。
なぜ完全には防止できないか
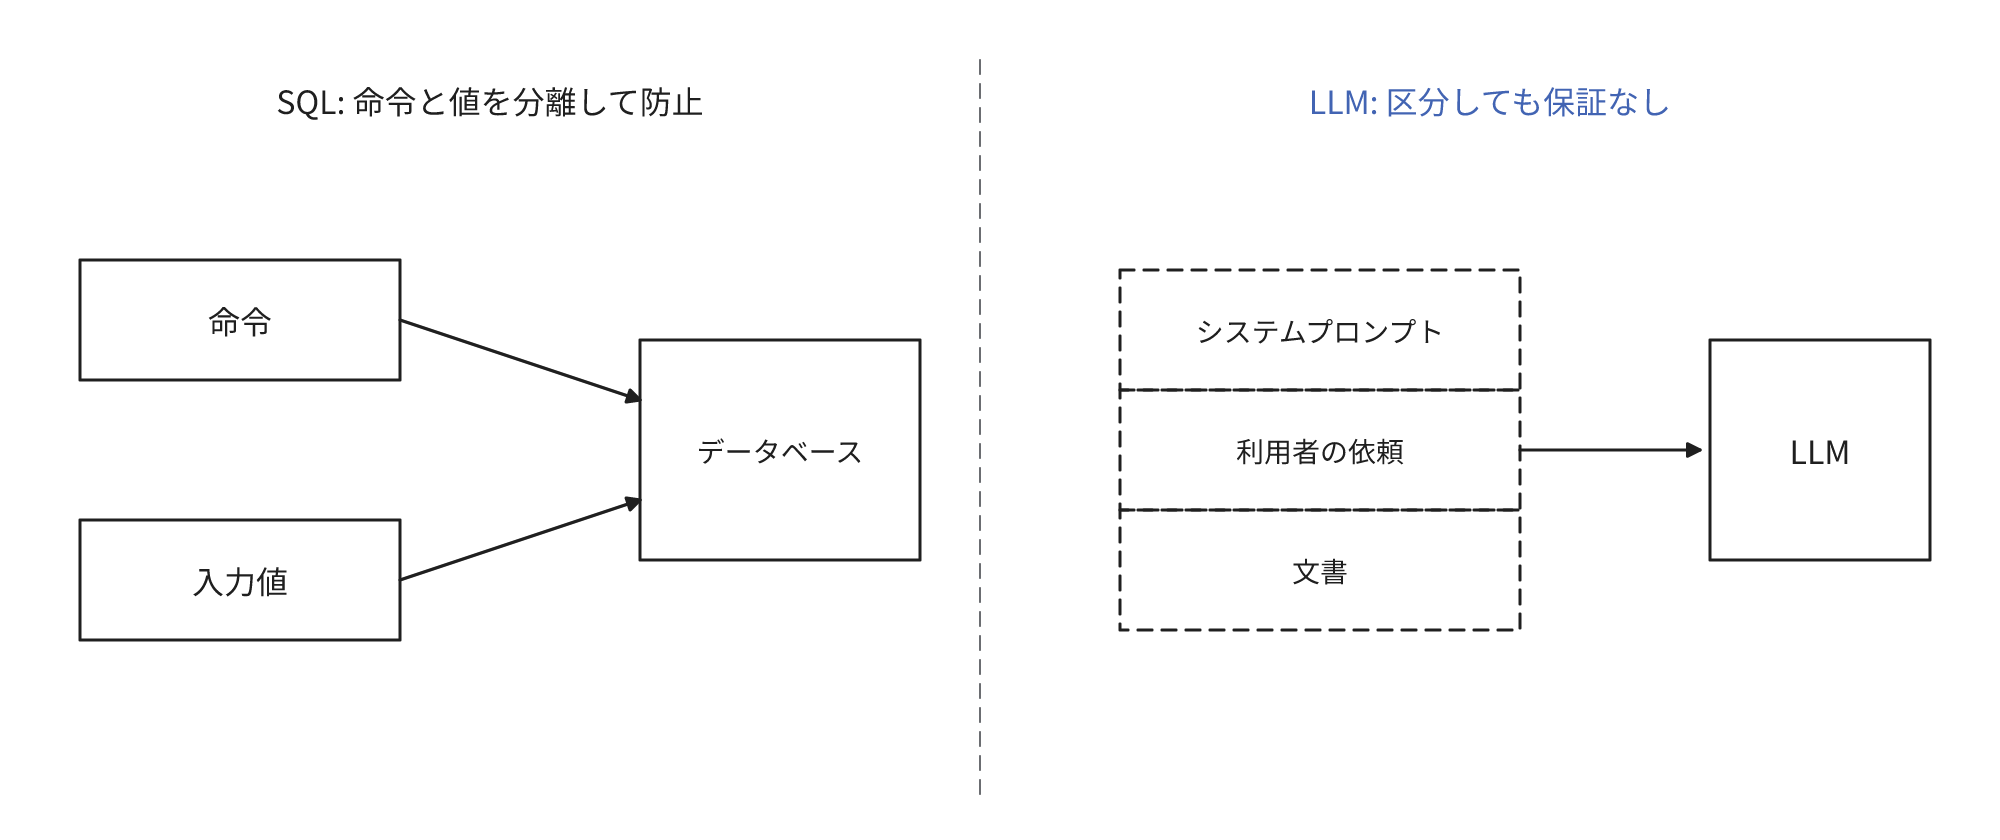
LLMにはシステムプロンプト、利用者の依頼、処理対象の文書を互いに区分して入力する仕組みがあります。しかし、通常のLLMだけでは、信頼性の異なる入力をこの区分どおりに常に処理させることはできません。
名称の類似したSQL(Structured Query Language)インジェクションは、データベースへの命令文に不正な入力値を混入させる攻撃です。この攻撃は命令と入力値を分離して受け渡す方式を正確に実装すれば防止できます。英国NCSC(National Cyber Security Centre)の解説は、LLMにはこの分離がないと指摘しています。同解説はプロンプトインジェクションについて、SQLインジェクションと同じ形では解消できない可能性があるとしています。
既知の攻撃の文面を登録して拒否する方式にも、言い換えによって回避される余地があります。OWASP(Open Worldwide Application Security Project)のLLMアプリケーション向けリスク一覧も、確実な防止方法があるかは不明としています。
Anthropicの2025年11月の報告は、ブラウザを操作するClaude for Chromeを対象とする社内の攻撃評価です。各環境で最大100回試行し、防御を改善した後もモデル別の攻撃成功率は1.4%から2.4%でした。成功率が低くても、文面を変更して試行を反復すれば、攻撃が成功する可能性はゼロになりません。そのため、攻撃の一部が成功する前提で対策を設計します。
被害の種類と拡大する条件
被害は3種類に分類します。
- 情報の流出。AIが閲覧できる顧客情報、人事情報、契約書を社外へ送信させる
- 回答の改変。事実と異なる内容を回答させる、重要な情報を回答から除外させる
- 操作の悪用。データの削除、権限の変更、送金のような、AIに許可した操作を実行させる
情報の流出は次の3つが同時に成立すると、外部の文章に挿入された指示だけで起こり得ます。利用者の指示により外部のツールを操作し、作業を自動で実行するAIをAIエージェントと呼びます。AIエージェントの安全性の議論には、この3つをAIに同時に保有させない整理があります。
- 機密データへのアクセス
- 信頼できない内容の入力。社外からのメール、外部のWebページ、多くの人が編集できる共有文書
- 外部への送信手段。メールの送信、外部URLへのアクセス、外部の画像の表示、利用者によるリンクのクリック
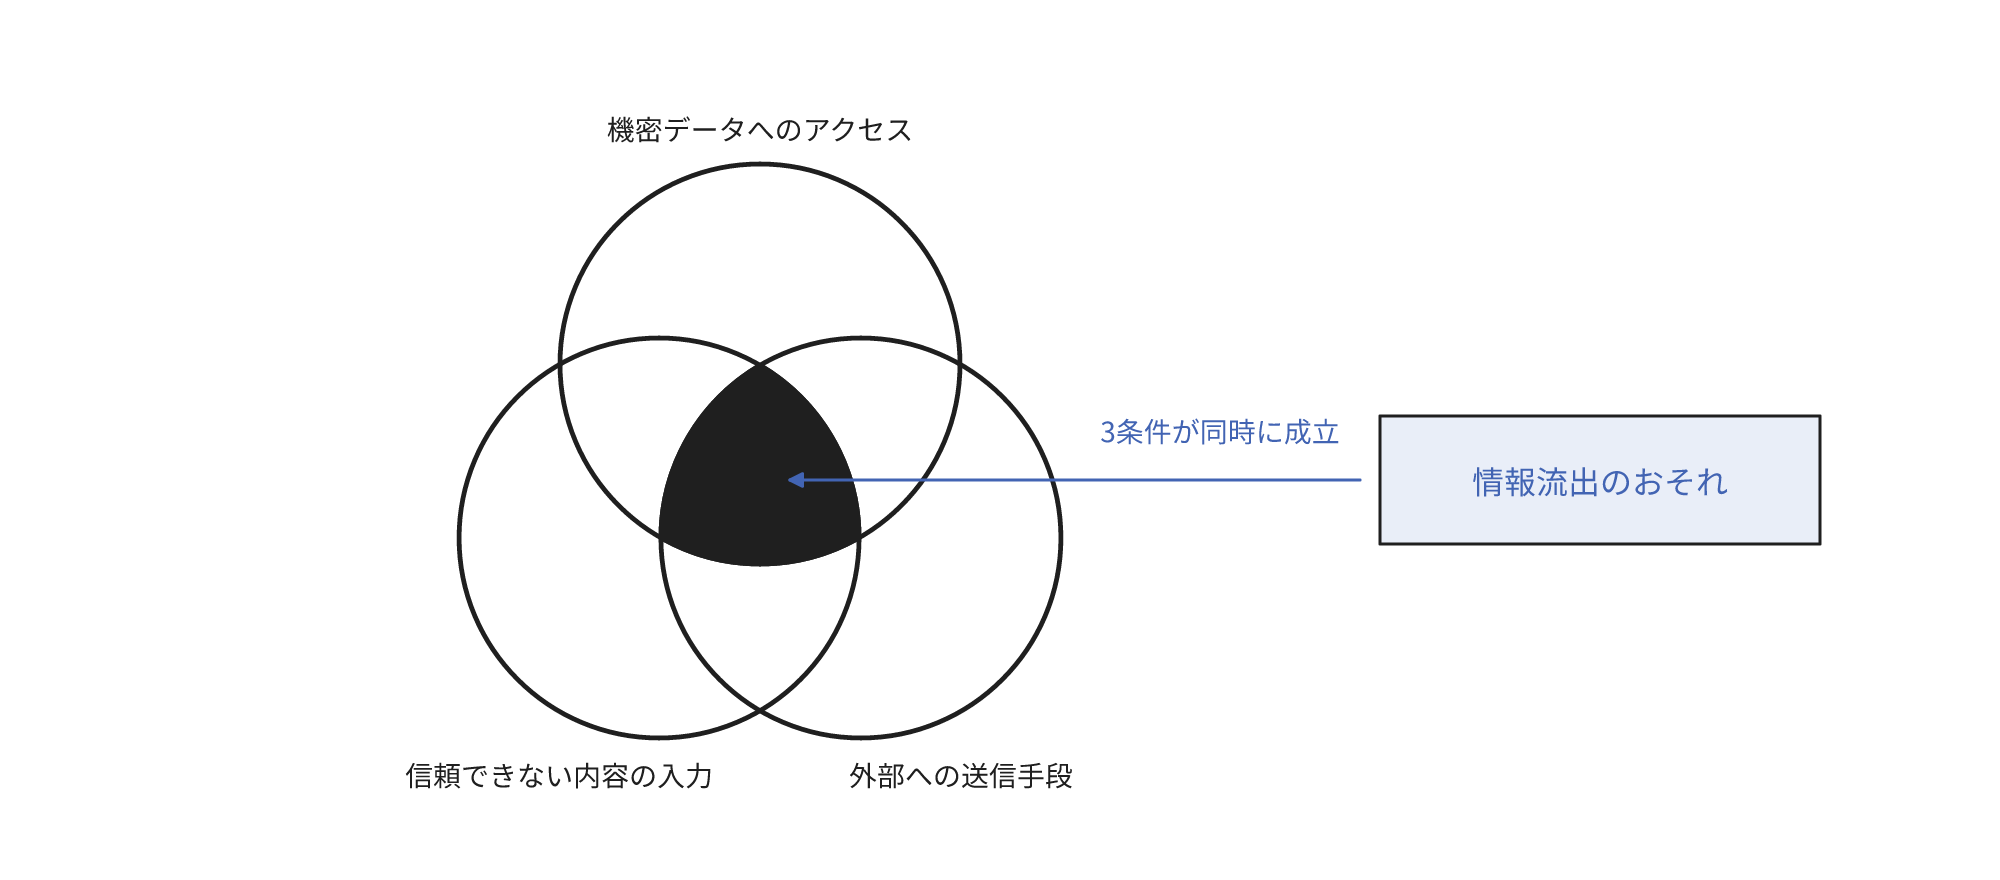
この3条件は情報の流出を評価するものです。3条件が成立しなくても、回答の改変や、AIに許可された操作の悪用が発生する場合があります。操作を実行するAIエージェントについては、NISTの分類も、データの持ち出しや任意のプログラムの実行のリスクが追加されるとしています。
対策の考え方
対策の前提はAIの出力と判断を信用せず、攻撃が成功しても被害が発生しない設計を優先することです。Microsoftの防御方針も、すべての攻撃の防止を前提とせず、一部が成功してもセキュリティ上の影響が発生しない設計を採用するとしています。
| 対策 | 内容 | 効果の性質 |
|---|---|---|
| 権限の最小化 | AIが閲覧できるデータと実行できる操作を業務上必要な範囲に限定し、判定はプロンプトでの指示ではなく接続先のシステムで行う | 攻撃が成功しても被害の範囲を制限できる |
| 送信の制限 | 送信先、送信できる機能、送信する内容をシステム側で制限し、外部URLや外部画像は許可した宛先に限る | 流出の手段を削減できる |
| 重要操作の前の人の確認 | 社外へのメール送信、削除、支払い、権限変更は、実際の宛先、本文、対象データ、金額を表示して承認を得る。承認した内容と実行する内容を一致させる | 承認者が表示された内容を確認できれば実行を阻止できる |
| 入力元の区別と検知 | 社外から来た内容をデータとして明示してその中の指示に従わないようシステムプロンプトで指示し、攻撃らしい文章を処理の前に除外する | 成功率は低下するが、検知を回避する攻撃は残存する |
| 監視 | AIへの入力、出力、ツールの呼び出しをログに記録し、異常な呼び出しや試行の繰り返しを調査する | 被害や攻撃の兆候を発見できる |
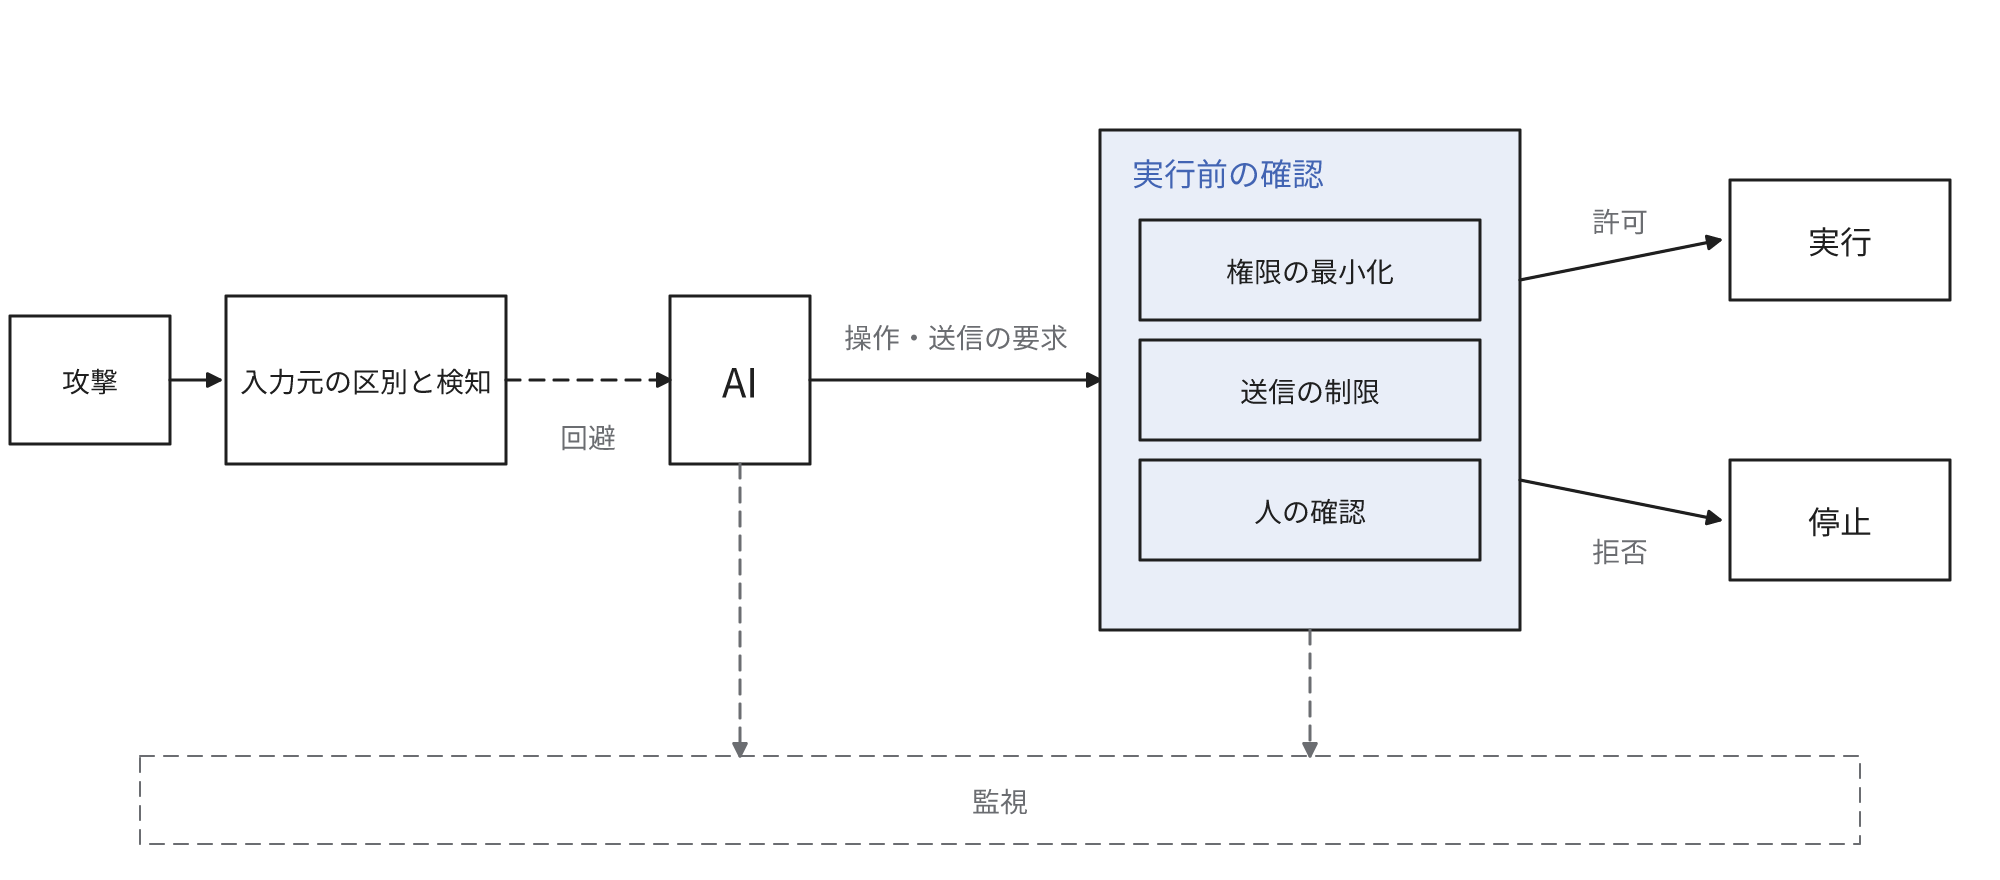
権限の最小化は総務省のガイドラインが最小権限の原則として提示し、重要操作の前の確認はGoogleの防御方針が予定の削除などで採用しています。
対策のコストと引き換えになるもの
- 人の確認工程の人件費。承認の件数が多いと内容を精査せずに承認する件数が増加し、形骸化する
- 自動化の範囲の縮小。権限を限定するほど、AIが自動で実行できる操作の範囲は限られる
- 権限の同期の手間。人事異動のたびに、AIが参照するデータの閲覧権限を社員の権限と同期させる必要がある
- 記録の管理。ログ自体が機密情報を含むため、保存先の権限、機密情報の除去、保持期間の設計と保存費用が必要になる
- 検知製品の費用。誤検知で処理が停止する場合もある
- 再試験。モデルの更新や連携先の追加のたびに発生する
導入時に確認すべきこと
導入するAIについて、用途の名前ではなく構成で、被害の3種類それぞれが起こり得るかを確認します。社内規程に回答するだけのチャットAIでも、回答に外部の画像やリンクを表示する構成なら情報を外部へ送信する手段になり得ます。
確認する項目は次のとおりです。
- AIが処理する内容の一覧と、それぞれを誰が作成・編集できるか
- AIが閲覧できるデータの範囲が、利用者本人の閲覧権限を超えていないか
- AIが実行できる操作のうち、不可逆な操作はどれか
- 外部へ情報を送信できる手段がどこにあるか。メール送信、外部URLへのアクセス、画像やリンクの表示を含む
- 利用する製品に、外部ツールとの連携を管理者が無効にする設定と操作前の確認機能があるか
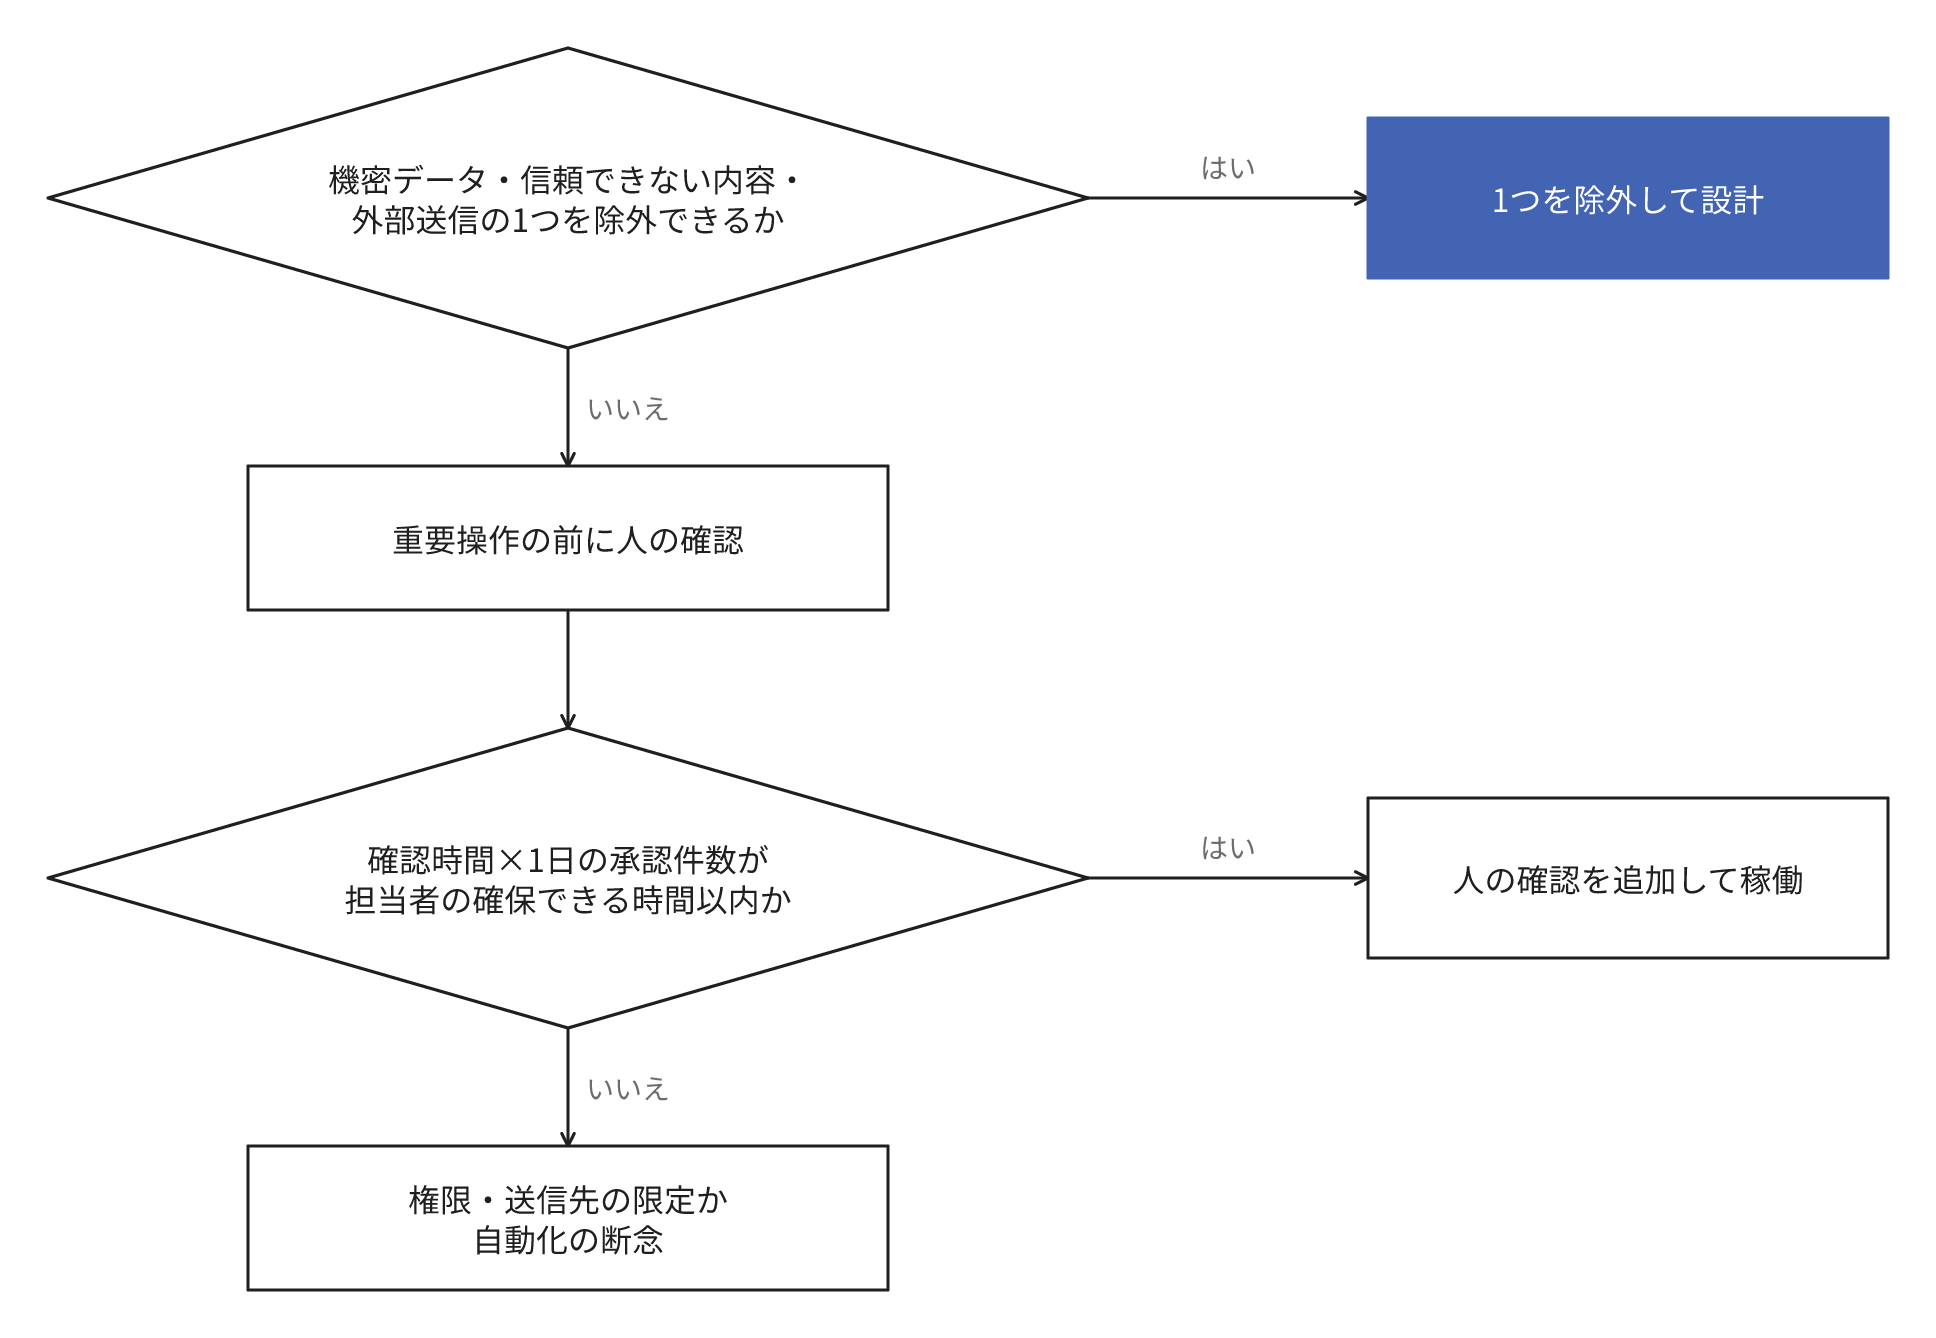
流出の3条件が成立する構成では、1つを除外する設計を先に検討し、除外できない場合は重要操作の前に人の確認を追加します。社外のメールを処理し、社内の機密データを閲覧でき、メールを送信できるAIを、人の確認なしで稼働させる設計は避けるべきです。
人の確認を追加する操作は承認1件の確認時間と1日の承認件数の積が担当者の確保できる時間以内かで設計します。時間を超過する場合は権限や送信先を限定して承認が必要な操作を削減するか、その操作の自動化を断念します。
よくある誤解
社内の資料だけを参照するAIなら攻撃は発生しない
社内の資料も、編集できる人が多ければ攻撃の入り口になります。社外から受信したファイルが共有フォルダに保存され、RAGの検索対象に含まれることもあります。攻撃の入り口になるかどうかは、参照先が社内か社外かではなく、攻撃者が内容を作成・編集できるかに依存します。被害の範囲もAIの権限、外部への送信手段、防御策によって変動します。
お問合せ
事業の課題や技術的な悩みなどどんなことでもお聞かせください