
ファインチューニングとは
ファインチューニングは学習済みのAIモデルに追加の学習をさせ、特定の作業に適合させる方法です。
AIモデルの内部には入力に対する出力を決定する大量の数値があり、これを重みと呼びます。
追加の学習では用意した例を反復して入力し、モデルの出力が例の出力に近似するよう重みを少しずつ更新します。
対象とするのは自社で用意した入力と望ましい出力の組を学習させる教師ありファインチューニングという一般的な方式です。
例えば、過去の問合せの文面と、担当者がそれに付与した自社の区分を1件ずつ対にしたデータです。
問合せを自社の区分に分類する、報告書を社内の書式で要約する、といった作業で出力のばらつきを低減するために使用します。
モデルへの指示や入力の文章をプロンプトと呼びます。
プロンプトエンジニアリングは、プロンプトの書き方を工夫して出力を改善する方法です。
RAG(Retrieval-Augmented Generation、検索拡張生成)は、質問のたびに社内資料を検索し、該当する箇所をモデルへの入力に追加してから回答させる方法です。
どちらも重みを変更しない点でファインチューニングと異なります。
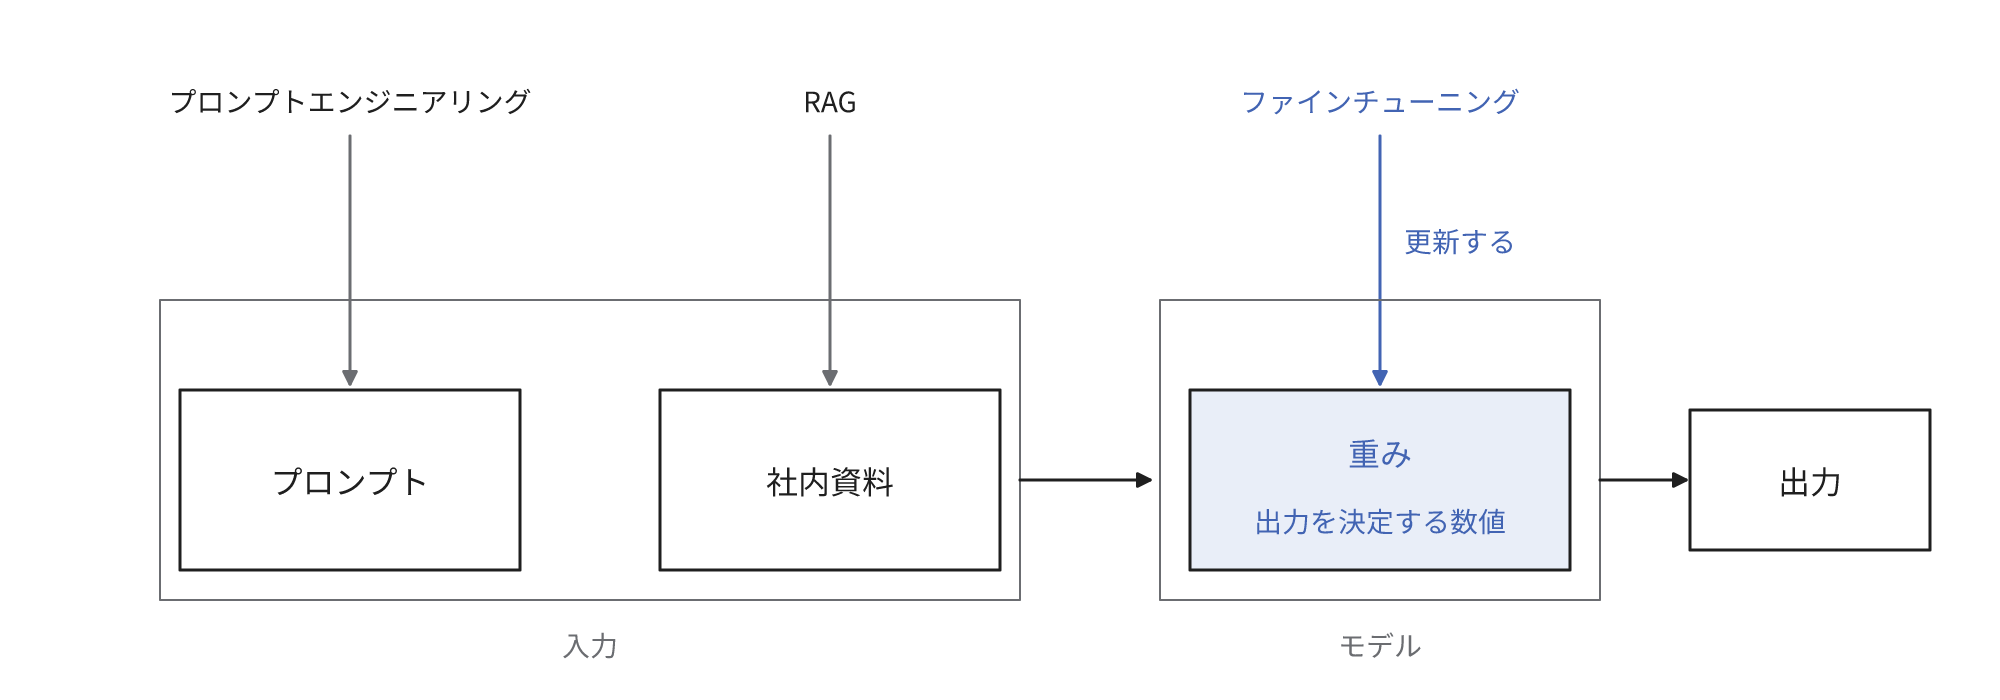
たとえば、経験者に研修で自社の書式を習得してもらうことに近く、改訂が継続する規程は記憶させるより最新版を参照させるほうが確実です。
なぜ必要か
汎用のモデルは幅広い文章で学習しており、自社だけの区分や書式に準拠した出力を生成するとは限りません。
プロンプトで区分の定義と例を説明すれば多くの作業は処理できますが、評価すると出力が安定しない作業もあります。
例を追加するとプロンプトが長くなり、推論コストや応答時間も増加することがあります。
推論コストはモデルに入力を処理させて出力を得るたびにかかる費用です。
期待する出力をプロンプトで明確かつ簡潔に定義でき、そのプロンプトで期待どおりの結果が安定して得られる作業は、追加の学習をしなくても元のモデルで対応できます。
ファインチューニングを採用するのはプロンプトでは結果が安定しないときや、作業が複雑でプロンプトに書き切れないときです。
検討する順序
まずプロンプトを工夫し、評価で不足が判明した種類の問題にだけ次の手段を追加します。
最初に用意するのは合格とする出力の基準と、正解付きの評価データセットです。
評価後も残存する問題は答えに必要な情報をモデルが保有しない知識の不足と、書式や判定が一定しない振る舞いの不揃いに区別して対処します。
- 項目の欠落や形式の崩れだけが問題なら、ファインチューニングは採用せず、構造化出力と機械的なチェックを使用する。構造化出力は出力の項目と形式を指定してモデルの出力をその構造に従わせる機能である。OpenAIの構造化出力は、対応する形式の指定と設定を使用し、回答の拒否や途中終了がなければ指定した構造に準拠する出力を保証する。内容の正確さは別に確認する
- 社内文書の知識が不足するならRAGを追加し、ファインチューニングは採用しない
- 区分の判定や口調が評価で目標の水準に達しないなら、ファインチューニングを採用する
- 多数の例を毎回プロンプトに列挙していて推論コストや応答時間が問題なら、例を削減したプロンプトで評価の結果を維持できる場合にファインチューニングを採用し、維持できなければ元のプロンプトで運用する
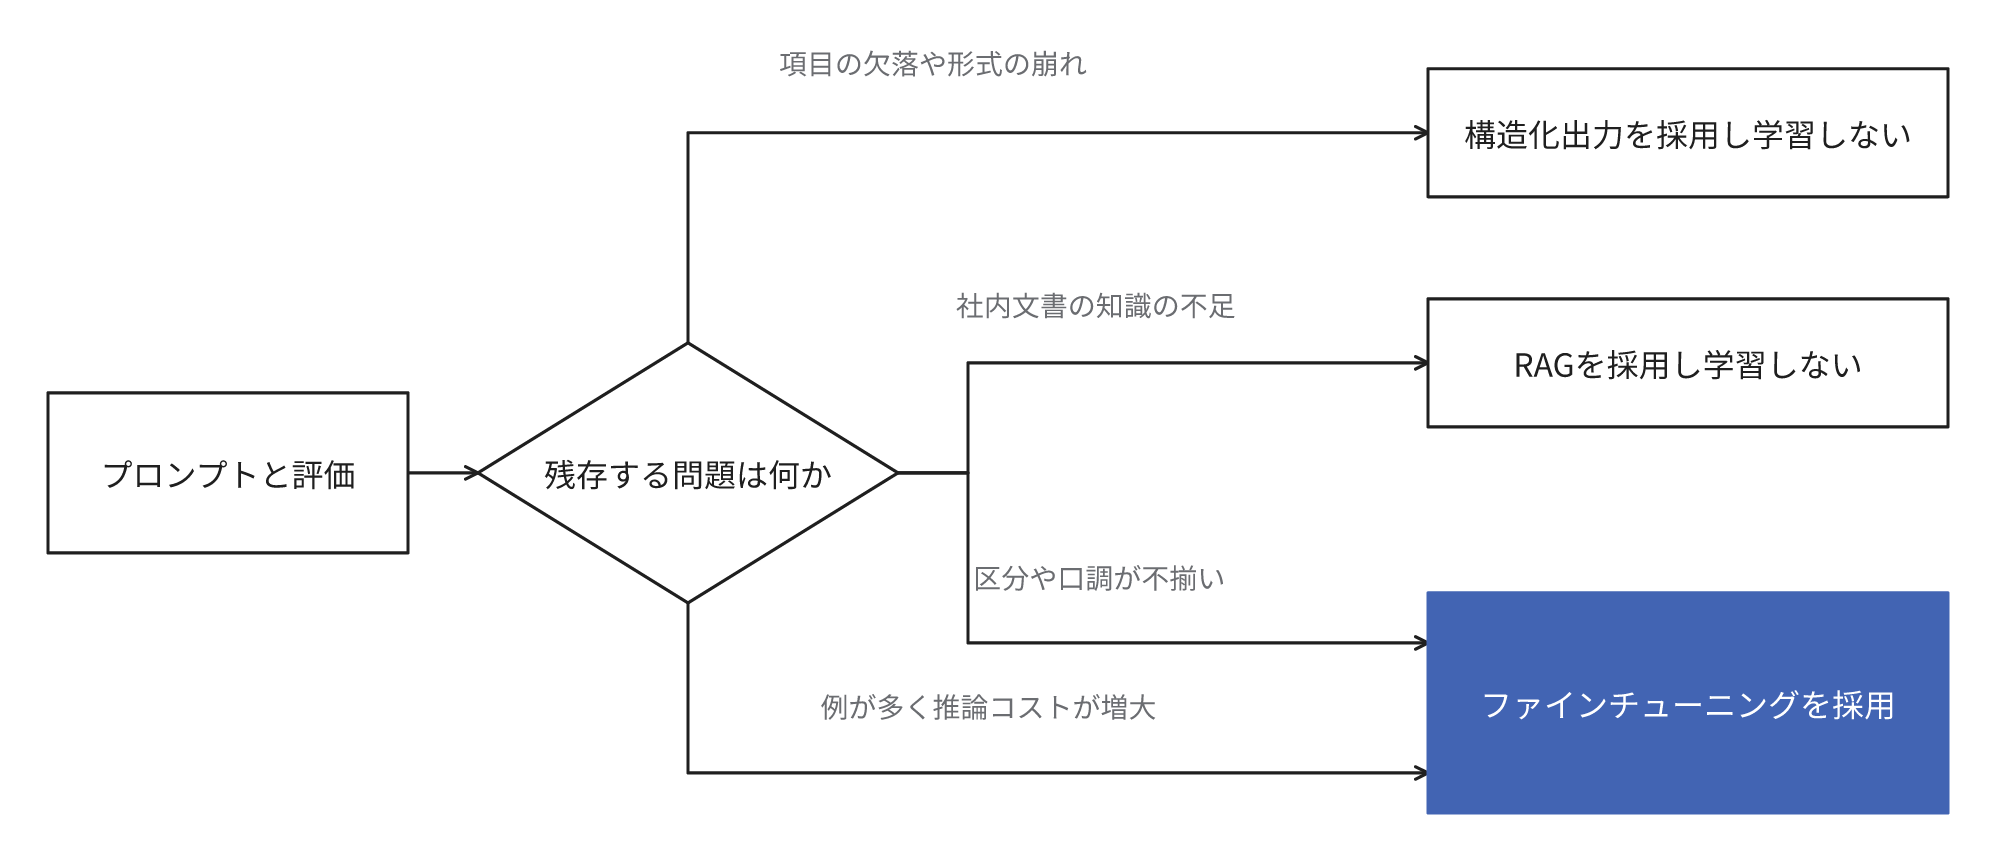
RAGはファインチューニングの前に必ず経由する工程ではなく、知識の不足があるときに追加する手段です。
文書はRAGで提供し、回答の書式は学習で統一する、という併用もできます。
学習を試行する前に採算を見積もります。
採算は件数だけでは確定せず、月間の件数と1件あたりの作業時間の減少量から算出した削減時間を人件費に換算した額と、学習データの作成、評価、学習、モデルの保管、再学習にかかる費用を比較します。
試算では前提を固定します。
例えば、1件で2分減ると仮定した作業が月3,000件あれば、月100時間の削減になります。
件数が少なく人手の修正で対応できる作業は対象外とします。
適合する作業と適合しない作業
出力の形式が確定していて正解の例を用意できる次のような作業には、ファインチューニングを採用します。
- 問合せや申請を自社の区分に分類する
- 所定の項目と順序で、文書から要点を抽出する
- 自社の口調や表記ルールに統一した文を作成する
- 大規模なモデルが対象の作業で達成している品質に、小規模で安価なモデルの品質を到達させる
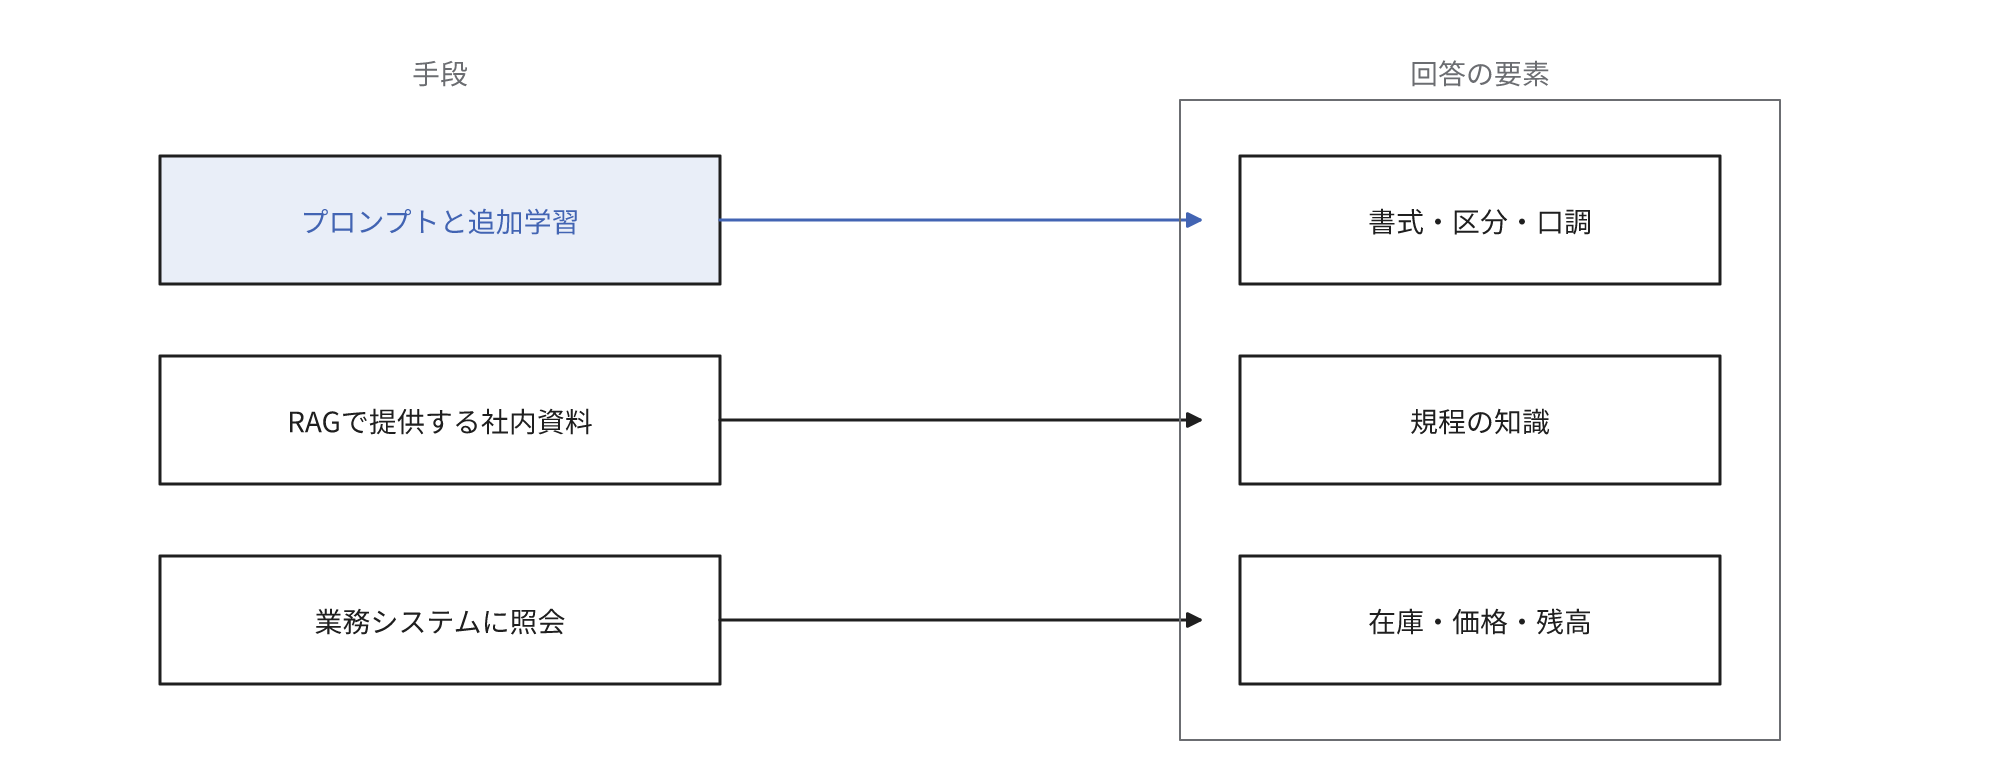
適合しないのは文書の知識を回答させる用途です。
知識を学習させること自体はできますが、この用途にはファインチューニングを採用せず、RAGを採用します。
- 改訂が継続する規程やマニュアル。学習した内容を正確に抽出できる保証はなく、重みに記憶させる運用では改訂に応じて再学習が必要になることがある
- 回答の出典を示す必要がある業務。重みから、どの資料に由来する回答かを特定することは困難である
- 部署や役職によって開示してよい情報が異なる業務。学習した内容は誰の質問への出力にも出現する可能性がある
在庫数、価格、残高のような現在の値は、ファインチューニングでもRAGでもなく、業務システムへの照会で取得します。
効果
- 書式や区分の判定のばらつきを低減できる場合がある
- プロンプトに列挙していた例を削減して入力を短縮できれば、1件ごとの推論コストや応答時間を抑制できる場合がある。比較はファインチューニングしたモデルの推論コストに学習と保管の費用を合算した総額で行う
- 小規模なモデルで対象の作業の合格基準を達成できれば、利用量の多い作業で費用を抑制できる
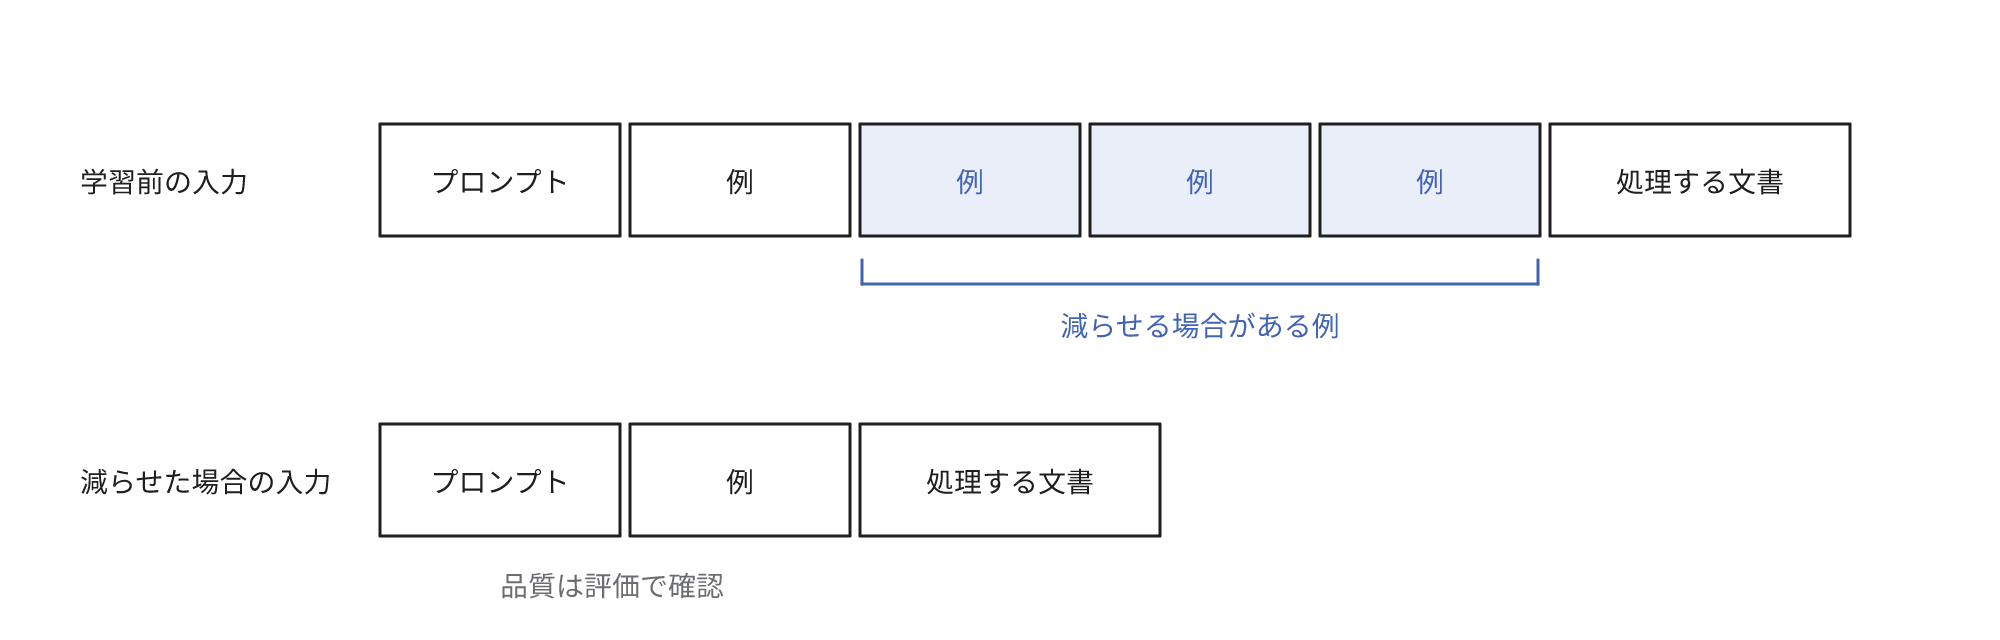
ばらつきの減少も費用の削減も、学習前後の評価で確認してから見積もりに含めます。
コストとリスク
- 学習データの作成と確認。計算の費用だけでなく、業務の担当者が例を作成し、誤りを確認する人件費を見積もる
- 評価の維持。評価データセットを更新し、再学習のたびに出力を比較する
- 学習と保管の費用。AWSの生成AIサービスであるAmazon Bedrockでは、学習データの量と学習の回数に応じた学習費のほか、ファインチューニングしたモデルの保管料が毎月かかる
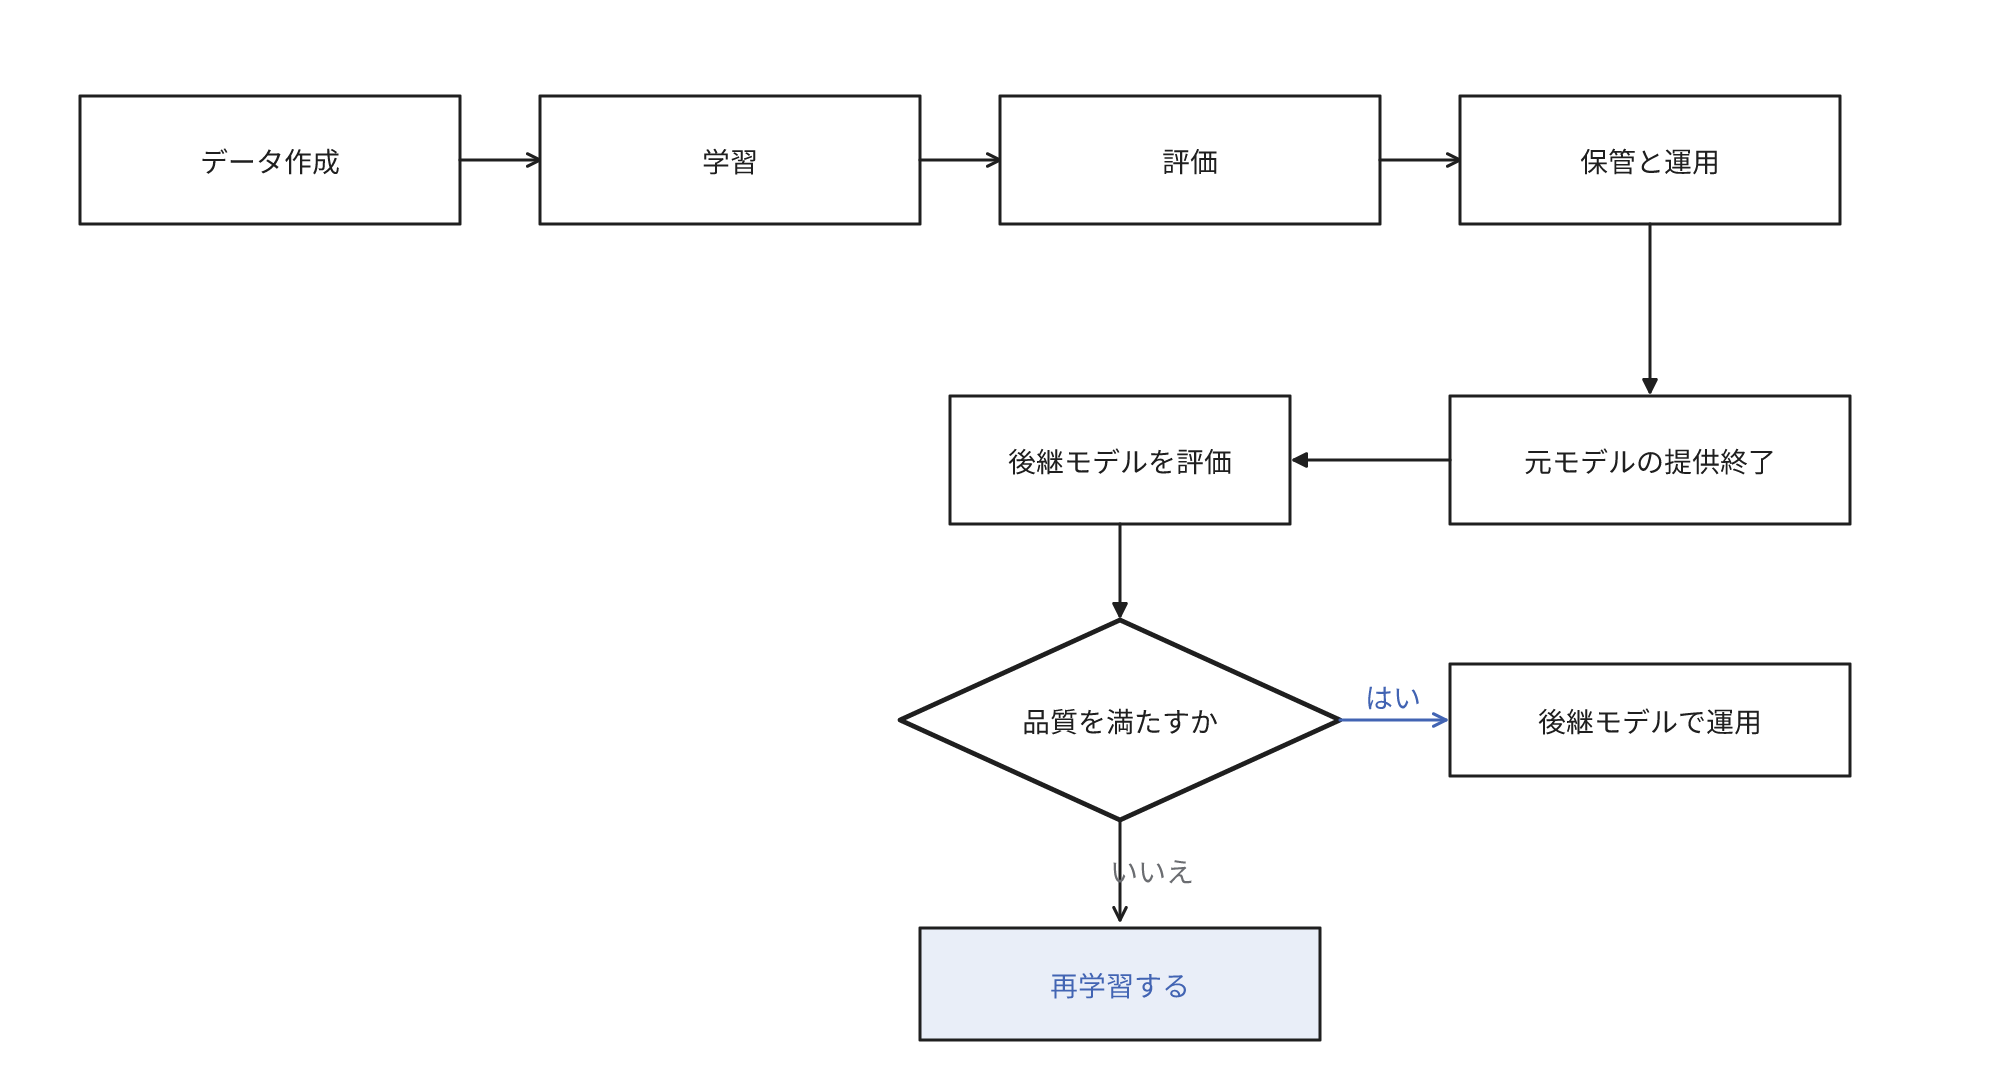
- 提供者への依存。OpenAIではファインチューニングしたモデルも元のモデルと同じ日程で提供が終了する。提供終了のときは後継のモデルで再評価し、合格基準を満たさなければ再学習する
- 提供者の方針変更。OpenAIは2026年5月から、自社APIで利用者が操作する学習の受付を段階的に縮小し、2027年1月に既存の利用者も新規の学習を開始できなくなる予定と告知した。学習済みモデルの利用は元のモデルの提供終了まで継続する
- 誤りの学習。誤りや偏りのある例を学習すると、モデルがその誤りや偏りを習得して増幅するおそれがある
- 安全性の確保。ファインチューニングを行う利用者にも、モデルの開発者と同様に安全性を確保する努力がAI事業者ガイドラインで求められている
- 学習データに含めた情報の流出。個人情報や機密を含む例を学習すると、無関係な質問への出力に出現する可能性があり、学習は閲覧権限の制御の代わりにならない
- データの利用条件。学習に使用する例の利用目的、本人の同意、削除の求めへの対応を確認しておく
- 記録と担当者。学習データの出所と品質、ファインチューニングの方法、評価データセットはNISTの生成AIのリスク管理の指針で記録の対象として列挙されており、記録の更新と再学習を担当する人が必要になる
学習データと評価の準備
まず数十件から100件程度の質の高い例で学習させて評価し、不足すれば追加します。
OpenAIは件数より質が重要とし、50件以上から開始して評価しながら追加する進め方を推奨しています。
必要な件数は作業の難易度と例外の種類で変化するため、件数を追加したときに評価の結果が向上しているかを確認して増量を決定します。
準備は次の順で実施します。
- 合格とする出力の基準を、業務の担当者と文書で決定する
- 正解の基準を統一し、担当者間で回答が一致しない例を排除する
- 件数の多い区分だけでなく、まれな区分や複数の区分に該当する入力も含める
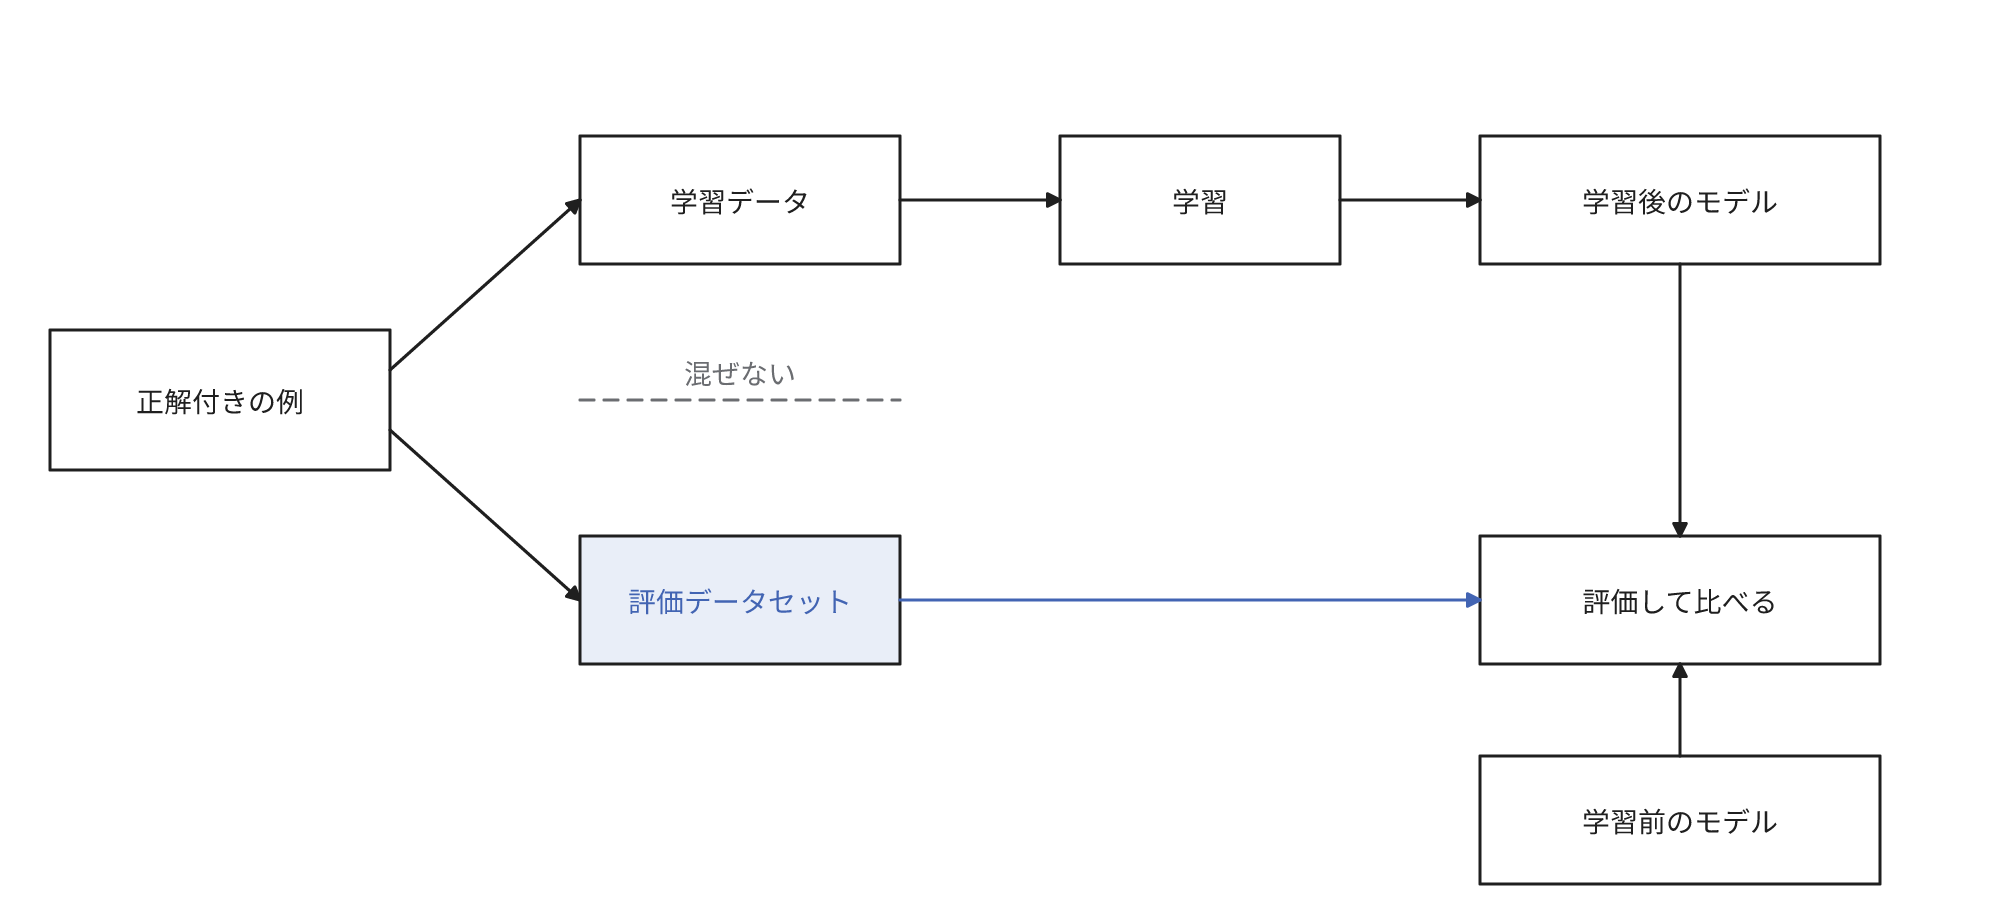
- 学習用と別の評価専用の例を確保し、同じ案件や類似の文面が両方に混入しないようにする
- 学習前のモデルで評価データセットの結果を測定し、比較の基準にする
- 学習後は対象の作業の結果のほか、元からできていた作業や安全性が悪化していないかも確認する
評価データセットを学習に混入させたり、同じ評価データセットを基準に調整を反復したりすると、本番での性能を過大評価するおそれがあります。
評価データセットは学習に使用せず、別に保管しておきます。
本番で担当者が修正した出力は、利用の権限と個人情報の扱いを確認したうえで、次の学習と評価のデータに転用できます。
正解の例を統一できない作業や、担当者の間で正解が確定しない作業は、この方式に適合しません。
よくある誤解
一度学習させたモデルは継続して使用できる
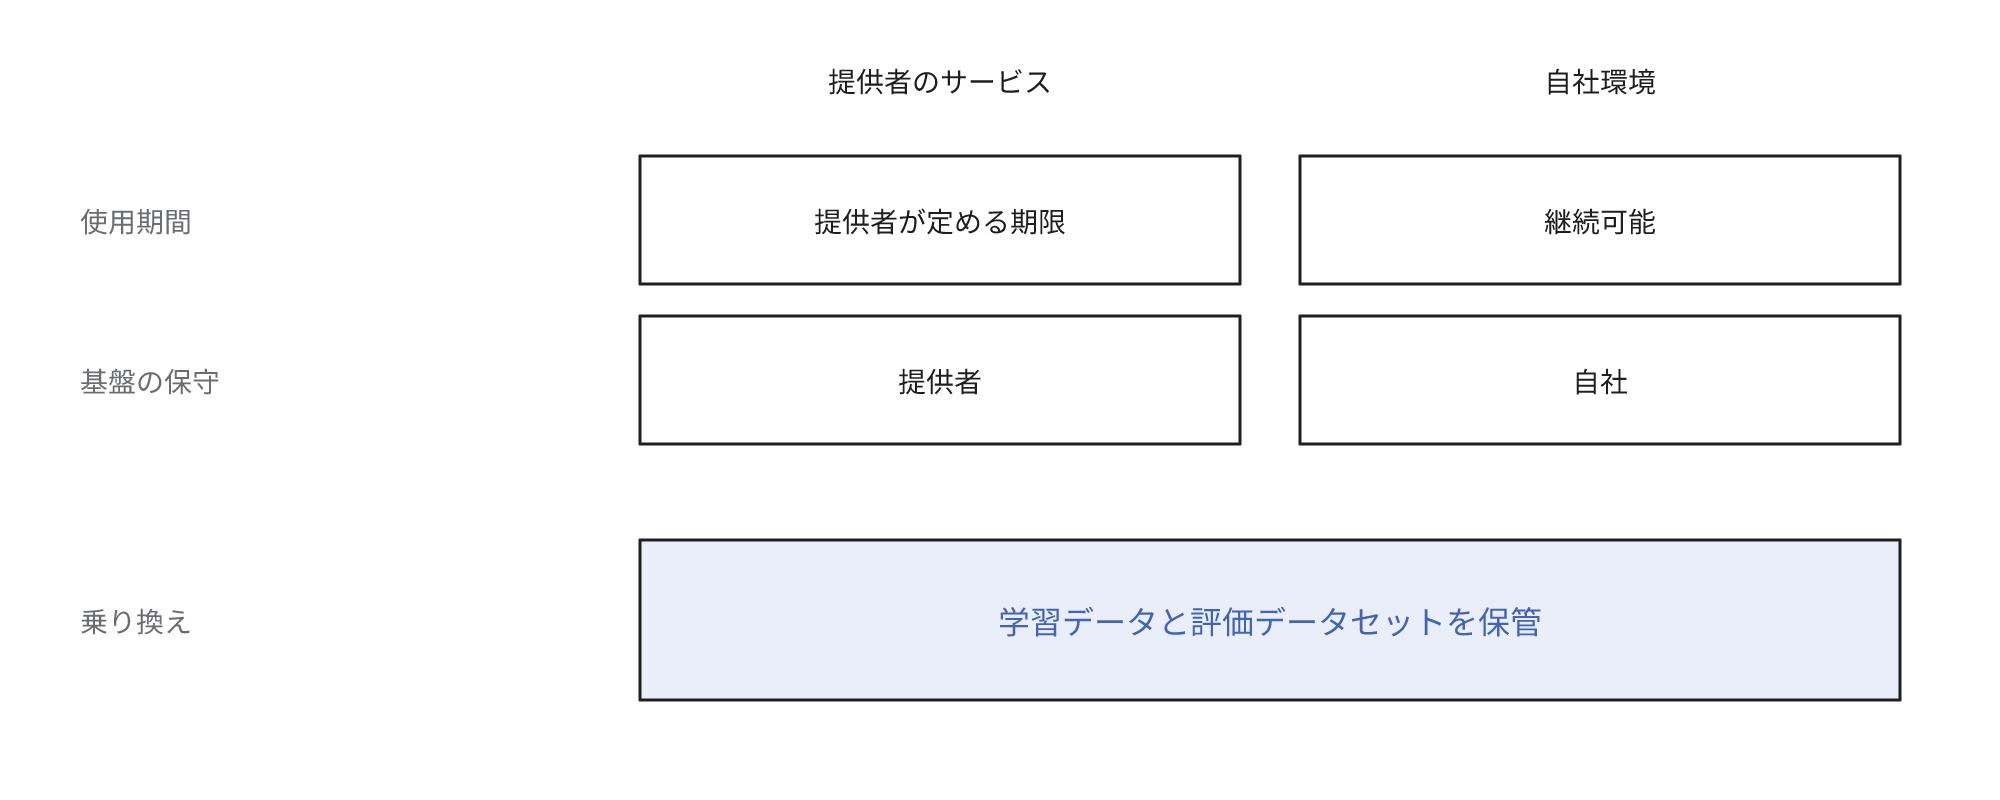
提供者のサービスでファインチューニングしたモデルには利用期限があり、その時期は提供者やモデルによって異なります。
OpenAIでは元のモデルの提供終了と同時に使用できなくなります。
重みが公開されたオープンウェイトモデルを自社の環境でファインチューニングして稼働させる場合は継続して使用できますが、更新と保守は自社の負担になります。
どちらの場合も学習データと評価データセットを自社で保管しておくことが乗り換えの前提です。
学習には自社で大規模な計算設備が必要になる
主要なクラウドは学習の機能をサービスとして提供していて、自社で計算設備を用意しなくても学習できます。
費用の見積もりでは計算の費用より欠落しやすい、学習データの作成と評価の人件費を先に算出します。
お問合せ
事業の課題や技術的な悩みなどどんなことでもお聞かせください