
コンテキストウィンドウとは
コンテキストウィンドウは、LLM(Large Language Model)が1回の処理で参照できる文章の量の上限です。
量は文章を分割した単位であるトークンの数で表示します。
1回でAIに入力できる資料の量の上限はこれで確定し、主要なモデルでは、実際に入力できる量は回答や会話履歴の分を控除した残りです。
長い会話では上限への接近に伴って過去のやり取りが参照から除外されたり要約されたりします。
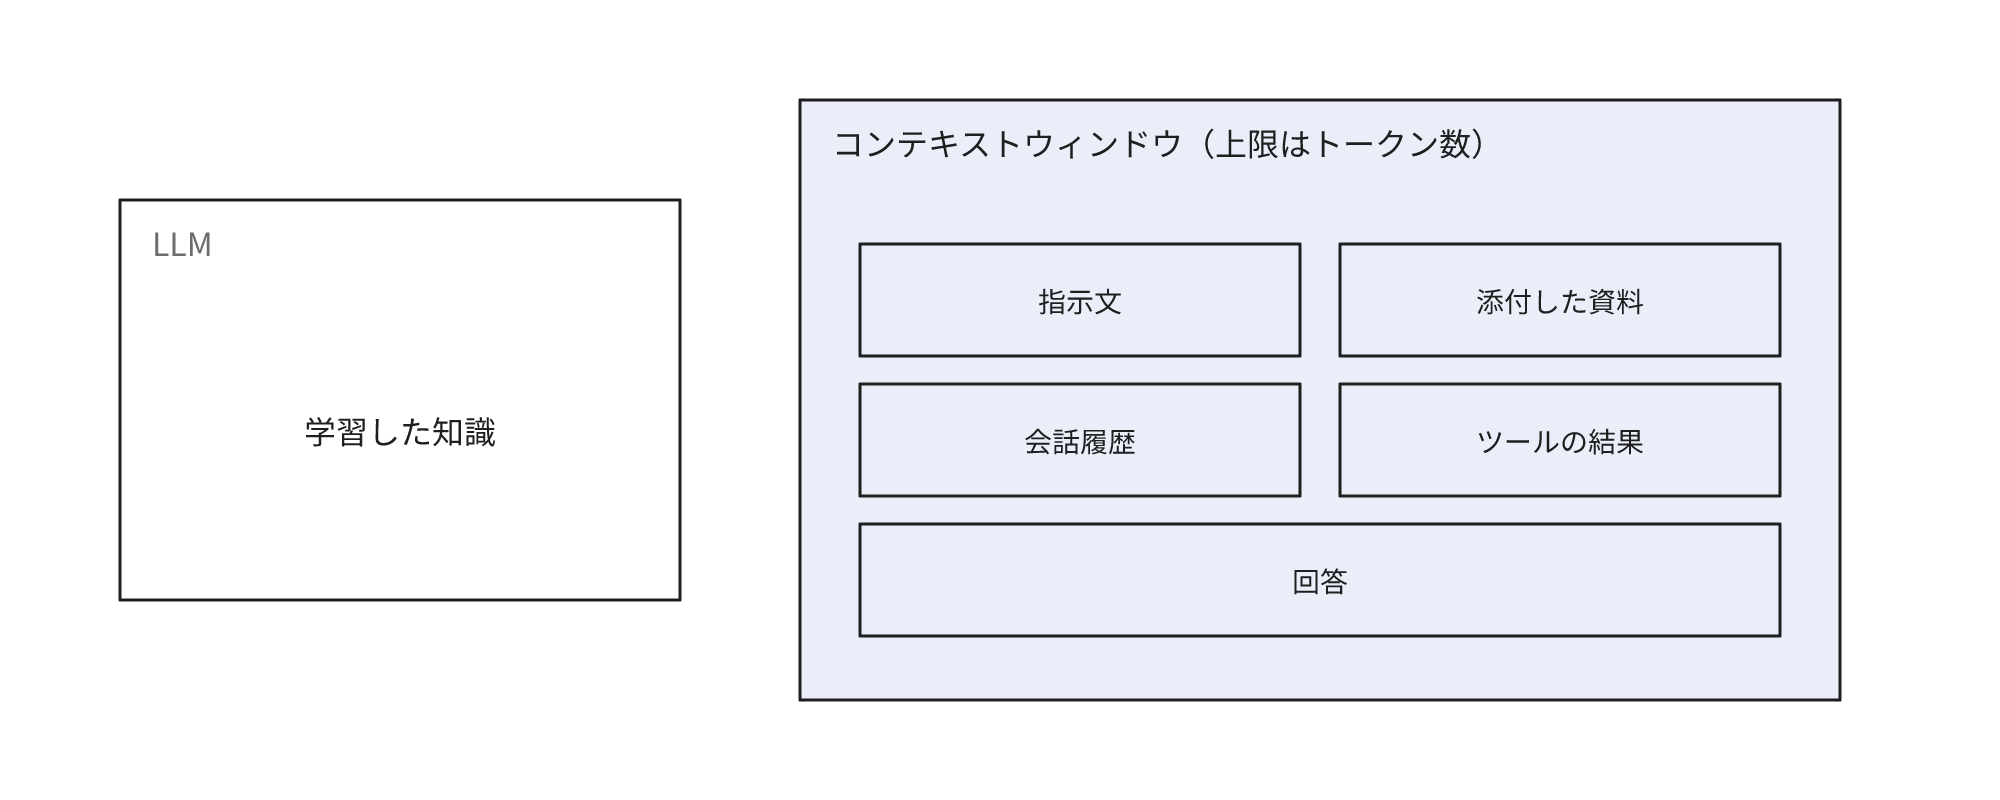
コンテキストウィンドウは回答の生成時に参照できるすべての文章を指し、モデルが学習した大量のデータとは別のものです。
たとえば社内規程のPDFと過去の議事録を添付し、規程に準拠した回答案を作成させるとします。
このとき上限を共有するのは、AIへの指示文、添付した資料、それまでの会話のやり取り、検索や社内システムから取得した結果です。
主要なモデルでは、生成する回答もこの上限に含めて計算します。
机の面積の比喩で説明すると、机の上の資料の量には上限があり、資料が多いほど必要な1枚の発見に手間がかかります。
LLMが学習によって獲得した知識は、コンテキストウィンドウとは別に存在します。
チャットの製品の記憶の機能も、保存した情報のうち関連するものを入力に追加して使用する仕組みで、上限そのものを拡大するものではありません。
上限の中に何をどの順で入力するかを設計する取り組みは、コンテキストエンジニアリングと呼ばれます。
上限によって発生する問題
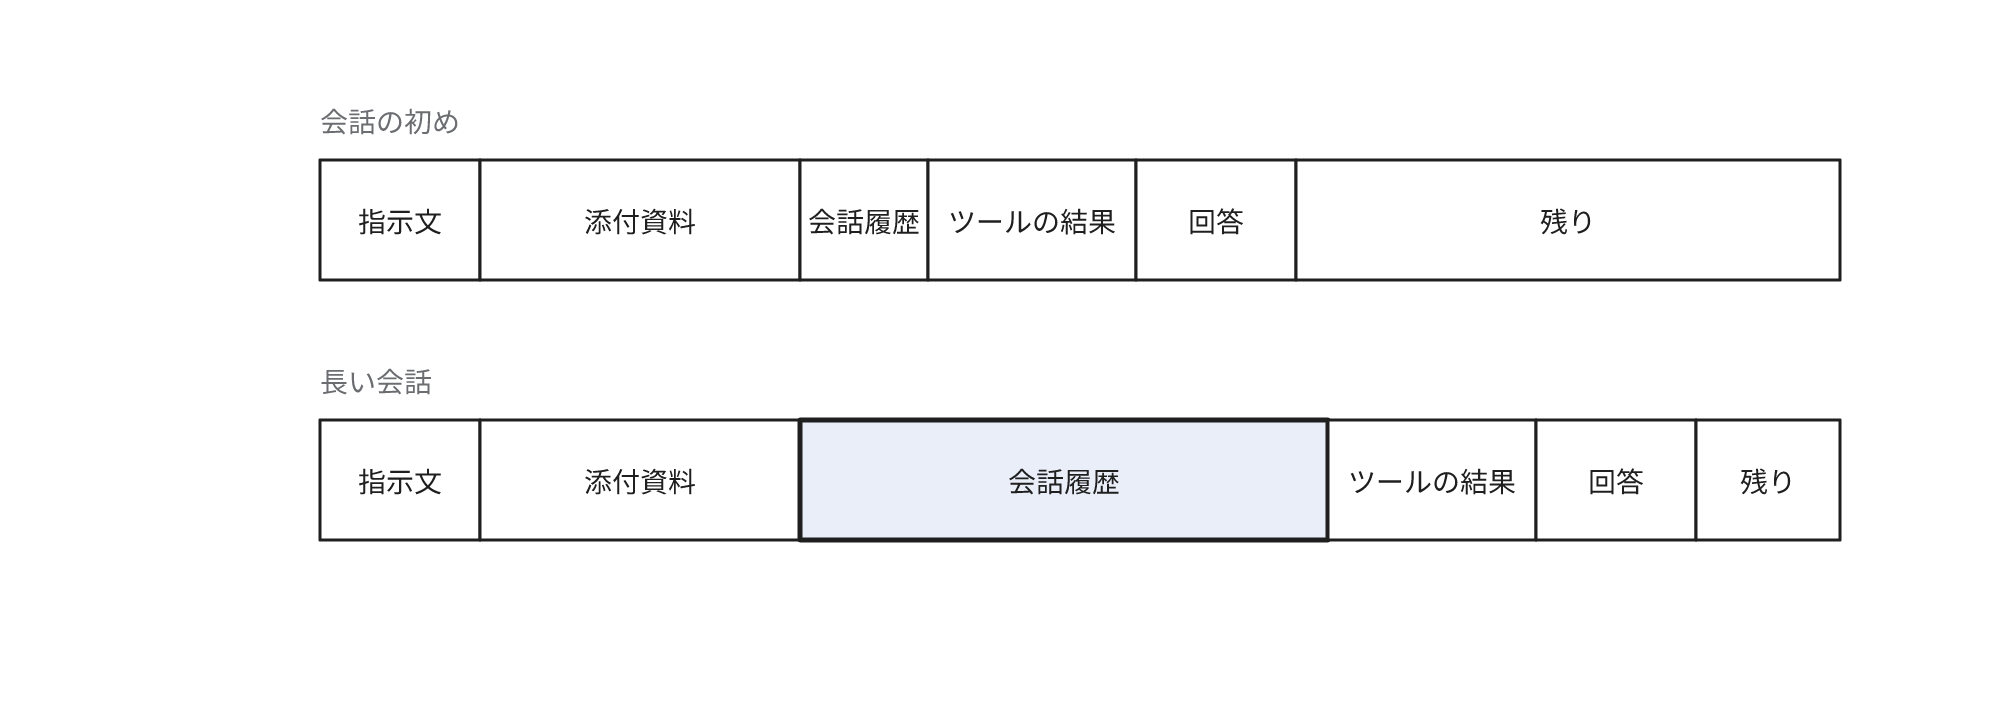
上限に関係する問題には、上限を超過した場合の問題と、超過しなくても発生する問題があります。
上限を超過した場合
- 入力だけで上限を超過すると、AnthropicのAPIでは処理がエラーで停止する
- コンテキストウィンドウとは別に、1回に生成できる出力の上限がある。回答の途中でどちらかの上限に到達すると、回答が途中で終了する
- 上限への接近時に、過去のやり取りを要約に置換したり参照の対象から除外したりする製品がある。利用者には、AIが以前の話を記憶していないように認識される
上限の範囲内でも発生する問題
入力が長くなるほど、正確さが低下することがあります。
必要な情報と無関係な情報が同じ入力に混在し、回答に使用すべき部分の特定が困難になるためです。
Chromaによる18のモデルの評価では、入力が長くなるほど性能が不安定になりました。
同じ評価で、会話全体の約11万トークンを入力した場合は、関連する部分だけを入力した場合より一貫して成績が低下しました。
約11万トークンは、100万トークン級の上限の1割程度です。
紛らわしい情報が含まれると誤答が増加し、増加の程度はモデルによって異なります。
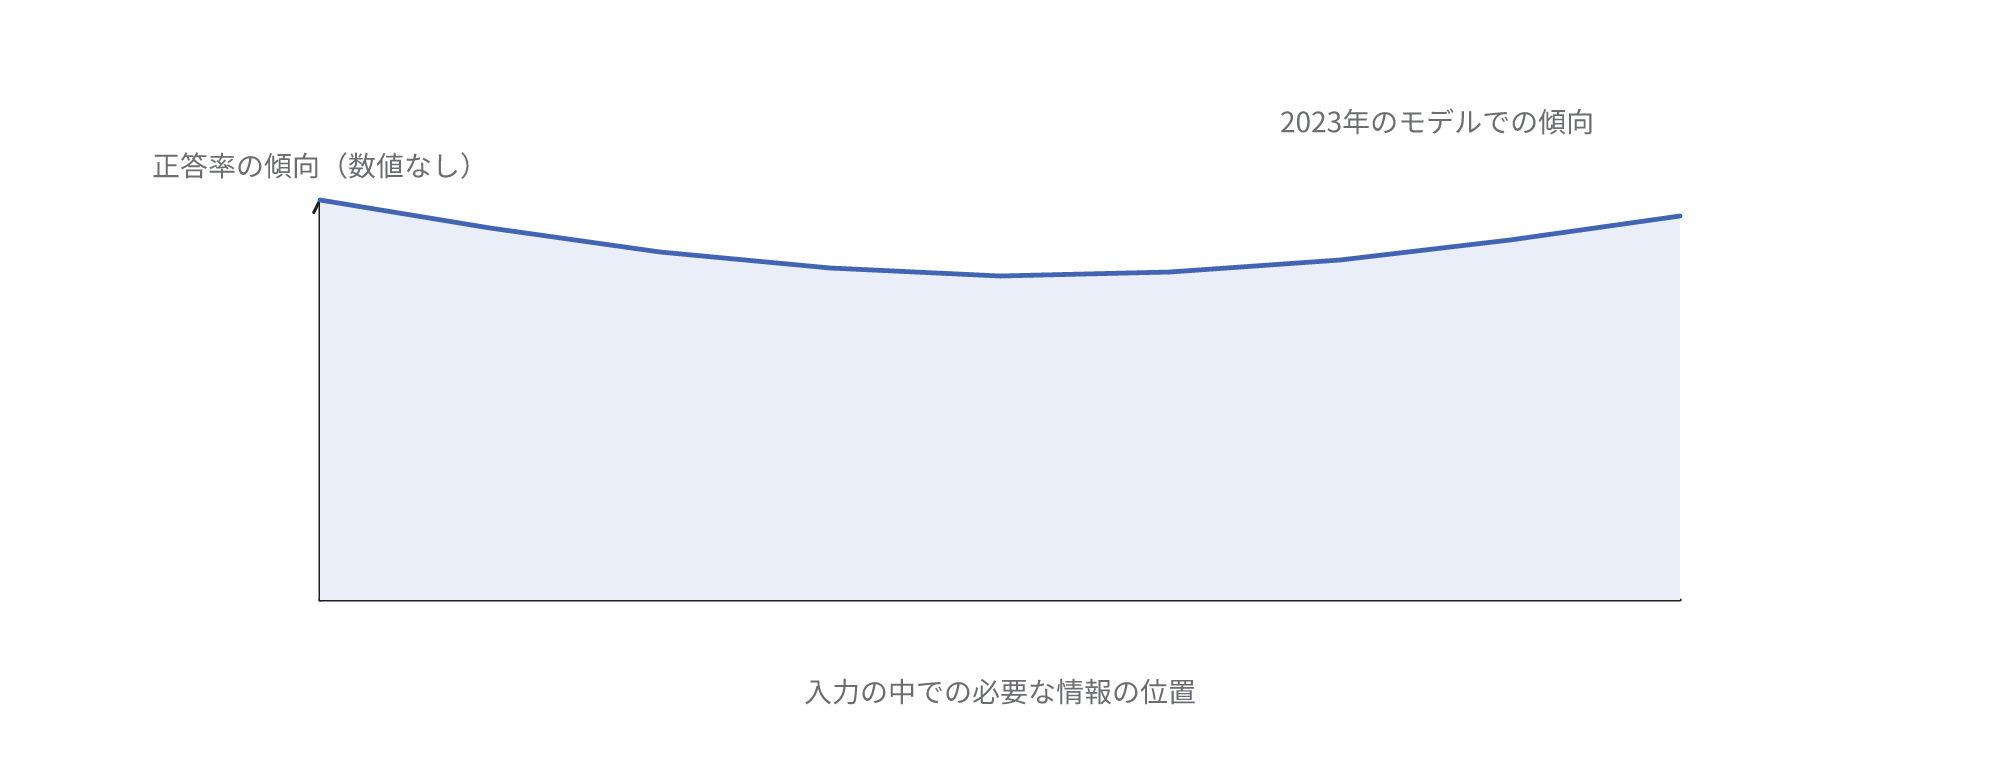
2023年のモデルを対象にしたLost in the Middleと呼ばれる評価では、必要な情報が入力の中ほどにある場合の正答率が、冒頭や末尾にある場合より低い結果でした。
Googleは長い入力について、質問を資料の後ろに配置する書き方を推奨しています。
同じ資料でGoogleは、複数の情報を同時に検索させると1つの情報を検索する場合と同じ精度にはならないとも説明しています。
コンテキストウィンドウの規模で判明する事項と判明しない事項
2026年11月時点で、AnthropicやGoogleの主要なモデルは100万トークン級のコンテキストウィンドウを提供しています。
上限の規模から判明するのは、資料を分割せずに一度で入力できるかどうかです。
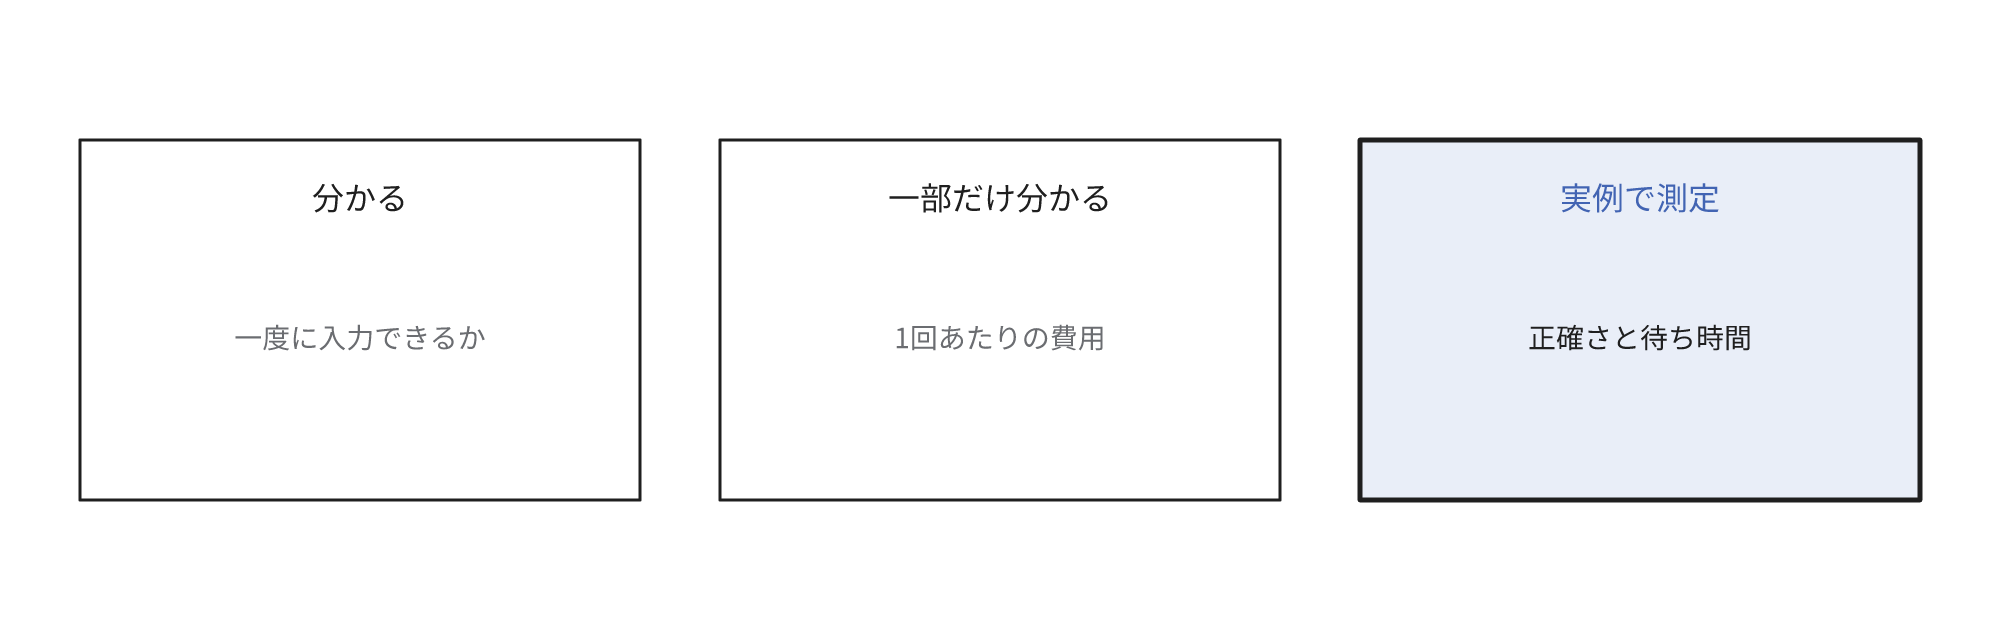
| 確認したいこと | 上限の規模で分かるか | 確認する方法 |
|---|---|---|
| 資料を一度に入力できるか | 分かる | 代表的な資料のトークン数を、提供者が公開している計数の機能で計測する |
| 入力した資料から正確に回答できるか | 分からない | 自社の資料と質問の実例で正答率を測定する |
| 1回あたりの費用 | 一部だけ分かる | 入力のトークン数と単価で計算する。長い入力に割増の単価を設けるモデルもある |
| 応答の待ち時間 | 分からない | 実際の長さの入力で測定する |
資料を入力できるかは、提供者が公開している計数の機能を使用すれば、技術者でなくても見積もりが可能です。
代表的な資料のうち最も長いもののトークン数を計測し、上限から回答と会話履歴の分を控除した残りと比較します。
資料の全体の投入と必要な部分の選択の判断
業務の仕組みへの統合では、必要な部分だけを選択して入力する方法を基本にします。
資料を全部入力する方法は、目安として次の3つを満たす場合に限ります。
資料が上限の半分程度以内であること、処理件数が月に数百件程度以下であること、誤りを人が確認できることです。
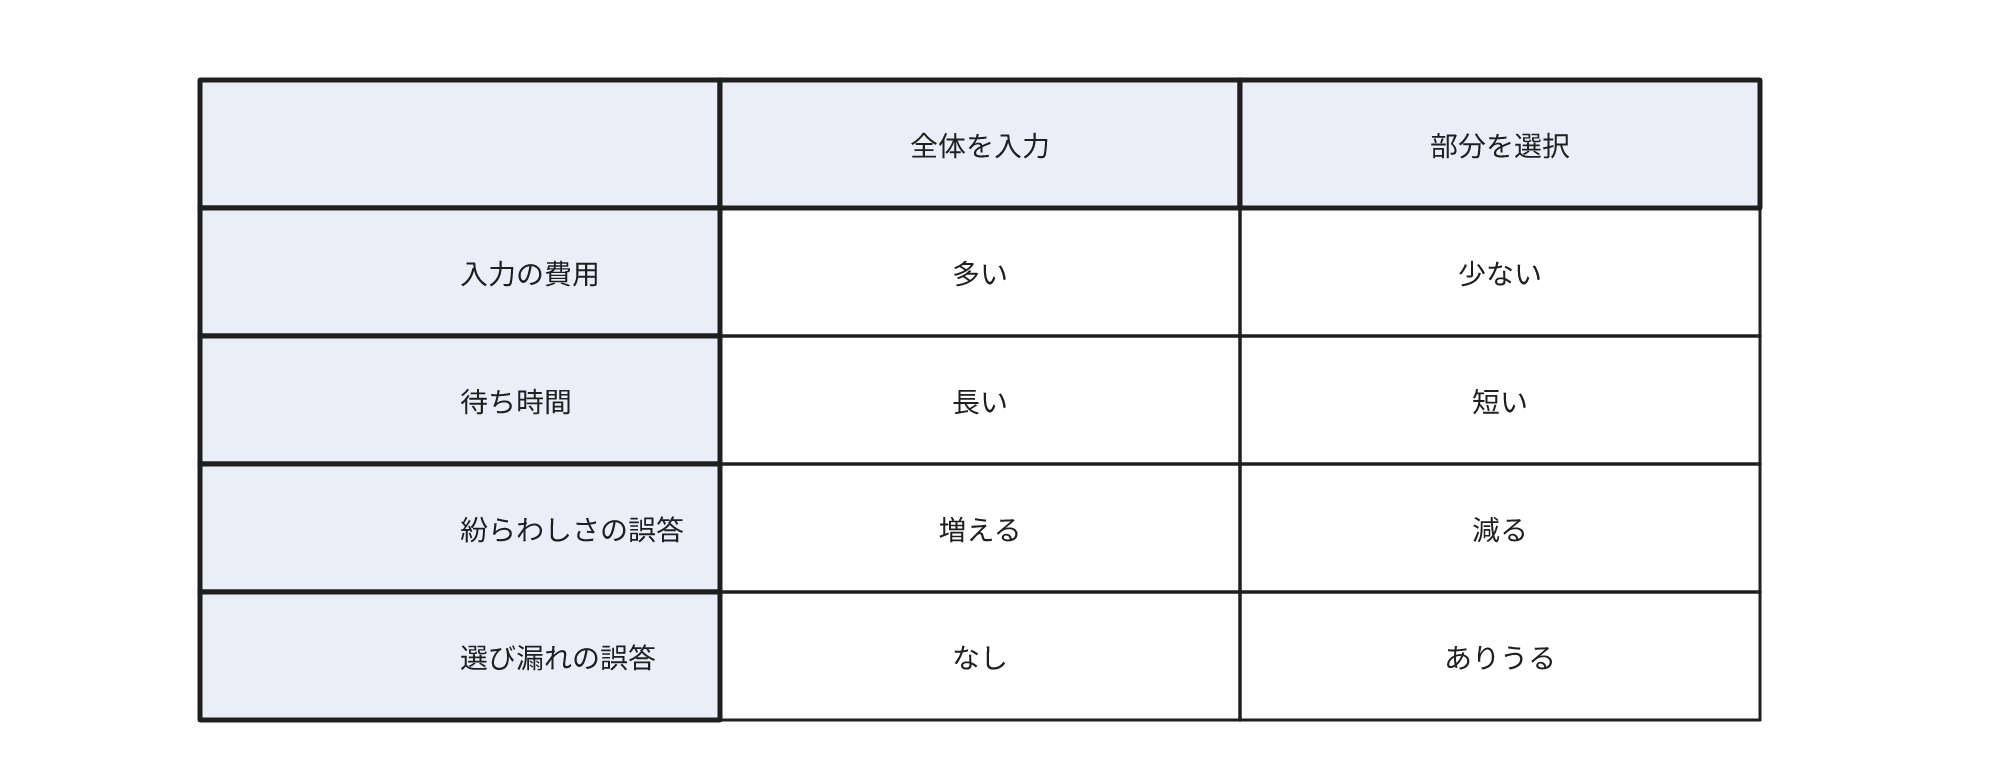
上限の半分としたのは、回答、会話履歴、ツールの結果の分を確保するためと、入力が長いほど費用と誤答が増加するためです。
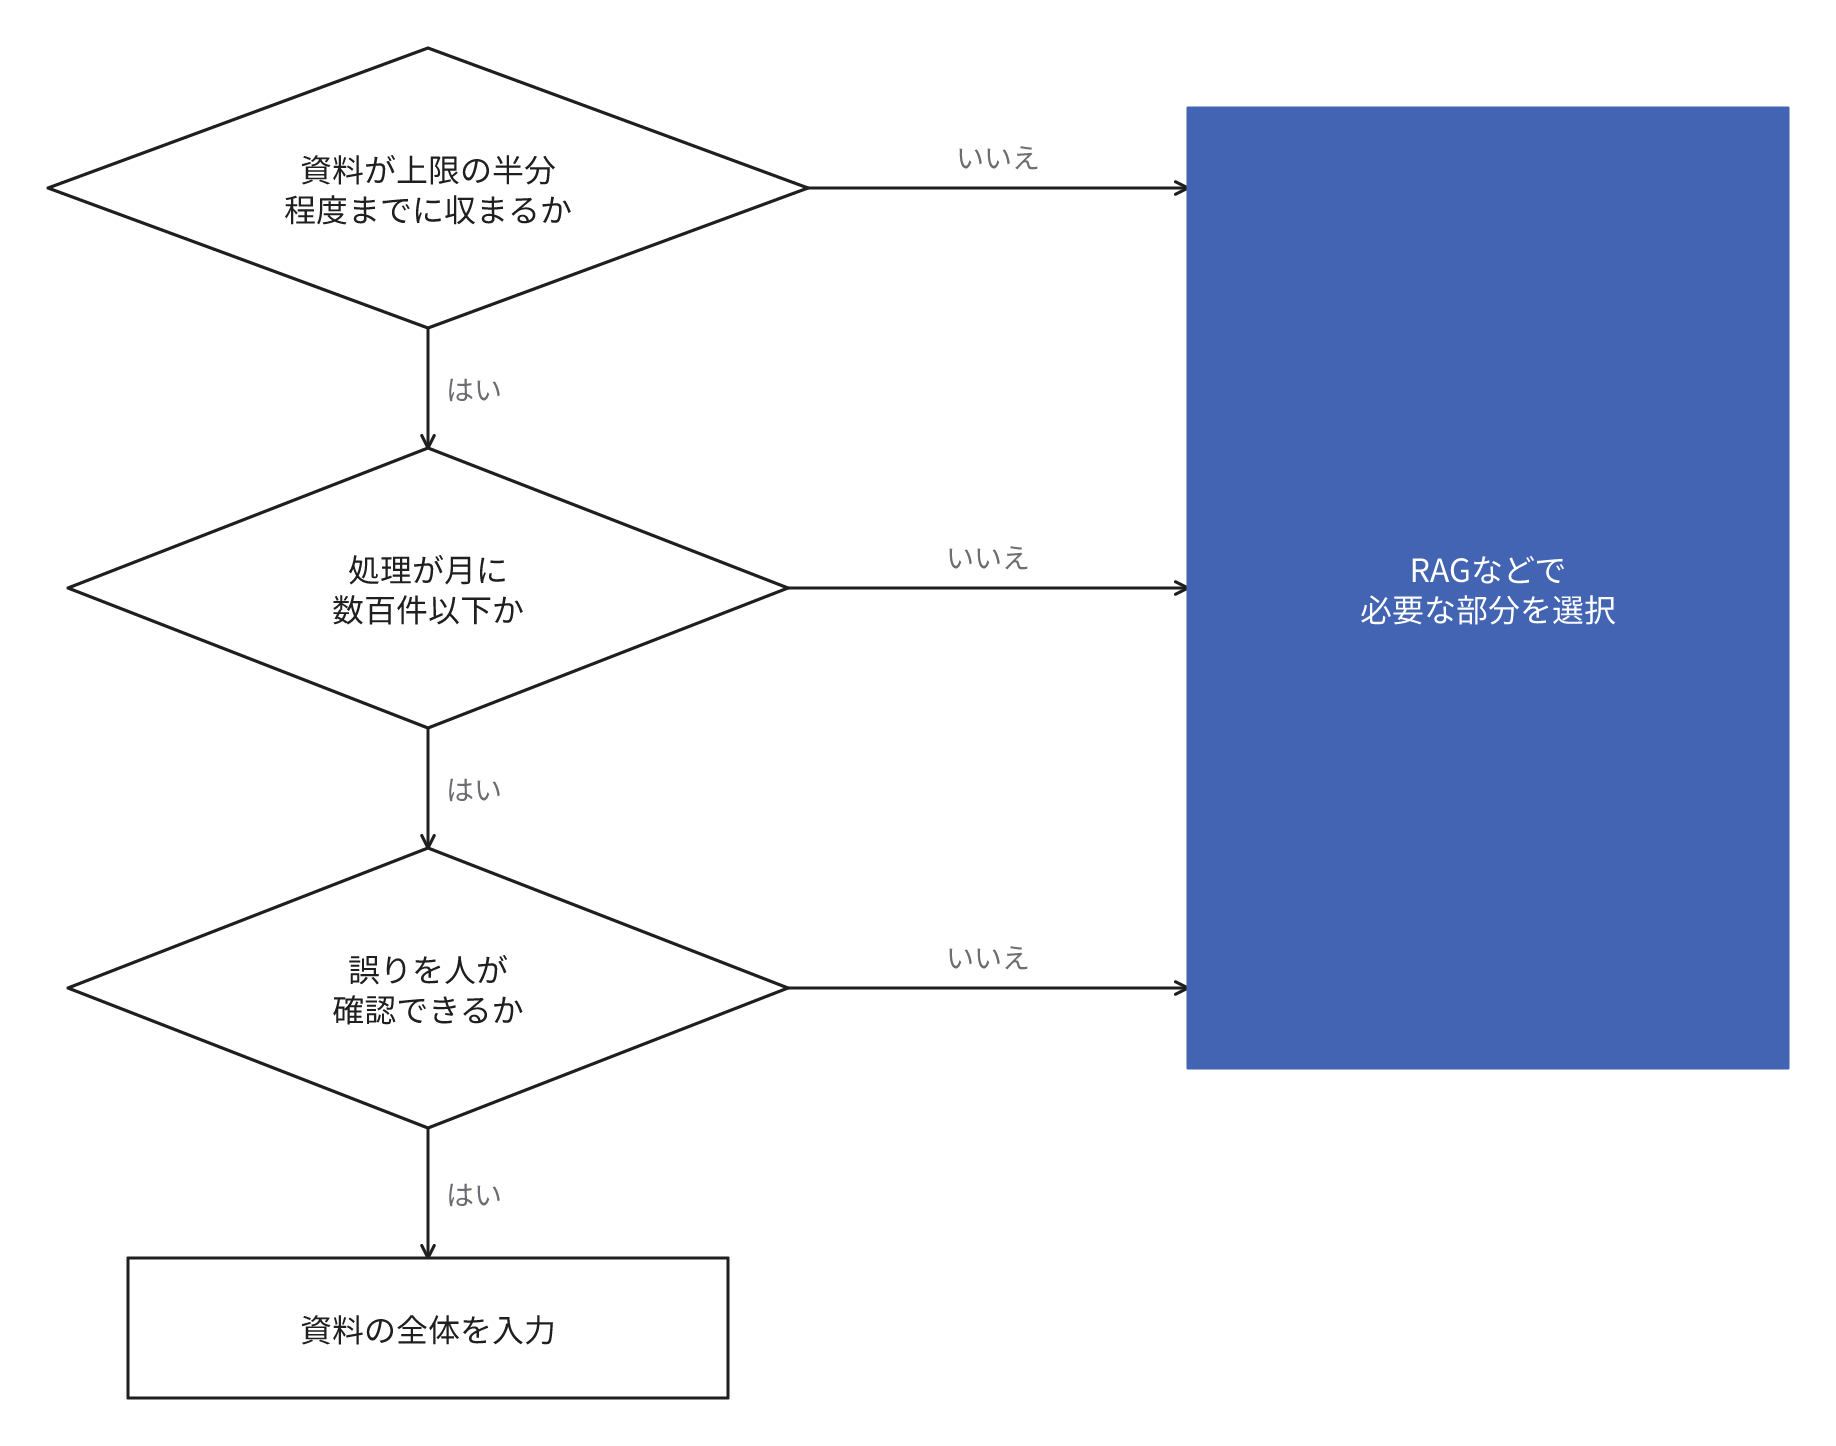
全部入力する方法が適するのは次のような用途です。
- 1件の契約書や報告書の要約や確認事項の抽出
- 資料の全体にわたる矛盾や記載の不足の確認
- 試作の段階での、仕組みの構築前の効果の確認
次のような場合は、質問に関連する文書を検索して入力に追加するRAG(Retrieval-Augmented Generation)などで、必要な部分を選択します。
- 規程やマニュアルが多い
- 同じ種類の質問への日常的な回答に利用する
- 旧版と最新版の文書が混在している
長い会話やAIエージェントの作業では、過去のやり取りを要約して置換する方法もあります。
どちらの方法を採用するかは、自社の資料と質問の実例で、全部入力した場合と必要な部分を入力した場合の正答率と費用を比較して決定します。
コンテキストウィンドウを大量に利用するコストとリスク
- 費用。従量課金では、入力のトークン数に応じて入力の費用が増加する。会話では過去のやり取りも毎回入力として計上される
- 費用の削減策。同じ資料を毎回送信する構成では、入力の先頭の再利用に割引を適用するプロンプトキャッシュが有効な場合がある
- 待ち時間。入力が長いほど、回答の開始までの時間が長くなる傾向がある
- 精度。旧版の文書のような紛らわしい情報が入力に含まれると誤答が増加する
- 情報の管理。不要な機密情報まで入力すると、外部に送信する情報が増加する
- 運用の工数。上限と数え方はモデルや世代によって異なる。モデルを変更するたびに、同じ実例で資料の長さと正答率を再測定する担当者が必要になる
よくある誤解
上限の範囲内なら資料の内容をすべて正確に把握できる
上限は参照できる量の上限で、正確に処理できる量の保証ではありません。
入力が長いほど、また紛らわしい情報が多いほど、必要な情報を回答に反映しないことがあります。
重要な判断に使用する回答は、参照した資料の箇所を示させて人が確認します。
コンテキストウィンドウが大規模ならRAGは不要になる
上限が拡大しても、毎回すべての資料を入力すると費用と待ち時間が増加し、紛らわしい情報による誤答も残存します。
資料が多い業務や日常的に利用する業務では、費用と誤答の両面から、必要な部分を選択して入力します。
会話の前半の内容が回答から欠落するのは性能の低さが原因である
チャットの製品では、上限への接近時に過去のやり取りを参照の対象から除外したり要約したりすることがあります。
長い会話では、必要な前提を整理して新規の会話を開始すると、正確な回答を得やすくなる場合があります。
ただし整理の対象外になった前提は引き継がれないため、重要な条件は新規の会話の最初に明記します。
関連用語
トークン(生成AI)
成熟度:
大規模言語モデル
成熟度:
RAG
成熟度:
エージェントハーネス
成熟度:
ハルシネーション
成熟度:
同じ分野の用語
AI・機械学習の用語をすべて見るお問合せ
事業の課題や技術的な悩みなどどんなことでもお聞かせください