
機械学習とは
機械学習はデータから規則性をコンピューターに学習させ、新規のデータに対して予測、分類、生成などを行わせる技術です。
学習によって得られ、入力データから予測などを出力する数学的な仕組みをモデルと呼びます。
代表例は次のとおりです。
- 来週の販売数を商品ごとに予測する
- 設備のセンサー値から異常を検知する
- 問合せを種別ごとに分類する
- 購入履歴に基づいておすすめ商品を表示する
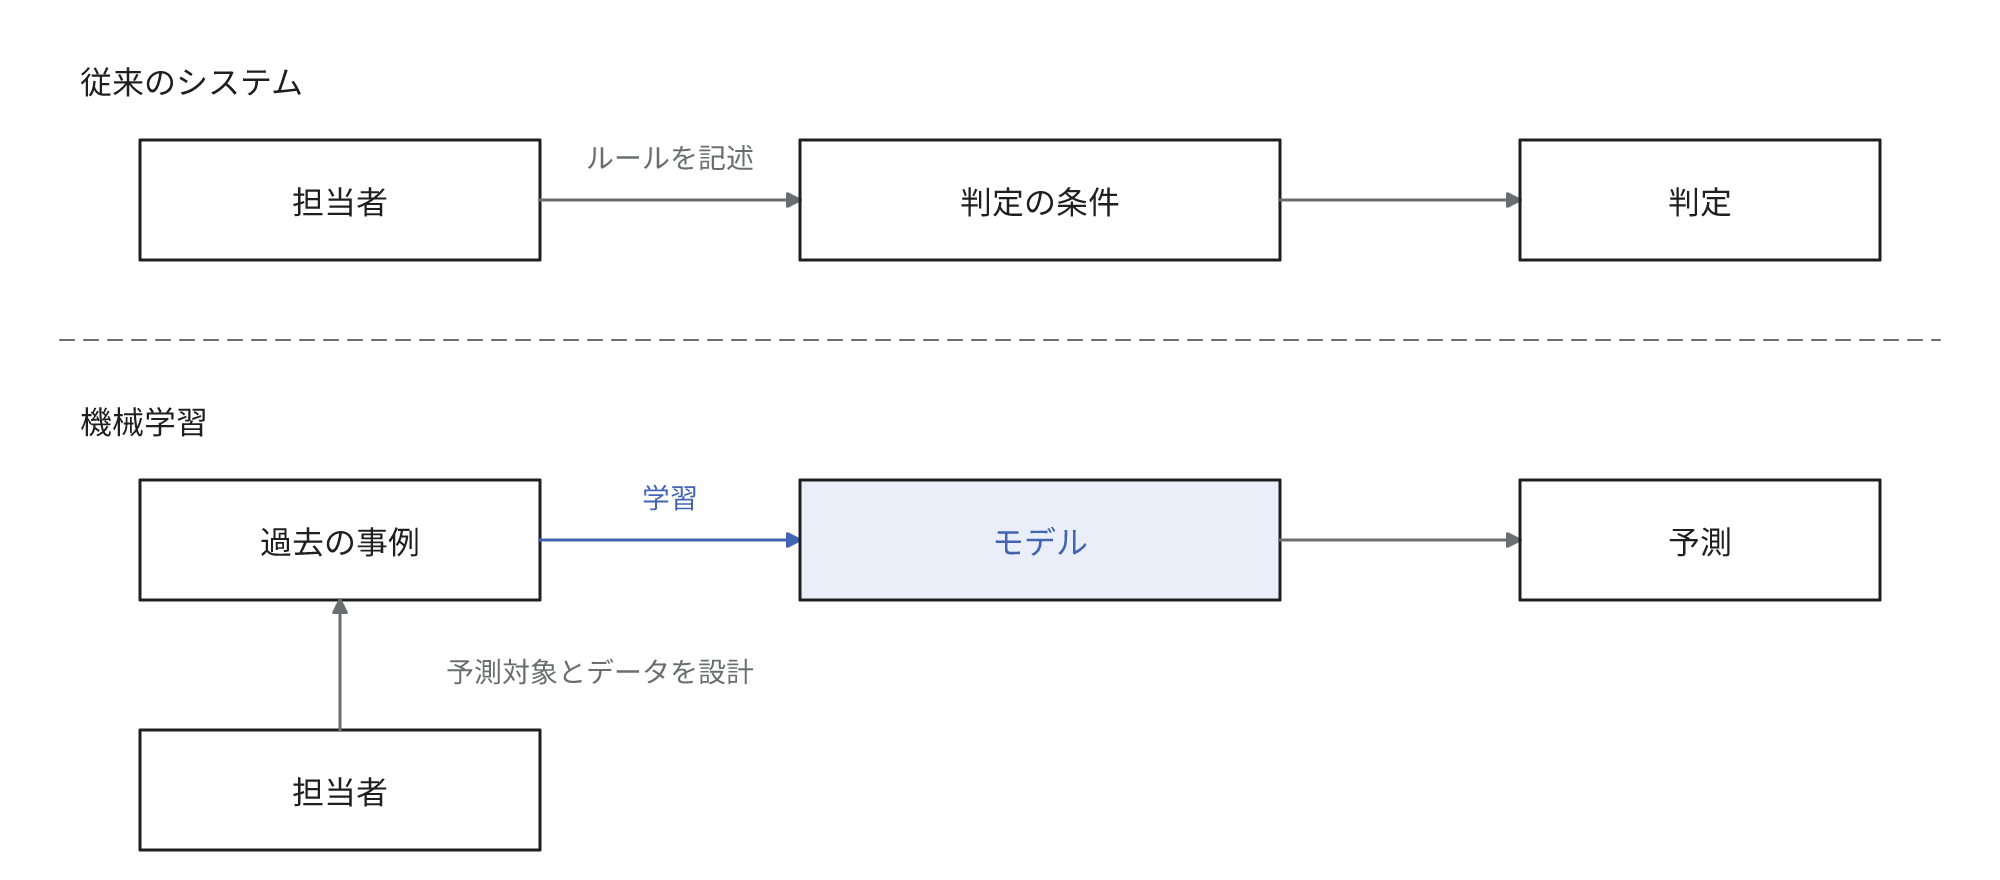
従来のシステムでは人が判定の条件をルールとして記述します。
需要予測などに使用する教師あり学習では、事例と正解の組から関係を学習してモデルを構築し、人は何を予測するか、どのデータを使用するかを設計します。
例えば販売数の予測では予測する単位を商品ごと・店舗ごと・週ごとのどれにするかを決定します。
モデルが予測の手がかりにする項目を特徴量と呼び、曜日、天候、販促の有無のどれを特徴量にするかも設計の対象です。
明文化した条件ではなく過去の事例から予測する点で、経験の長い担当者が言葉にできない勘で売れ行きを予想することに近いです。
勘と同じく、経験したことのない状況では的中するとは限りません。
機械学習のモデルには予測するものだけでなく内容を生成するものも含まれます。
文章や画像を生成する生成AIも機械学習の一分野です。
なぜ必要か
人が条件を記述する方法では、商品や顧客の種類が増加するほど条件と例外は複雑になり、ルールの把握や保守は困難になることがあります。
天候、曜日、販促、価格のように考慮すべき要因が多い需要予測では、ルールだけでは十分な精度を確保できない場合があります。
機械学習は条件を過去のデータから導出するため、判定の条件を1つずつ人が記述する作業を削減できます。
使用するデータや業務上の制約の見直しは引き続き人が担います。
ルールが複雑になり保守が困難になった段階で、学習に使用できるデータと予測の目的が明確なら機械学習へ移行します。
正解データとデータの質
事例となるデータと、それに対応する正解の組を学習する方法を教師あり学習と呼び、需要予測や分類でよく使用されます。
正解を付与せずに学習する方法は教師なし学習と呼びます。
類似する顧客をグループに分割するクラスタリングや、普段と異なる動きを検出する異常検知が代表例です。
教師あり学習では正解を用意できるかで進め方が決定されます。
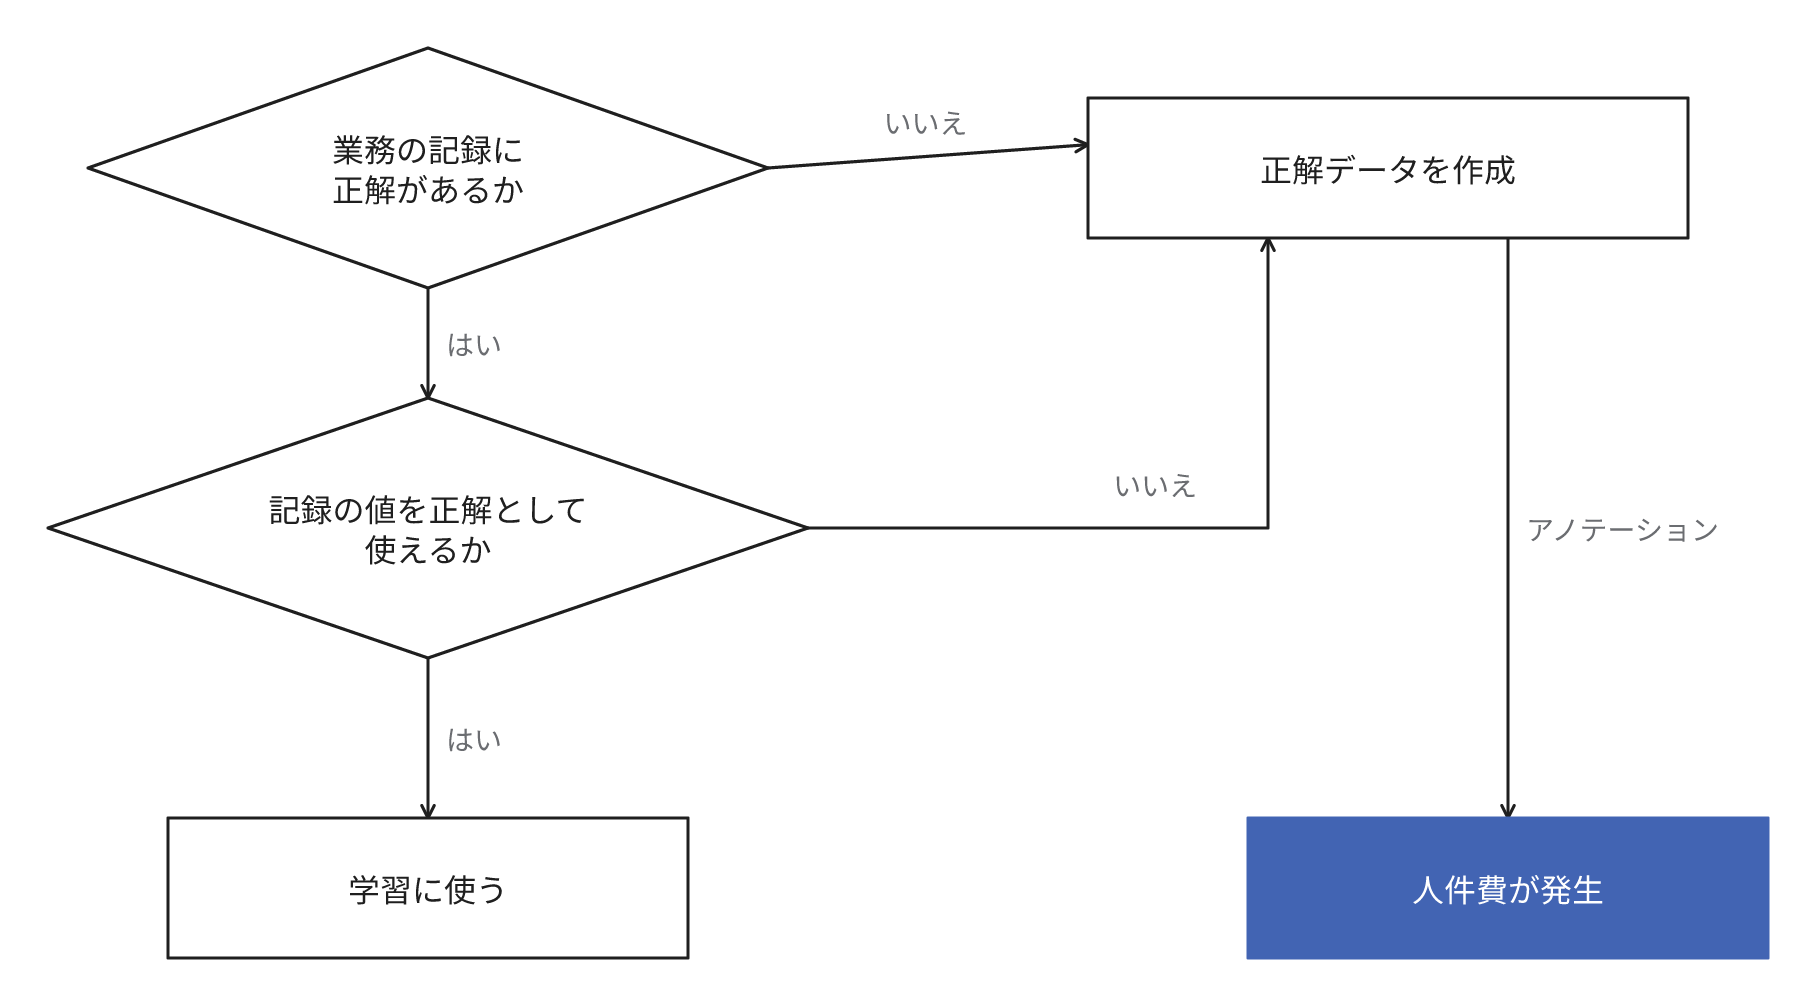
実際の販売数や、不正と確定した取引のように正解が業務の記録に存在すれば学習に利用できます。
ただし欠品した日の販売数が需要より少ないように、記録の値が予測したいものと一致するかは確認が必要です。
記録に正解がなければ学習の前に正解データを作成します。
担当者が事例ごとに正解を付与する作業をアノテーションと呼び、その人件費が発生します。
精度は量と質の両方に左右されます。
モデルは正解と一致するよう条件を調整するため、正解データの誤りが少数の割合を超えると予測の質は低下し、データは実際の状況を代表している必要があります。
精度の評価
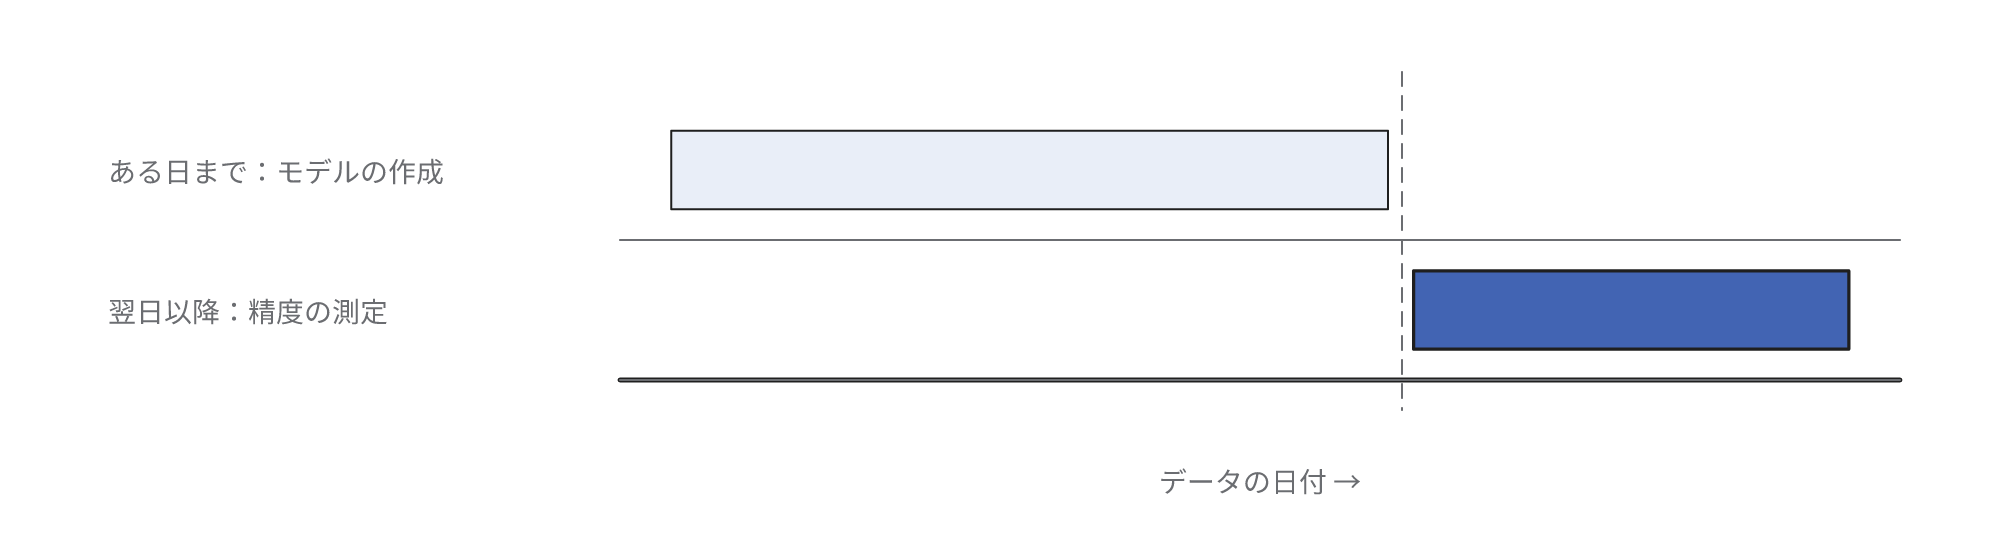
精度は学習に使用していないデータで測定し、このデータをテストデータと呼びます。
学習に使用したデータで測定すると高い値になることがあり、本番の性能の評価には利用できません。
時期によって傾向が変化する予測では、ある日までのデータで作成したモデルを翌日以降のデータで検証します。
期間を分割するだけでは本番の性能を適切に評価できないことがあります。
次の点も確認します。
- 予測する時点で入手できない情報を学習に使用していない。翌月の解約の予測に、解約手続きの後に記録される項目を含めない
- 新規の顧客や案件への予測性能を測定するなら、顧客や案件の単位で学習用と検証用を分割する。同じ顧客の将来を予測するなら、本番の運用と同様に時期で分割する
- 学習時と本番でデータの加工方法が同じである
数値の良さだけでは業務の価値は分かりません。
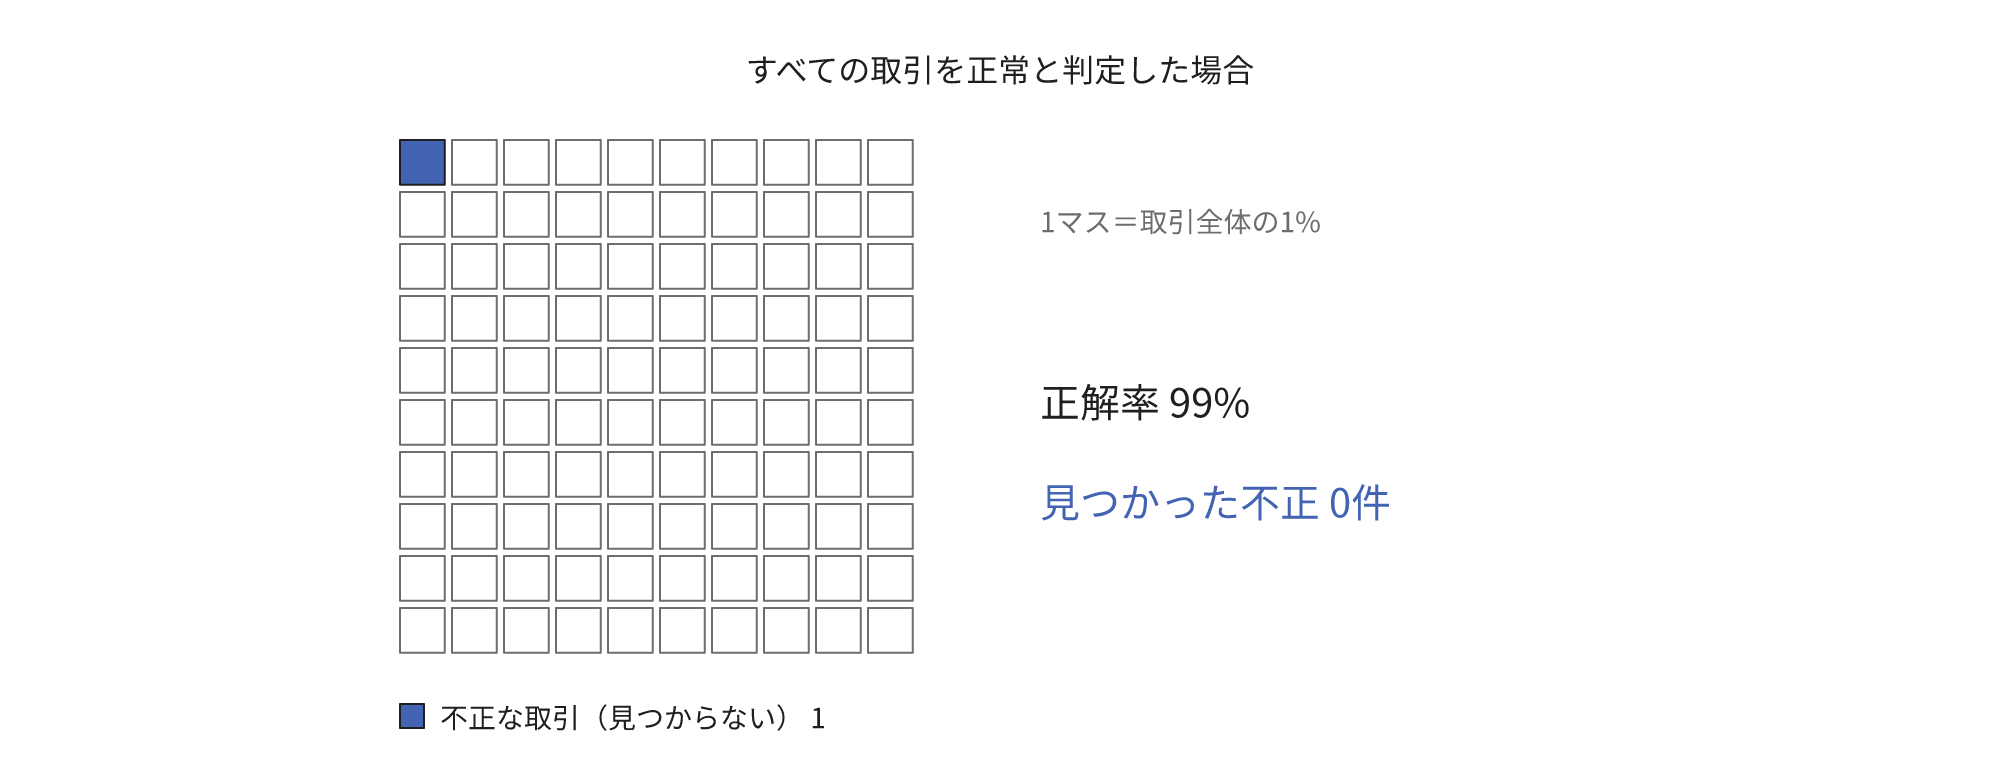
不正な取引が全体の1%なら、すべてを正常と判定するだけで、判定が正解と一致した割合である正解率は99%になり、不正は1件も検出されません。
偏りのあるデータでは不正のうち検出した割合である再現率のような正解率以外の指標を使用します。
判定のしきい値を低くして不正の判定を増加させると、不正の見逃しは減少する一方で、正常な取引を停止する件数は増加する傾向にあります。
見逃しによる損失と、正常なのに停止した取引の確認工数のどちらが高くつくかでしきい値を設定します。
需要予測では予測誤差を欠品による販売機会の損失と、過剰在庫の廃棄や保管の費用に換算して評価します。
運用中の精度低下と再学習
顧客層、商品構成、価格、制度の変化によって、学習時の傾向と現在の状況は乖離し、精度の低下を招くことがあります。
学習時と運用時でデータの傾向が乖離する現象をドリフトと呼びます。
学習データが運用時の状況から乖離して陳腐化することは、従来のソフトウェアにはなかった、または従来より増大したリスクの1つです。
データやモデルの変化で保守が頻繁に必要になることも、従来のソフトウェアより増大したリスクです。
稼働中は予測と実績の差を監視します。
不正の確定や解約のように正解の判明に時間がかかる予測では、その間は入力データの傾向の変化を監視します。
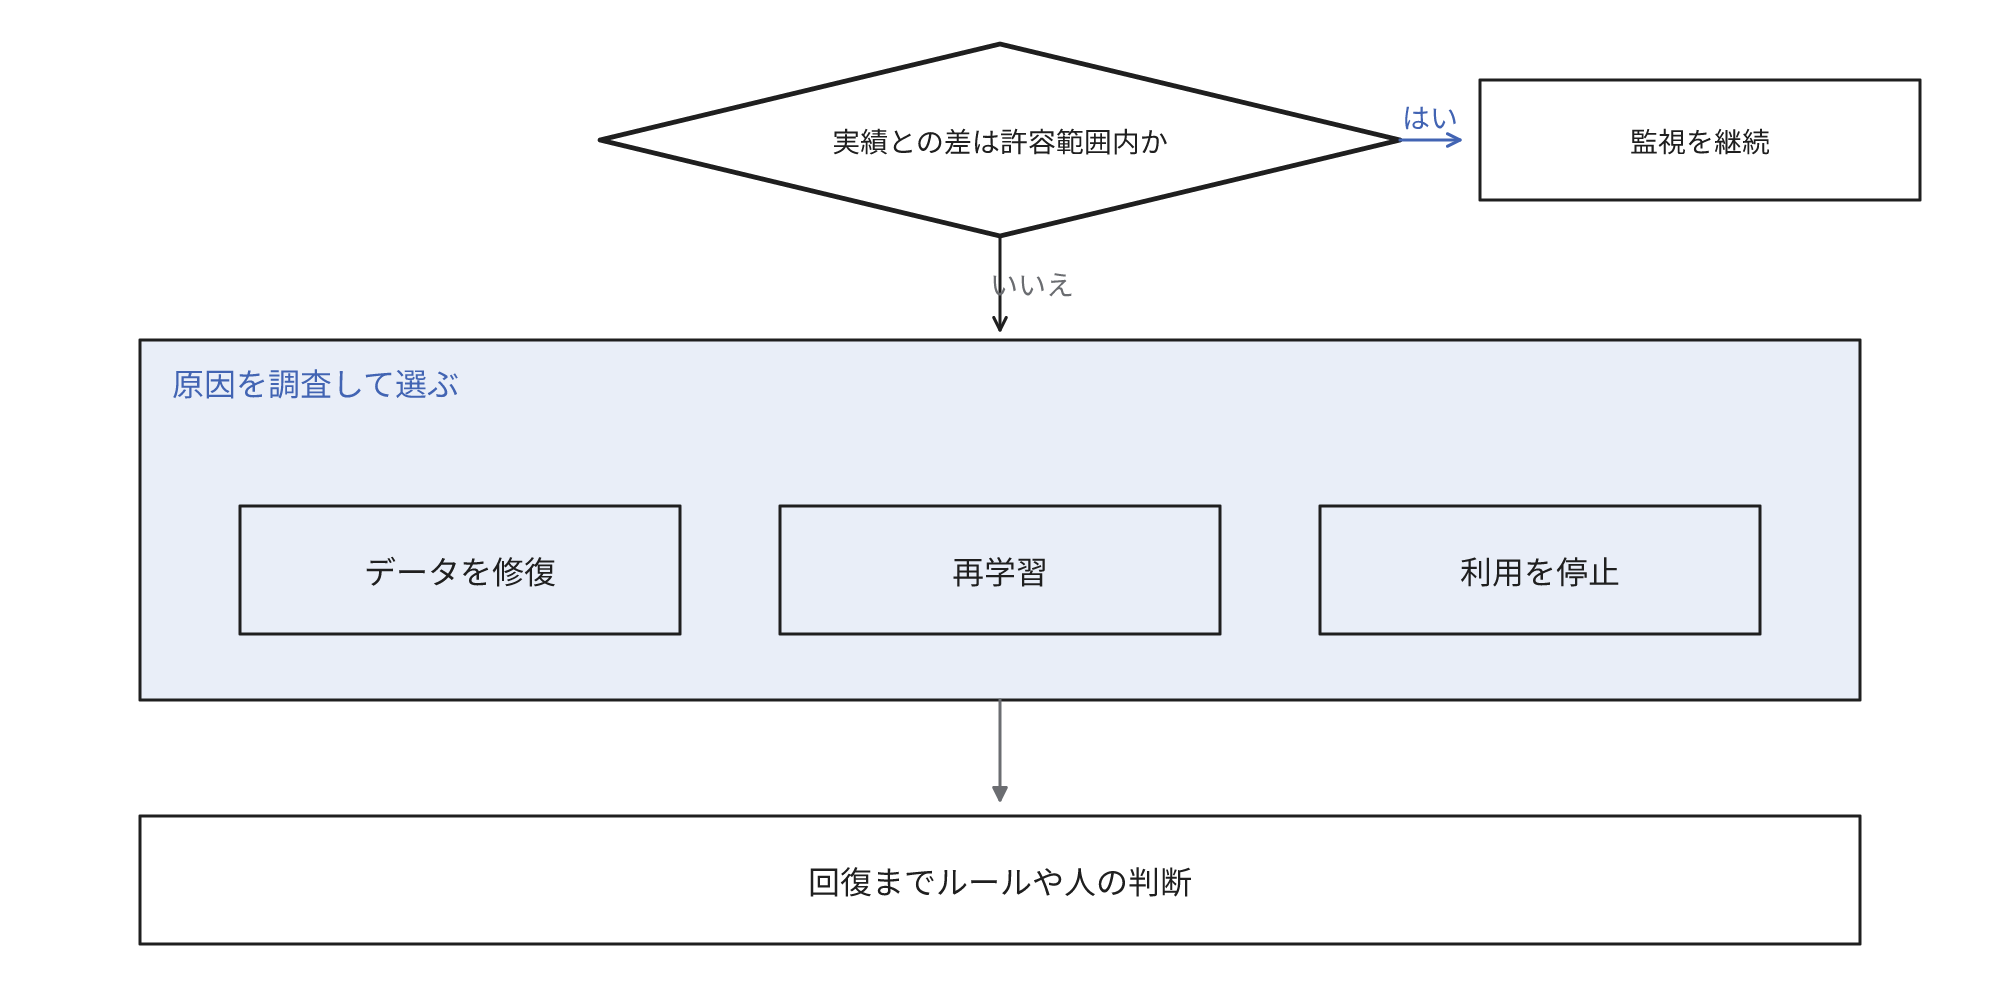
差が許容範囲を超えたらまず原因を調査します。
入力データの欠損や連携の停止は再学習では解消しないため、データの修復、再学習、利用の停止を原因に応じて選択します。
再学習後のモデルもテストデータで検証してから既存のモデルと交換し、精度が回復しない間は既存のルールや人の判断による運用に移行します。
監視の頻度は予測の誤りによる損失の規模と業務の変化の速度で決定し、再学習の頻度とは別に決定します。
新商品の発売や前例のない規模の販促、災害のような、学習データに前例のない条件の時期は、通常時の検証結果をそのまま適用できません。
人が予測を補正する条件や、モデルを使用しない期間を事前に決定しておきます。
効果
- 人が書き切れない数の条件が関係する判定を自動化できる
- 担当者の勘に依存していた予測を数値で示し、仕入れや人員配置の量を決定する材料にできる
- 担当者が交代しても同じ基準で判定が継続する
- 大量の取引や画像を全件確認せず、疑わしいものだけを人が確認する運用にできる
コストとリスク
- データの整備。欠損、表記揺れ、部署ごとに異なる定義を統一する作業は、モデルの作成に匹敵する主要な費用項目である
- 正解データの作成。業務の記録に正解がなく、担当者が事例ごとにアノテーションするなら、その工数がかかる
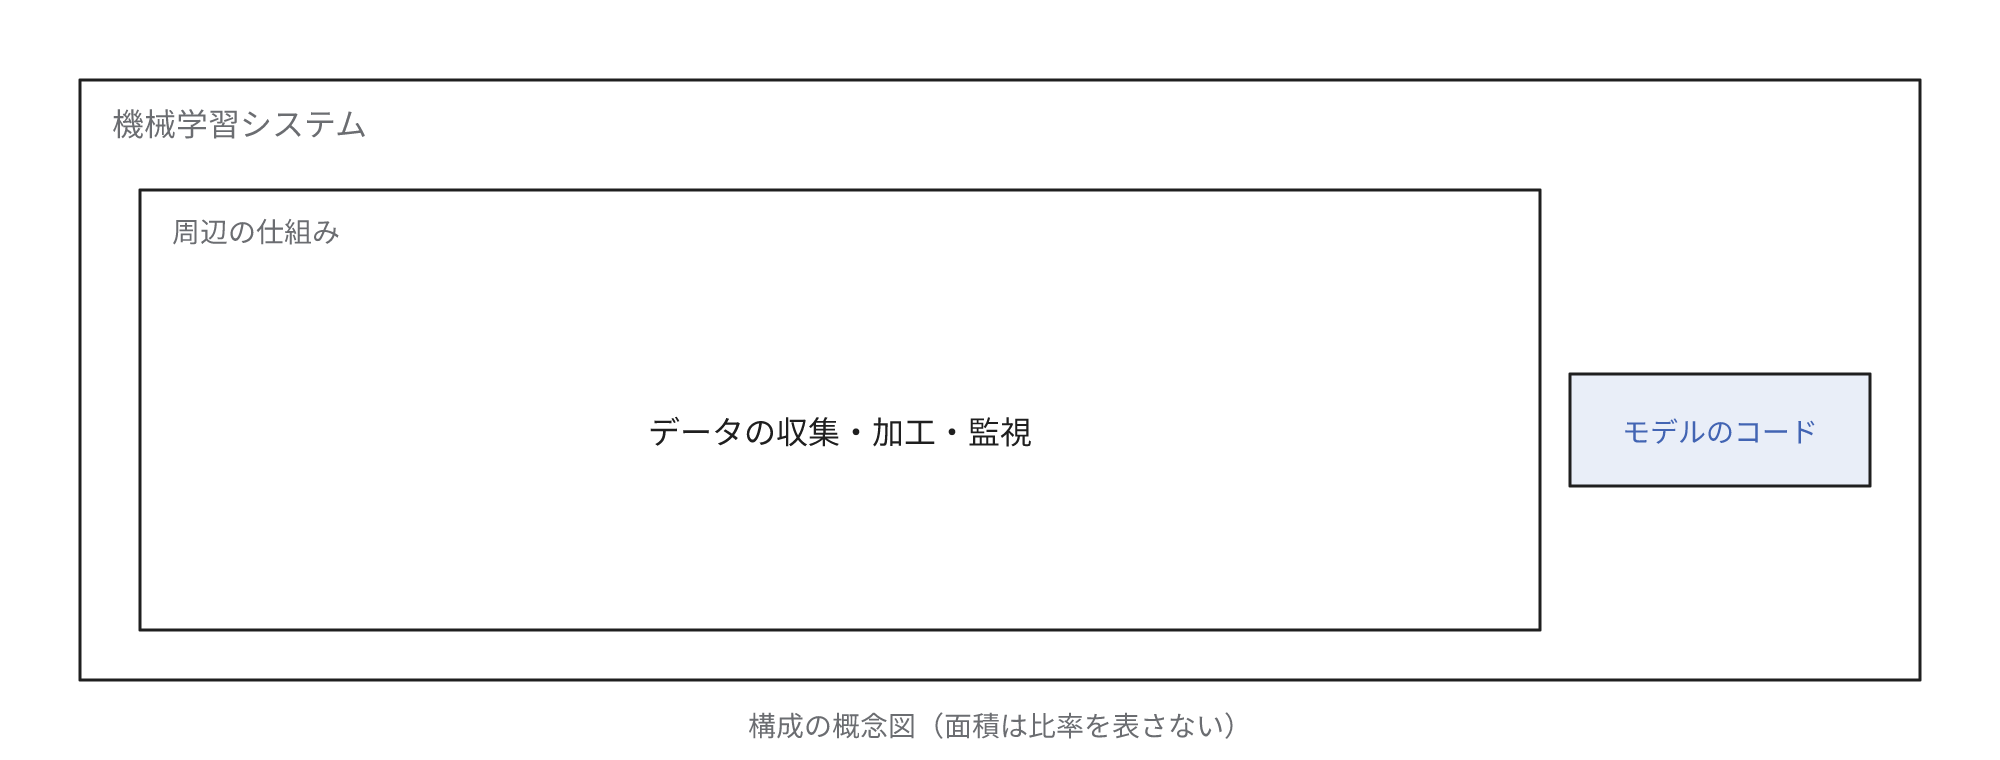
- 周辺の仕組みの保守。実際のシステムのうちモデルのコードはごく一部で、データの収集・加工・監視などを担う周辺基盤は広範で複雑である
- 監視と再学習の担当者。予測と実績の差の確認と原因の調査は稼働している限り続き、引き継ぐ担当者がいなければ、必要な更新や障害対応は停滞するおそれがある
- 偏りの再現。過去の判断の偏りが学習データに含まれていると、モデルがその偏りを再現するおそれがある。学習データの質を管理する措置が事業者に求められている
- 判定理由の説明。与信や採用のように理由の説明が必要な判定では、説明しやすいモデルを選択するか、別に説明の手段を用意する
予測用のモデルを構築するかどうかを決定する
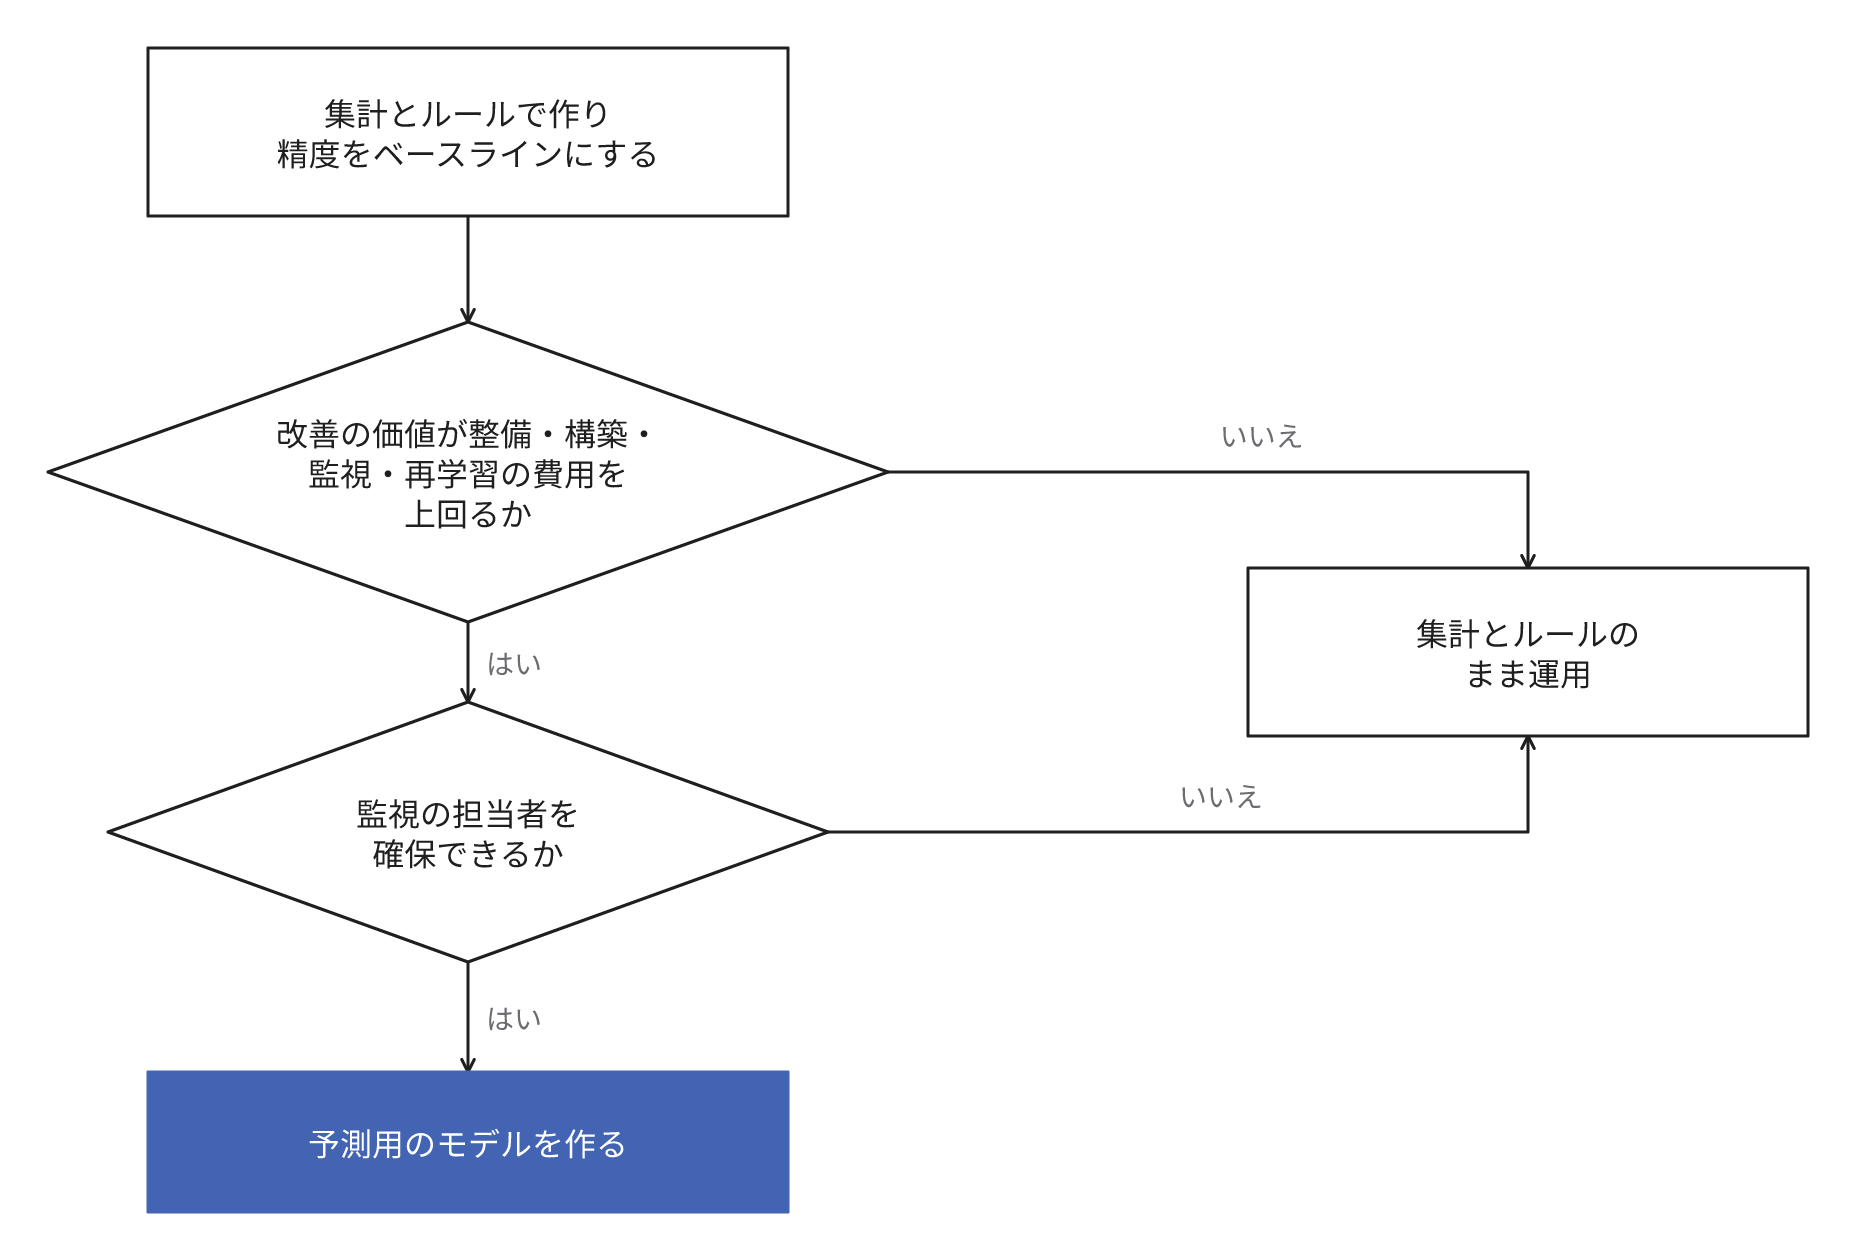
まず集計とルールで予測の仕組みを構築し、機械学習を使用しないこの解決策を先に最適化して、その精度をベースラインにします。
機械学習のモデルを構築するのは、ベースラインより改善する分の価値が、データの整備、構築、監視と再学習にかかる費用を上回り、監視の担当者を確保できるときです。
採算は次の2つの差で決定されます。
- 改善の価値: ベースラインに対する予測の改善で減少する損失。需要予測では欠品と廃棄の減少額
- 費用: データの整備と正解の作成、構築、監視と再学習の人件費、計算資源の費用
たとえば月に1,000件の判定で1件あたりの損失が平均数百円減少するなら、改善の価値は月に数十万円という目安になります。
改善の価値から、毎月の監視と再学習の人件費と構築費の回収分を控除した額が正であるかを確認します。
1件あたりの損失は業務ごとに過去の実績から見積もります。
次のどちらかに該当するなら機械学習が不要なので、予測用のモデルを構築せず、集計やルールのまま運用します。
- 前年同月の実績や直近数週間の平均で予測しても、予測誤差が業務上許容できる
- 判定の条件を規程として管理でき、例外の追加と保守が機能している
予測と実績の定期的な確認や異常時の対応を担う体制を確保できないなら、改善の価値が費用を上回っても予測用のモデルを構築せず、集計やルールで運用します。
既存の生成AIで十分な用途では、予測用のモデルを構築せず既存の生成AIを利用します。
文章の分類や要約は予測用のモデルを新規構築せずに既存の生成AIで試行できます。
特に文章の分類では生成AIのうち大量の文章で学習した大規模言語モデルが、専用に学習したモデルより良い結果になることが多くあります。
一方、売上や在庫、センサー値のような表形式のデータから数値を予測する用途では、予測用のモデルを構築するのが一般的です。
季節の変動が関係する予測では、年の周期を複数回含むデータで検証できるかを確認します。
予測したい値と判定の結果をまだ記録していないなら、手段を選択する前に記録を開始します。
お問合せ
事業の課題や技術的な悩みなどどんなことでもお聞かせください