
推論モデルとは
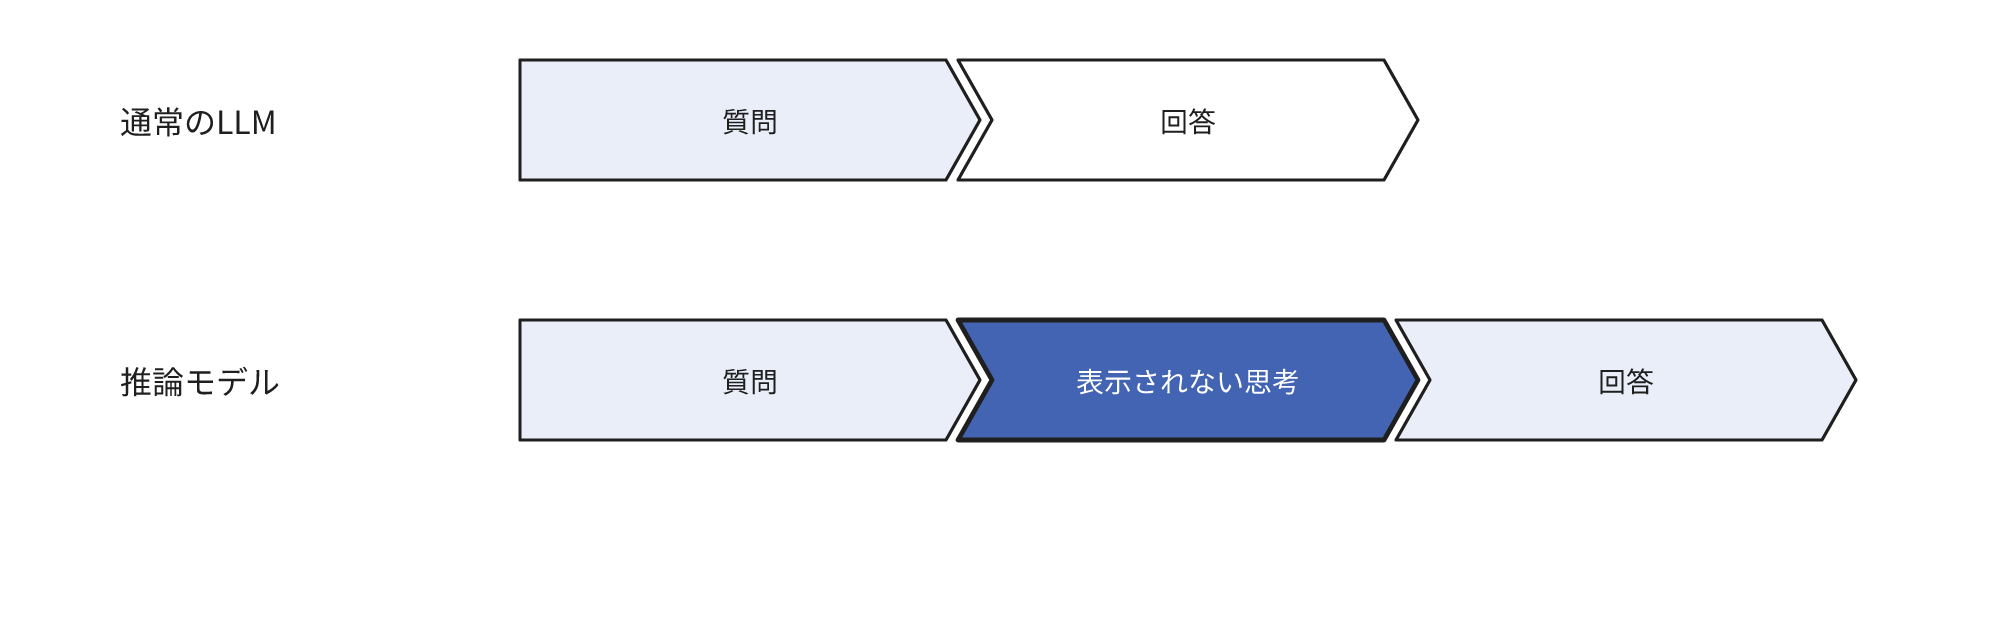
推論モデルは、回答の前に内部で思考の過程を生成してから回答するLLM(Large Language Model、大規模言語モデル)です。
推論モデルは回答の前に内部で推論用のトークン(思考)を生成し、問題を分解して複数の解き方を検討します。
通常のLLMは質問に対して回答の生成をすぐに開始することが多く、推論モデルは計算の手順の確認や、別の方法での検算の後に回答します。
たとえば、複数の拠点の在庫と配送の条件を入力し、来月の発注量の案を作成させるとします。
通常のLLMは、もっともらしい数字をすぐに出力することがあります。
推論モデルは条件を整理し、拠点ごとに計算し、条件への違反がないかを確認してから回答します。
時間はかかりますが、計算の誤りの削減が期待できます。
暗算で即答する人と、メモに記録しながら検算して回答する人の違いに相当します。
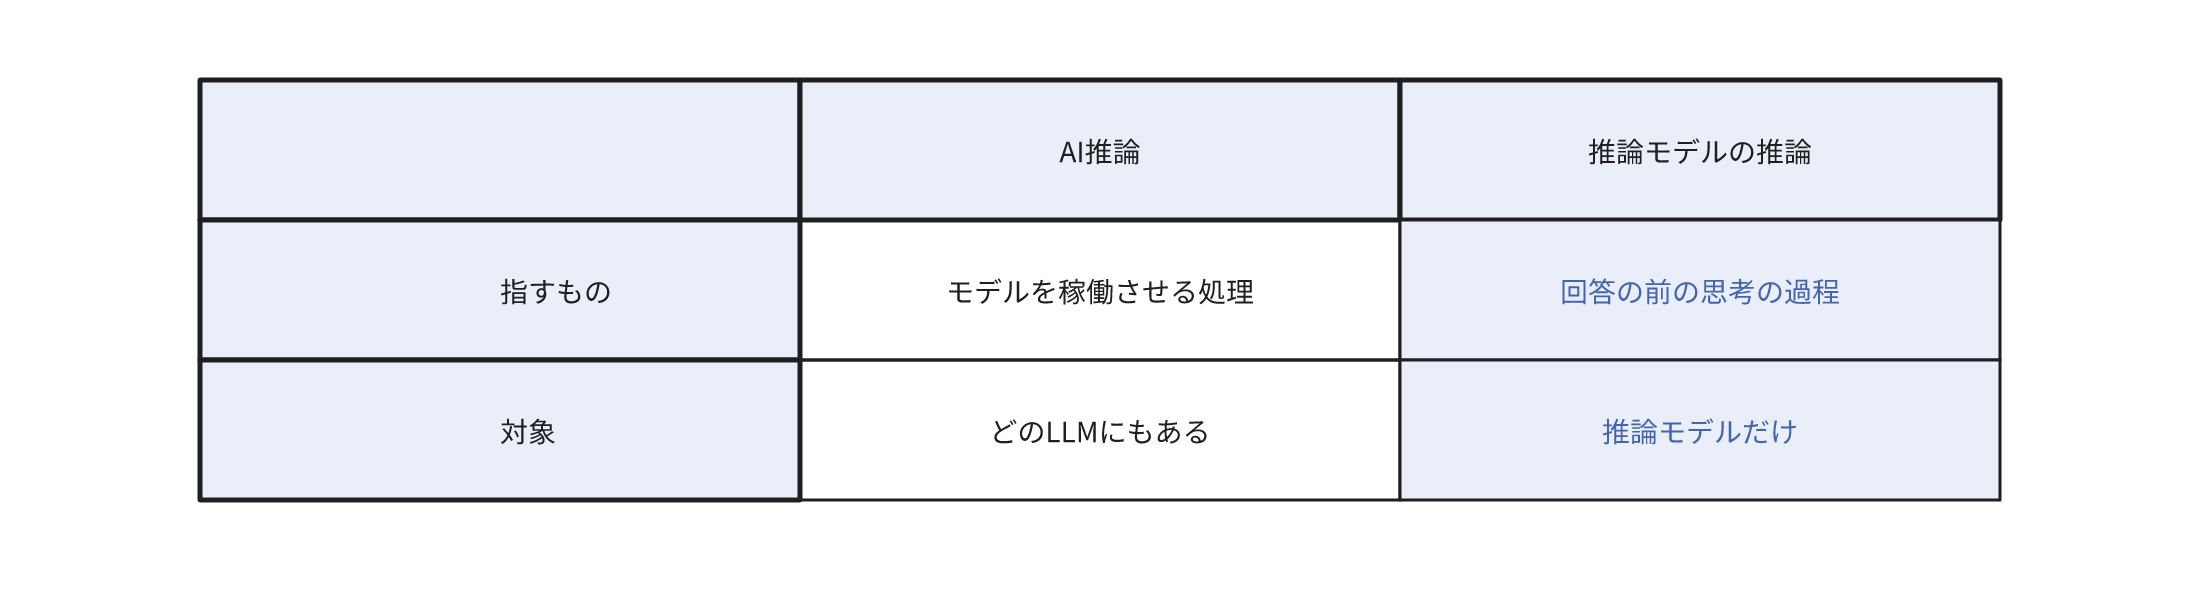
AI推論という語は、学習済みのモデルを稼働させて出力を得る処理そのものを指します。
日本語ではどちらも推論ですが、推論モデルの推論は回答の前の思考の過程のことで、AI推論とは意味が異なります。
2026年11月時点では、OpenAI、Anthropic、Googleの主要なモデルの多くが、1つのモデルの中で思考の量を調整できる形で提供されています。
設定の名前は提供者ごとに異なり、low、medium、highのような段階や、思考に使用するトークン数の予算で指定します。
思考を停止できず、最小の量までしか削減できない主力のモデルもあります。
そのため実務では、推論モデルを利用するかではなく、作業ごとに思考の量を設定します。
推論モデルが登場した理由
通常のLLMは、複数の手順を要する計算や計画で、途中の誤りを認識しないまま回答することがありました。
質問に段階的な思考を求める指示を付記すると正確さが向上する場合があることは、Chain-of-Thoughtと呼ばれる手法の研究で示されていました。
推論モデルは、回答の前に思考の過程を生成するよう、強化学習などで訓練したモデルです。
推論モデルの効果とコスト・リスク
効果
- 複雑な計算、プログラムの作成、多段の計画、曖昧な条件からの判断で、正確さが向上することが多い
- 思考を有効にすると、段階的な思考を指示しなくても思考の過程の後に回答を生成する。ただし簡単な質問では思考を省略するモデルもある
- AIエージェントでは、次に実行する作業の計画を担当する役割に適する
コストとリスク
- 待ち時間。思考の量に応じて、回答の受信までの時間が長くなる
- 費用。思考のトークンは、画面に表示されなくても出力として課金される。OpenAI、Anthropic、Googleの料金表では出力の単価は入力より高く、OpenAIの説明では1回の思考に使用するトークンは数百から数万になる
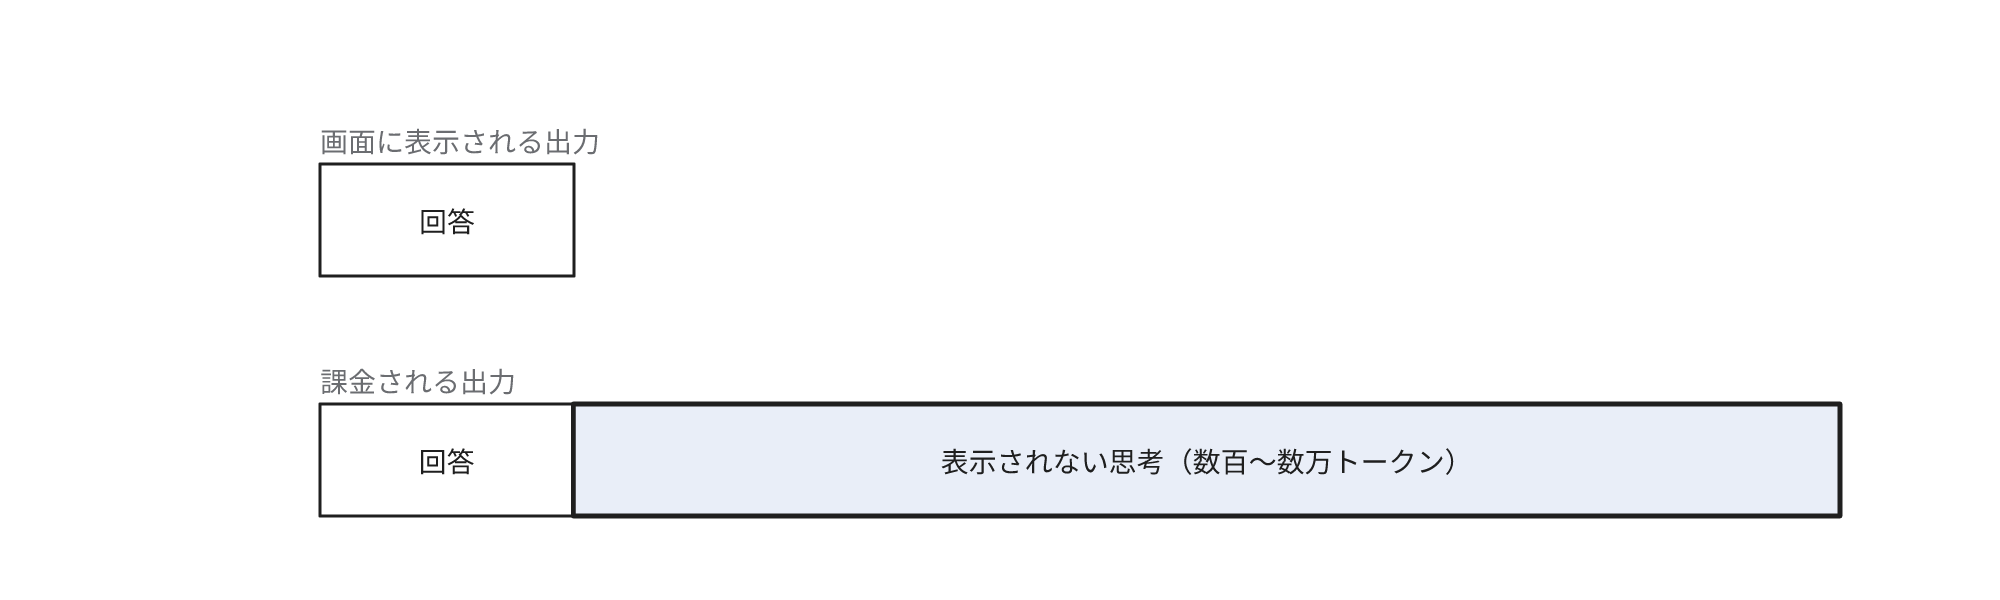
- 回答のない課金。思考の途中で出力の上限に到達すると、表示される回答がないまま、入力と思考の分が課金されることがある
- 簡単な作業での無駄。簡単な質問にも長時間思考し、費用と時間だけが増加することがある
- 費用の予測の困難さ。思考の量は質問によって変化するため、1件あたりの費用にばらつきが生じる
- 思考の表示の限界。AnthropicやOpenAIの製品が表示する思考は要約で、OpenAIも生の思考を公開していない
費用の上振れには、出力の上限と思考の量の設定で対処します。
上限への到達時に回答が途中で終了するのか、回答がないまま終了するのかは提供者ごとに異なるため、試行で確認します。
作業ごとの思考の量の決定方法
思考は、正答率の差で費用と待ち時間の増加を正当化できる作業にだけ使用します。
定型の分類、抽出、短い要約、所定の形式への書き換えは、思考を最小にします。
Googleは、事実の取得や分類には最小の思考を、高度なコード、数学、多段の計画には最大の思考を推奨しています。
OpenAIも、下書きや顧客対応の対話を少ない思考の量の用途に例示しています。
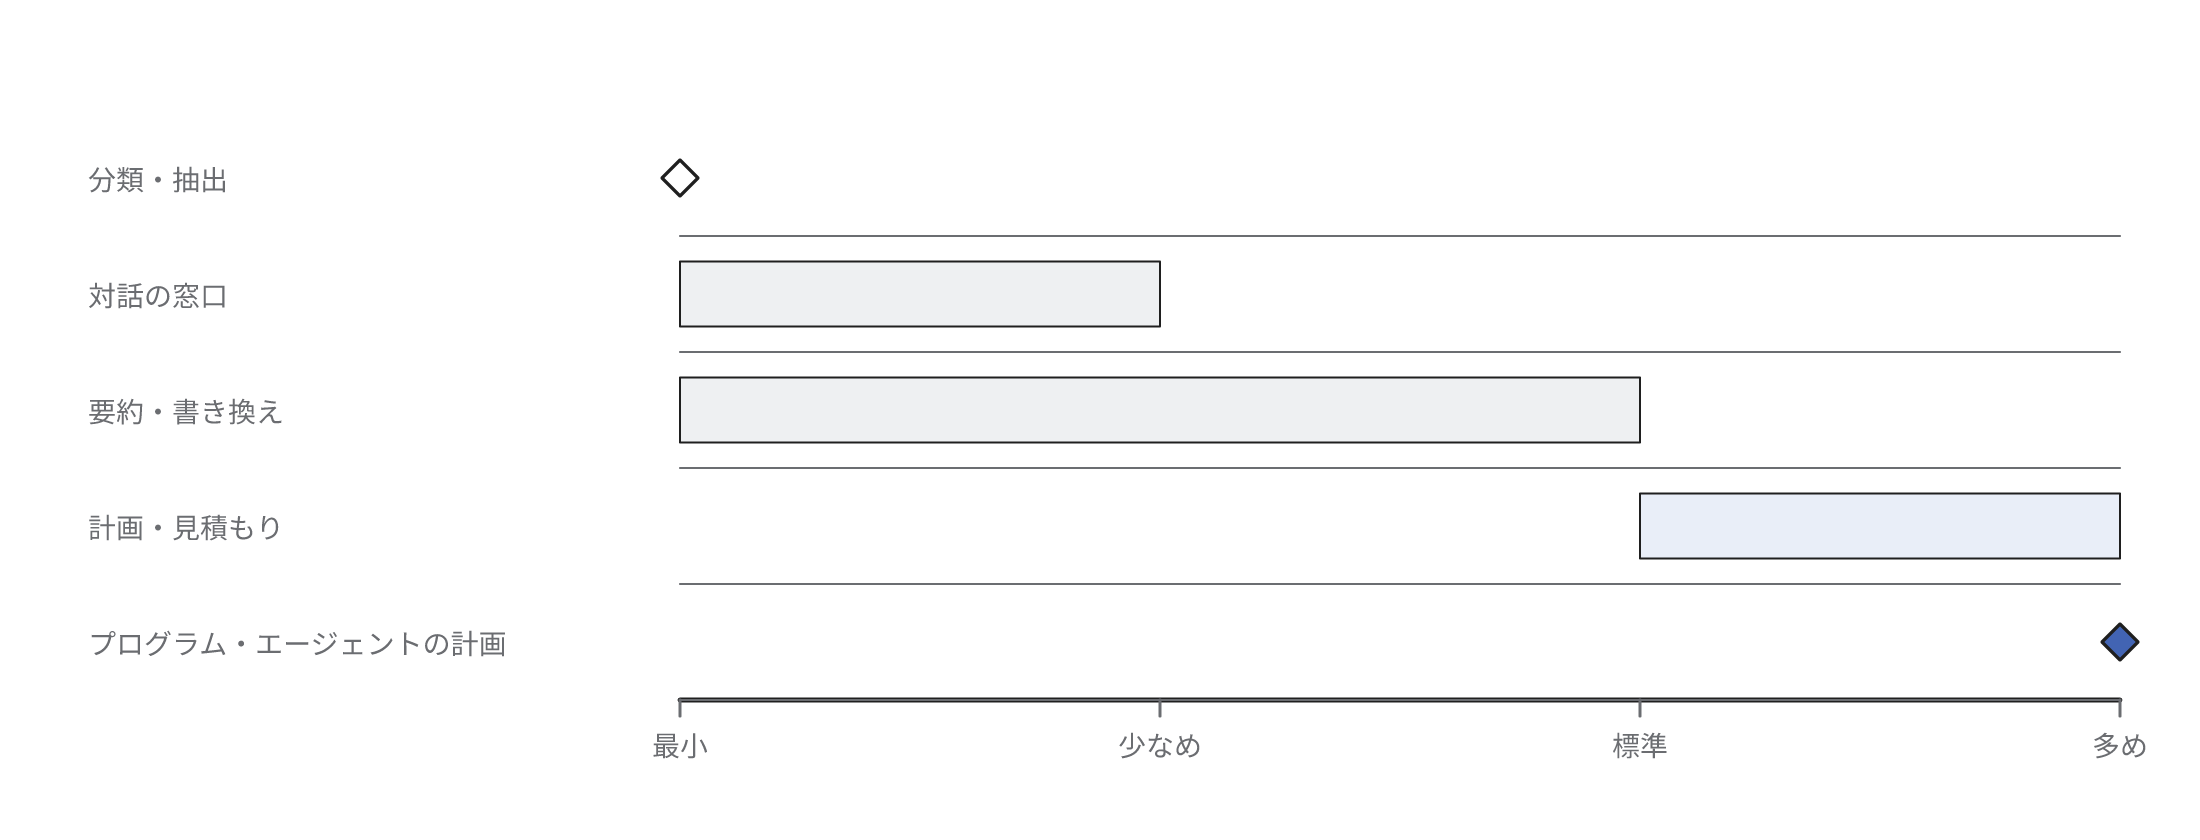
| 作業の例 | 思考の量 | 理由 |
|---|---|---|
| 問合せの分類、文書からの項目の抽出 | 最小 | 件数が多く、費用の差が増大する |
| 会議の要約、文章の書き換え | 最小から標準 | 正確さは入力した資料の内容に依存し、思考の増加による差は僅少なことが多い(目安) |
| 複数の条件を満たす計画、見積もりの計算 | 標準から多め | 途中の計算と条件の確認で誤りが減少しやすい |
| プログラムの作成と修正、AIエージェントの計画 | 多め | 手順が多く、途中の誤りが後の手順に影響する |
| 顧客が応答を待機する対話の窓口 | 最小から少なめ | 待ち時間が利用者の体験に直結する |
目安として自社の作業の実例を数十件用意し、思考の量を変更して正答率、1件あたりの費用、待ち時間を比較します。
その比較の結果に基づいて、正答率の改善が費用と待ち時間の増加を正当化できる範囲で、最小の思考の量を採用します。
OpenAIは、xhighのような多い思考の量について、評価で明確な効果があり、追加の待ち時間と費用を正当化できる場合にだけ使用するよう推奨しています。
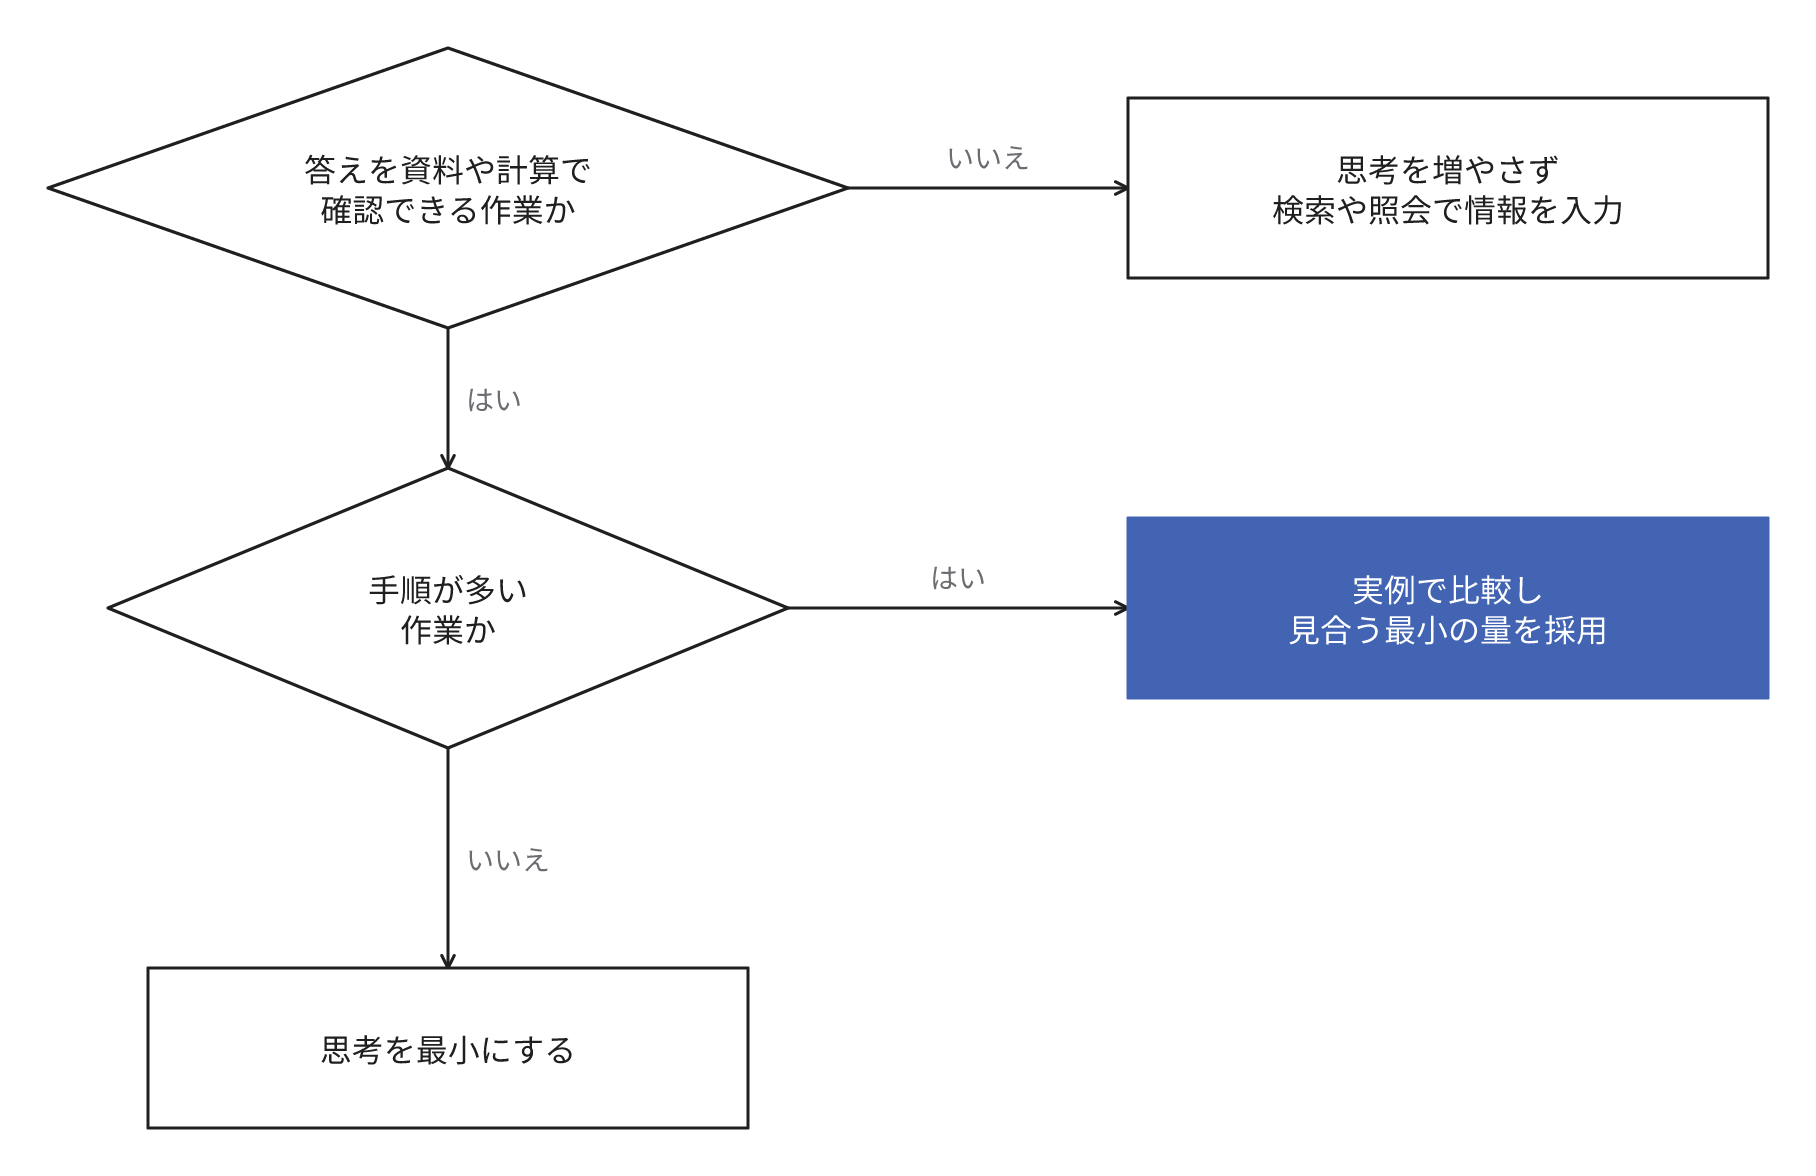
答えを資料や計算で確認できない質問では、思考の量の増加で正確さは保証されません。
最新の事実や社内の情報が必要な質問では、思考の量の増加より、検索や社内システムの照会で正確な情報を入力するほうが効果があります。
よくある誤解
推論モデルの利用でどの作業でも回答の質が向上する
正確さが向上するのは、手順が多く、途中の確認で誤りを防止できる作業です。
Appleの研究はパズルの課題で、同じ計算量での比較の結果を報告しています。
簡単な課題では通常のLLMのほうが成績が高く、一定以上の複雑さの課題ではどちらも正答できなくなりました。
作業ごとに自社の実例で効果を確認し、正答率の改善がない作業では思考の量を最小にします。
表示された思考からAIが回答を出力した理由が分かる
AnthropicやOpenAIの製品が表示する思考は要約で、モデルが実際に回答を生成した理由と一致しないことがあります。
問題に混入したヒントを利用して回答した場合でも、思考の中でそのヒントに言及した割合は、2025年のClaude 3.7 SonnetとDeepSeek R1で25%と39%でした。
回答の正確さは、思考の表示ではなく、参照した資料や計算の検算で確認します。
思考の表示の省略で費用が減少する
Anthropicの説明では、表示を省略しても、生成された思考のトークンはすべて課金され、短縮されるのは待ち時間だけです。
費用の削減には、思考の量の設定を変更して削減します。
関連用語
大規模言語モデル
成熟度:
トークン(生成AI)
成熟度:
生成AI
成熟度:
ハルシネーション
成熟度:
AIエージェント
成熟度:
同じ分野の用語
AI・機械学習の用語をすべて見るお問合せ
事業の課題や技術的な悩みなどどんなことでもお聞かせください