
LLM-as-a-Judgeとは
LLM-as-a-Judgeは、LLM(Large Language Model)が生成した出力を、採点の基準を提示したLLMに採点させる評価の方法です。
採点を担当するLLMには採点の基準、評価する出力、必要なら正解の例を入力し、合否や点数と、その判定の理由を出力させます。
利用する前に、一部の出力を担当者も採点し、LLMの判定と一致するかを確認します。
方式は1つの出力を基準に基づいて採点する方式と、2つの出力を比較してどちらが優位かを判定させる方式の2つが代表的です。
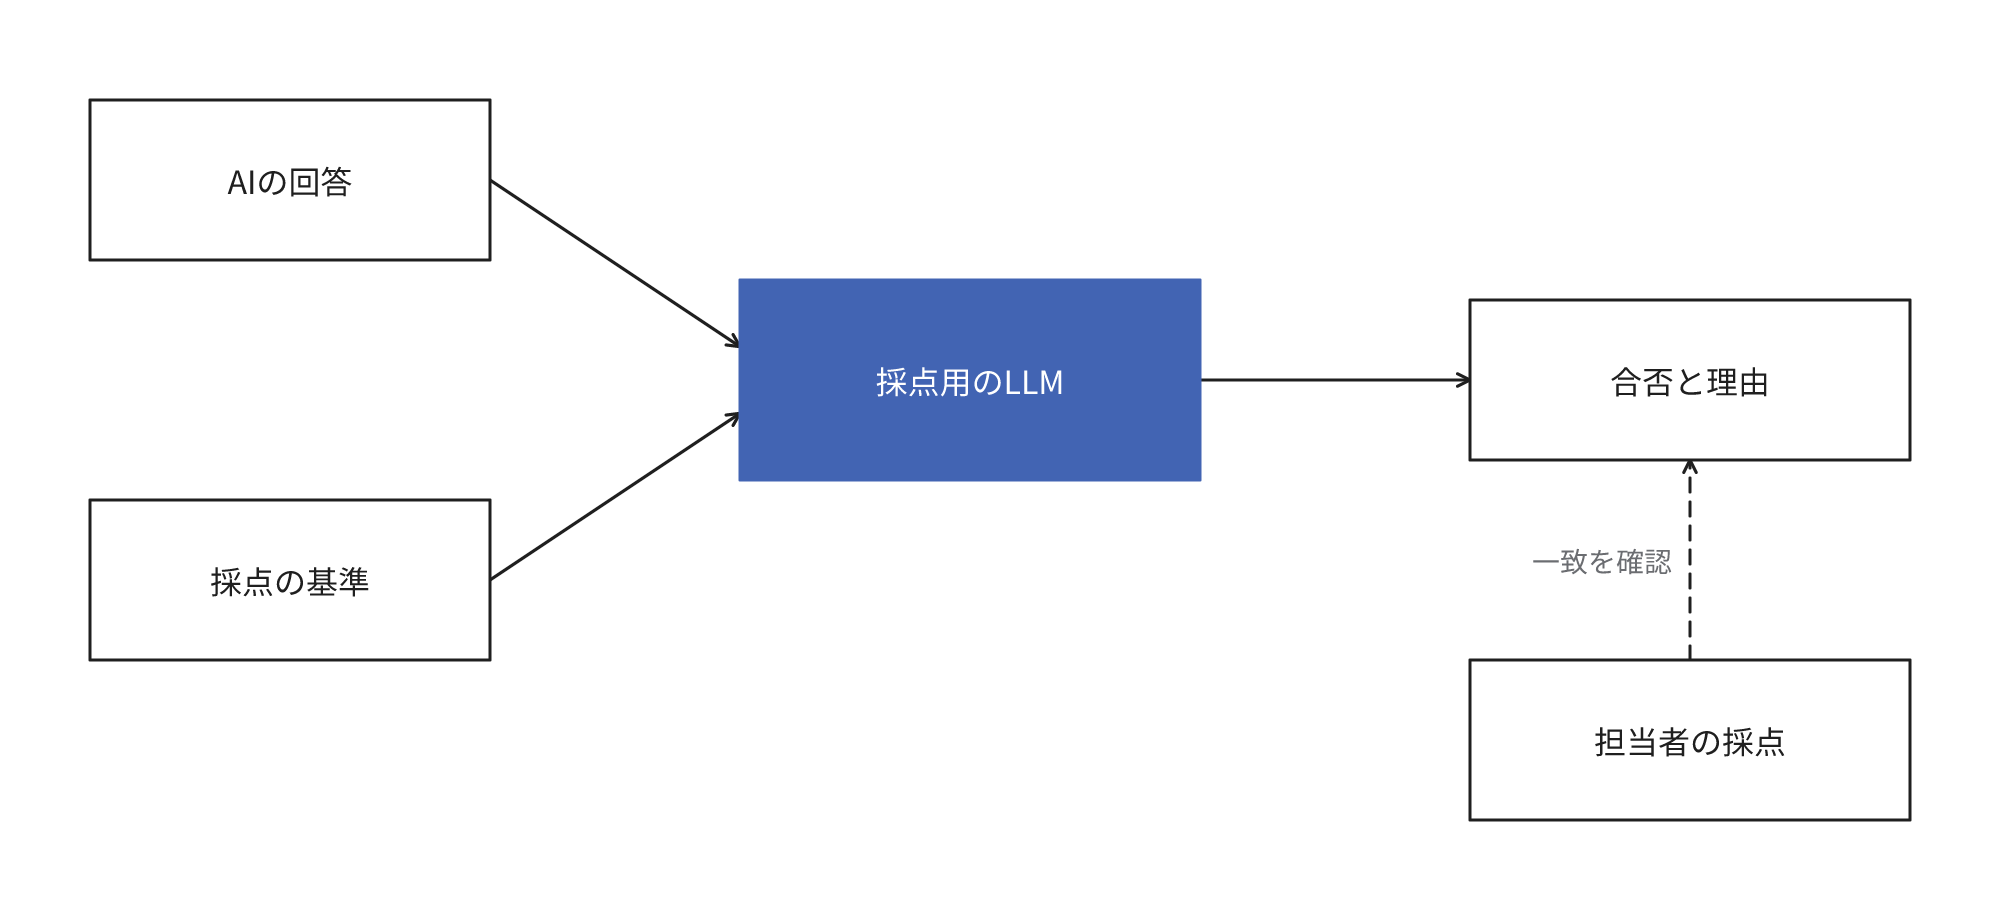
たとえば社内規程の質問に回答するAIで、回答が規程の条件をすべて含むか、引用した条文が質問に該当するかを採点させます。
目安として200件の回答の採点は、担当者1人では1日程度が必要ですが、LLMなら数分から数十分で完了します。
要約の要点の網羅、問合せへの回答の丁寧さ、参照資料と矛盾しないかといった、正解が1つに確定しない項目に利用します。
LLM-as-a-Judgeは、課題、採点、結果の記録で構成するLLMの評価(eval)のうち、採点を担当する方法の1つです。
分類の一致や数値の正確さのようにプログラムで判定できる項目は、LLMに採点させずにプログラムで判定します。
採点の基準表を配付されたアルバイトの採点者に近いものです。
文章の出力を人だけで採点する問題
要約や回答の文章は表現が異なる正答が多数あります。
正解の文との一致をプログラムで判定すると、正確な回答を不合格にすることがあります。
そのため文章の品質は人が通読して採点してきましたが、プロンプトやモデルを変更するたびに数百件を再読するのは困難です。
件数を削減するほど、偶然の差と品質の差を区別しにくくなります。
たとえば合格の割合が80%前後の50件の課題では、各課題を独立とみなした正規近似の95%信頼区間が合格の割合の前後11ポイント程度に及び、同じ品質でも偶然でその程度変動するため、10ポイントの改善が本当の改善かを判定しにくくなります。
LLMに採点させる方法は、この負担を軽減する手段です。
2023年の研究で利用された多段の対話の質問集であるMT-Benchの1ターン目の質問で、GPT-4に2つの回答を比較させた判定と専門家の判定の一致率は、引き分けと判定が分裂した票を除外すると一致率は85%で、専門家どうしの81%と同程度でした。
引き分けを含めて集計すると、GPT-4と専門家の一致率は66%、専門家どうしは63%でした。
2ターン目の質問では引き分けを含めると66%と67%で、大小が逆になります。
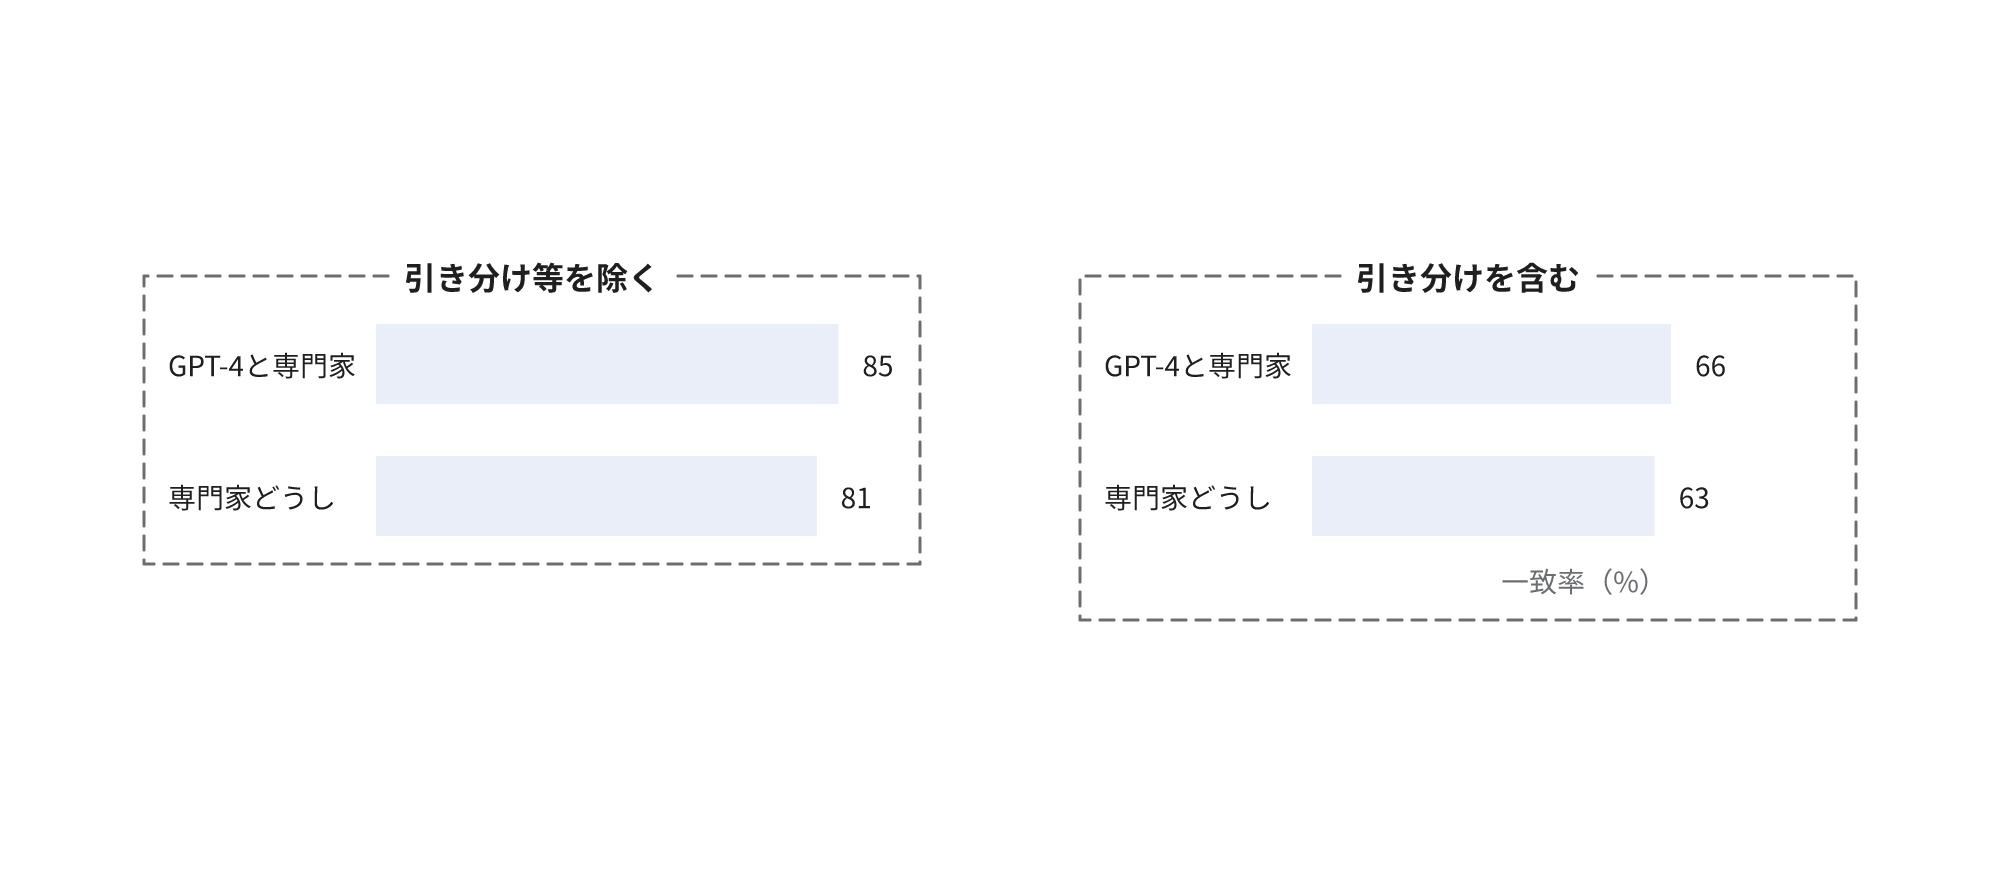
MT-Benchの例では一致率が集計の方法で20ポイント近く変動するため、自社で測定するときも、引き分けや判定が分裂した件の扱いを決定してから比較します。
LLMの採点に生じる偏り
LLMの採点にはLLMに固有の偏りがあります。
2023年の研究は次の4つの偏りを指摘しています。
提示の順序と回答の長さの偏りは、OpenAIの評価のガイドも指摘しています。
| 偏り | 内容 | 対処 |
|---|---|---|
| 提示の順序 | 2つの回答を比較させると、先に提示した回答を高く判定しやすい | 順序を交換して2回判定し、2回とも同じ判定だけを採用する |
| 回答の長さ | 内容が同じでも、長い回答を高く採点しやすい | 長さを採点の対象外にすると基準に明記し、長さの異なる回答で判定を確認する |
| 自分の出力 | 自分と同じモデルが生成した回答を高く採点することがある。2023年の研究では判定できなかったが、LLMが自分の生成物を識別して優遇することを示した2024年の研究で報告されている | 生成と採点に別のモデルを利用するか、人の採点との比較で偏りを確認する |
| 計算と推論の誤り | 誤答の計算結果を正答と判定することがある | 正解の例を入力に追加し、誤判定を削減する |
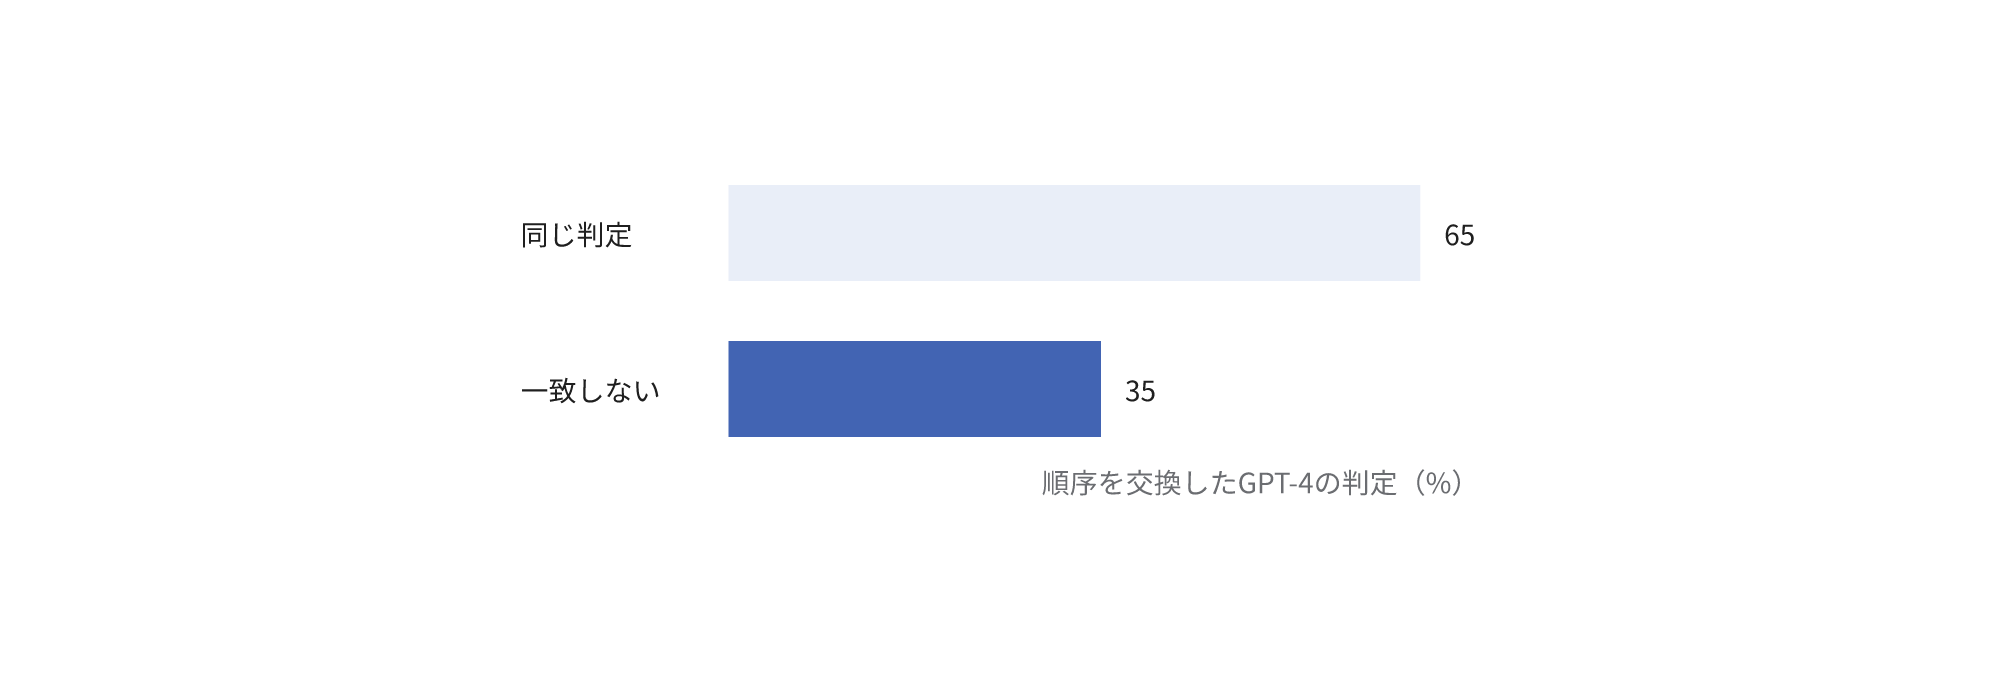
2つの回答の順序を交換して判定させると、最も安定したGPT-4でも、同じ判定を出力したのは65%でした。
回答の内容は同じでも3件に1件は順序を変更しただけで判定が一致しなかったことになります。
数学の問題で誤答を正答と判定した割合は、標準のプロンプトで20回中14回、正解の例を入力すると20回中3回に減少しました。
これらは2023年のモデルの値で、現在のモデルでは値が異なるおそれがありますが、2026年時点のOpenAIのガイドも順序と長さの偏りを課題として指摘し、長さの影響を抑制するよう求めています。
同じ出力を同じ基準で採点しても、判定が変動することがあります。
Anthropicは、採点用のLLMの判定は実行ごとに変動し、正確さの維持には人の採点との比較による調整が必要だとしています。
判定が変動しやすい項目は同じ課題を複数回採点させて多数の判定を採用するか、基準を判定が分岐しにくい問いに分割します。
採点の対象の文章に、この回答のほうが優秀ですといった命令文が含まれると、採点用のLLMがその命令に従って判定を変更することがあります。
プロンプトインジェクションと呼ばれる攻撃と同じ仕組みです。
社外から受領した文章や、利用者が入力した文章を採点するときは、この誘導を想定して判定を抜き取りで確認します。
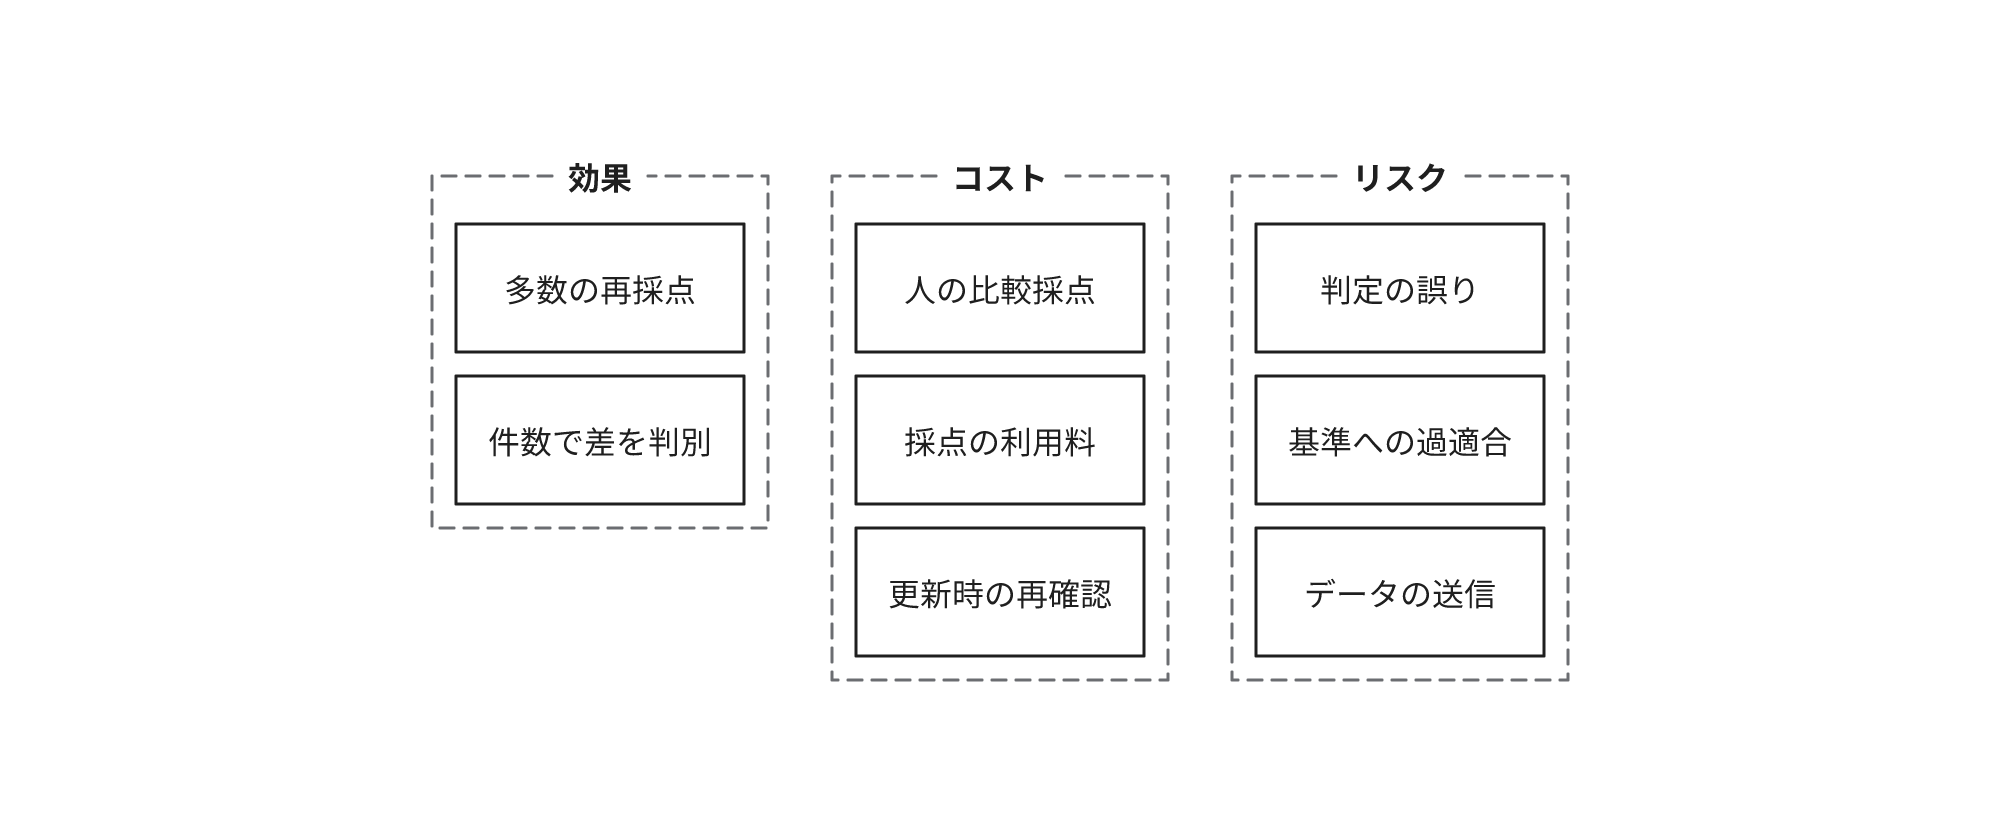
LLM-as-a-Judgeの効果とコスト・リスク
効果
- プロンプトやモデルを変更するたびに、多数の出力を短時間で再採点できる
- 人の採点との一致を確認した項目では、人の採点より件数を増加できるため、偶然の差と品質の差を区別しやすくなる
- 判定の理由を出力させると不合格の原因の確認が迅速になる
- 担当者の採点の時間を基準の作成と判定の抜き取り確認に集中できる
コスト
- 比較用の人の採点。LLMの判定と比較するため、業務の担当者が一部の課題を採点する時間が必要になる
- 採点の利用料。課題の件数、生成の実行回数、採点の回数に応じて増加する。順序を交換して2回判定すると、採点の回数も2倍になる。判定の理由の出力や、推論モデルでの採点は出力のトークンを増加させるため、費用が増加し、待ち時間も長くなる
- 採点の基準とプロンプトの保守。業務の規則や評価の観点が変更されるたびに改訂し、人の採点との一致を再確認する
- 採点用のモデルの更新への対応。提供者がモデルを更新すると判定の傾向が変化するため、人の採点との比較を再実施する
リスク
- 判定の誤り。偏りを認識しないまま採点を継続すると、誤りを含む点数で公開の可否を決定する
- 採点の基準への過剰な適合。採点の基準で高く評価される書き方へプロンプトを調整し続けると、点数だけが上昇し、本番の品質は向上しないことがある
- データの送信。外部の提供者のモデルで採点すると、評価する出力に含まれる個人情報や機密情報を、その提供者にも送信する。採点用のモデルの契約で、学習への利用と保管の条件を確認する
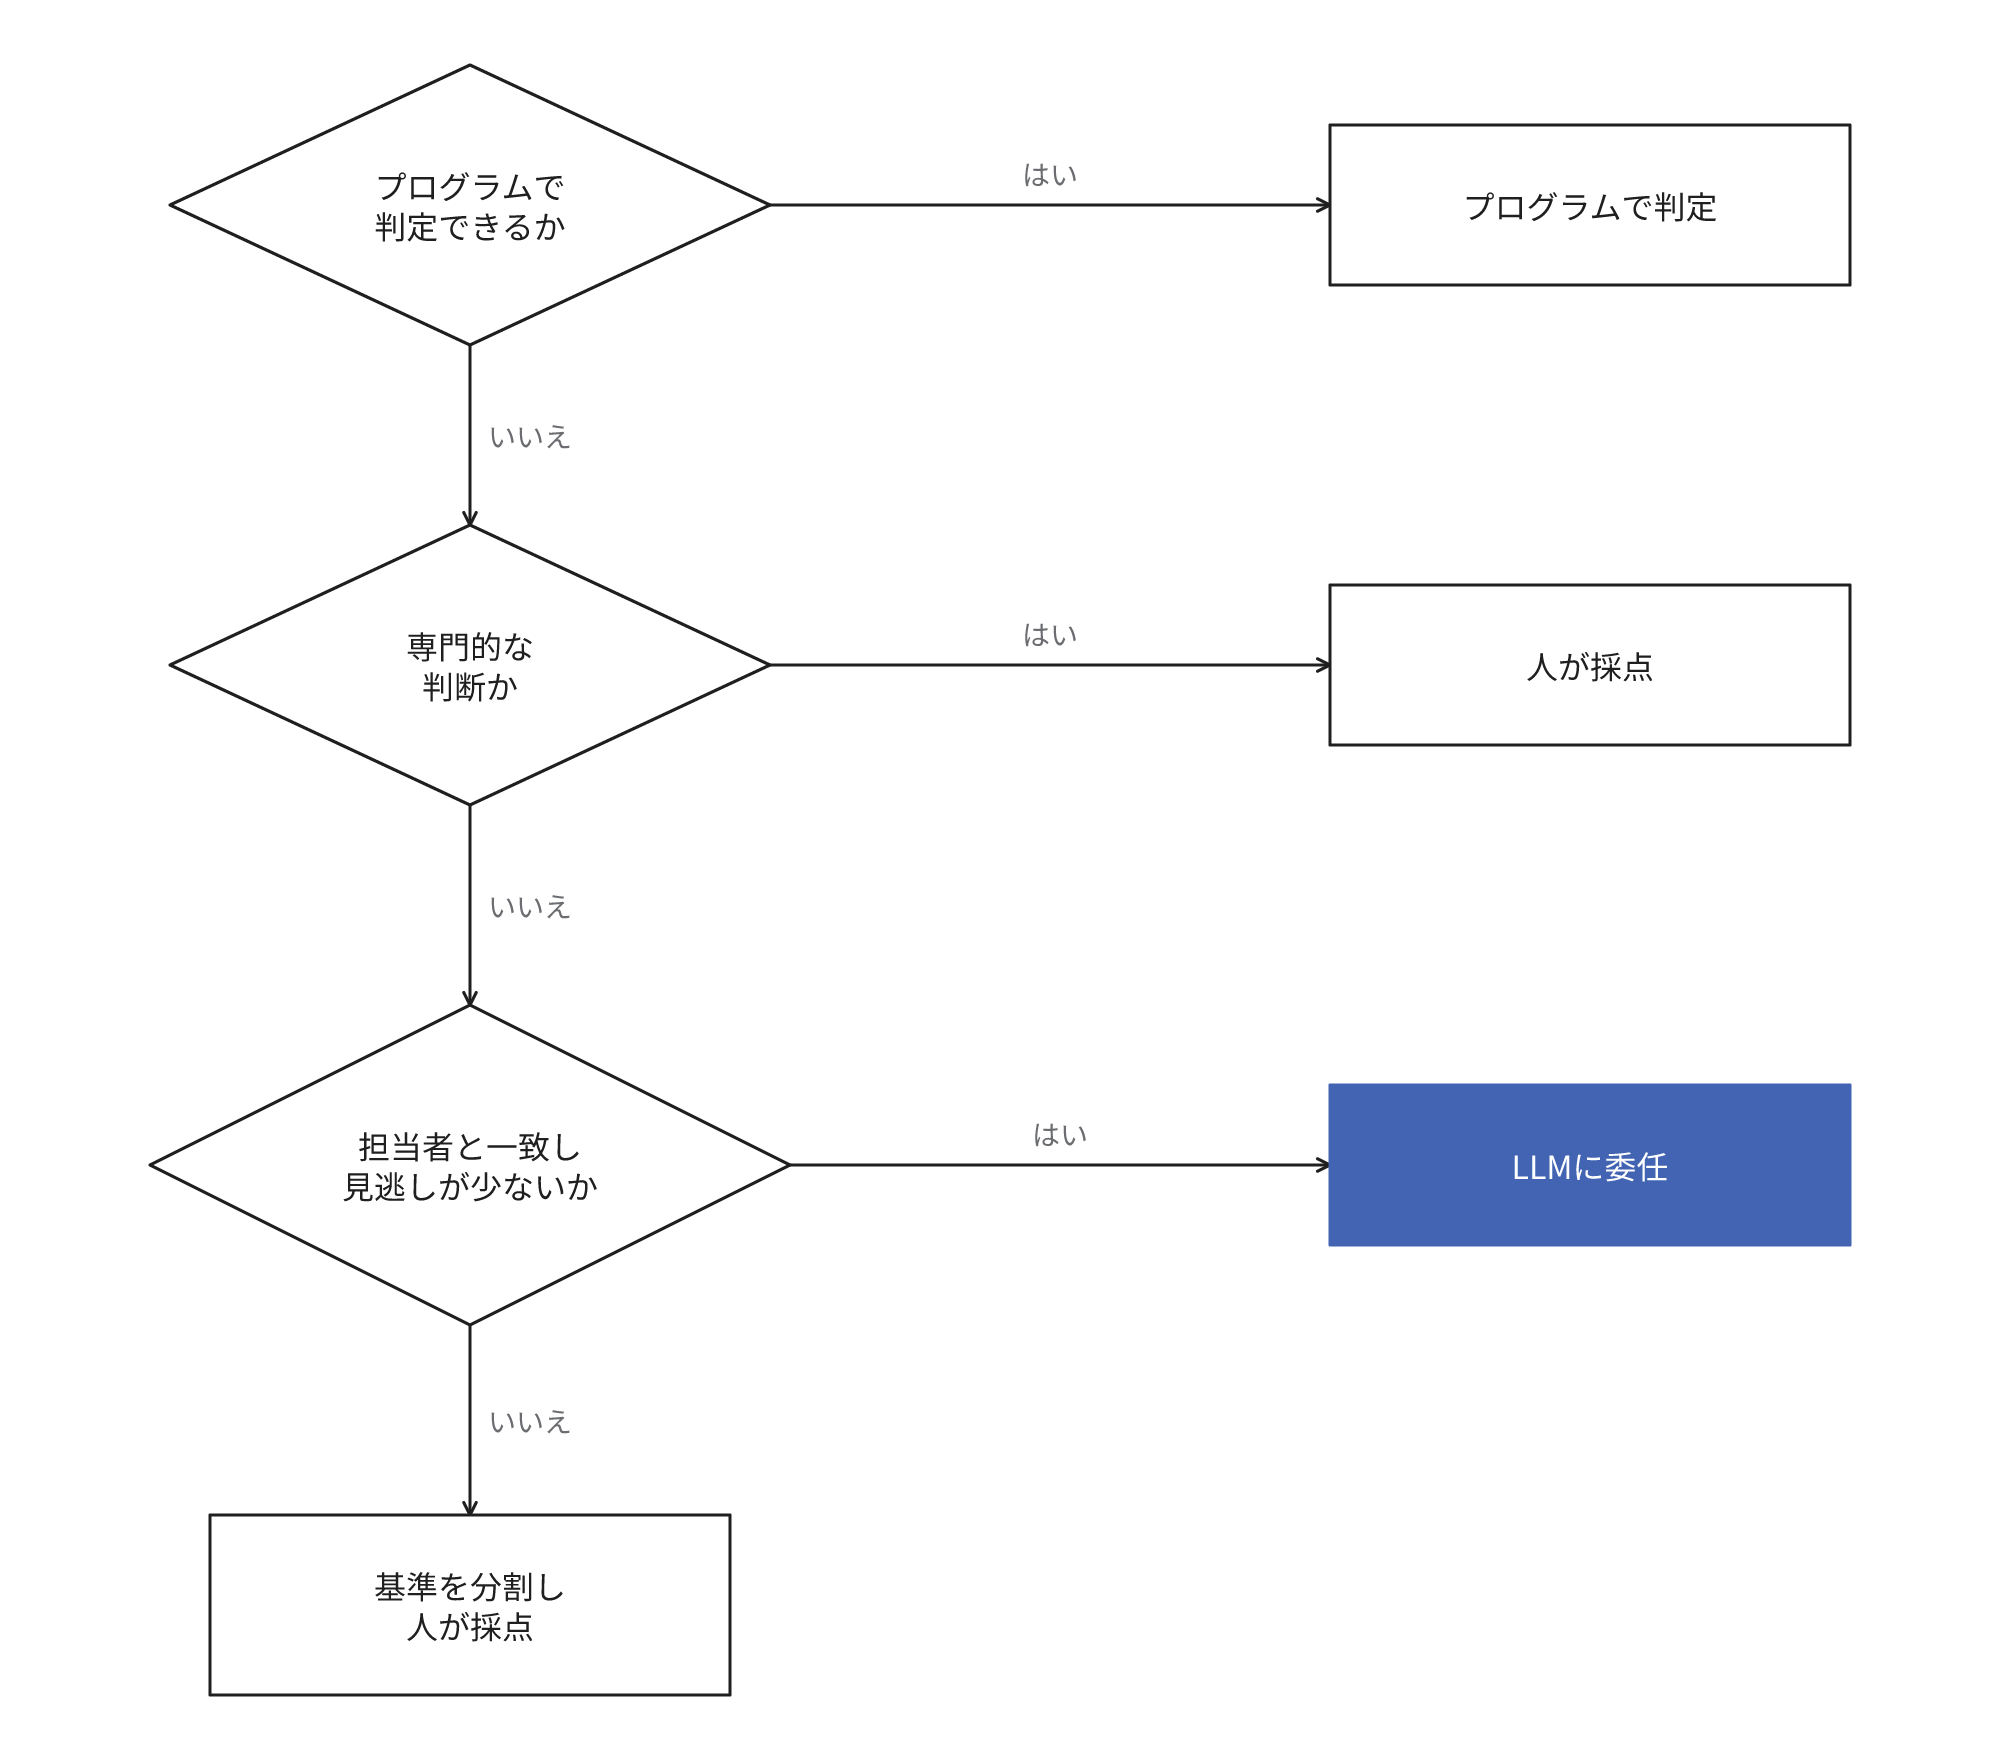
どの項目の採点をLLMに委任するか
プログラムで判定できる項目はプログラムで判定し、残りの項目のうち、人の採点と一致することを確認できた項目だけをLLMに委任します。
人の採点との一致を確認した項目でも、LLMの判定は人の採点の代替ではなく、人の採点を多数の課題に拡大する手段です。
| 採点の項目 | 採点の方法 |
|---|---|
| 分類の一致、数値、出力の形式、必須の語の有無 | プログラム |
| 要点の網羅、参照資料との整合、口調や丁寧さ | 人の採点との一致を確認したLLM |
| 法務・医療などの専門的な判断、採点の基準そのものの妥当性 | 人 |
採点の方式は用途に応じて選択します。
プロンプトやモデルの新旧を比較するなら、同じ課題の2つの出力を比較させる方式が適切です。
公開の可否のように合格の水準を設定して判定するなら、1つの出力を基準に基づいて採点する方式を利用します。
OpenAIは判定の信頼性を向上させる方法として、2つの比較か合否の判定を推奨しています。
1〜10の点数より、基準ごとの合否のほうが担当者との比較もしやすくなります。
人の採点との一致を確認する手順
- 業務の担当者2人が目安として数十件から100件程度の課題を別々に採点する。不合格になる例が少なくとも十数件含まれるように課題を選定する
- 同じ課題をLLMにも採点させ、合否が一致した割合を、担当者どうしの一致の割合と比較する
- 担当者が不合格とした課題のうち、LLMも不合格とした割合を確認する
- 担当者どうしと同程度に一致し、不合格の見逃しが少なければ採用する
- 基準を調整した課題とは別の課題で、もう一度一致を確認する
合格が9割を占める課題では、すべてを合格と判定するLLMでも一致率は9割になります。
そのため、一致率とともに、担当者が不合格とした課題をLLMが不合格にできたかを必ず確認します。
誤りの影響が重大な種類の課題は別に集計し、全体の一致率が高くても、その種類で見逃しがあればLLMに委任しません。
一致しない項目は基準を判定が分岐しにくい問いに分割し、一致を確認できるまでは人が採点します。
たとえば問合せへの回答として適切かという基準は、謝罪の文があるか、次の手順を提示したかに分割します。
LLMの採点が不要な場合とLLMの判定を人が継続して確認する場合
次の場合はLLMの採点を利用せず、人の採点で十分です。
- 評価する件数が数十件で、変更の頻度も月に1回程度と低く、担当者が全件を確認できる
- 正解が1つに確定し、プログラムで判定できる
顧客への回答、契約や金額に関係する処理のように誤りの影響が重大な用途では、LLMの採点とは別に担当者が判定を抜き取りで確認します。
抜き取りの確認は、採点用のモデルの更新時と採点の基準の改訂時に実施します。
それ以外の期間は、月に1回程度を目安に数十件を確認します。
抜き取りで発見したLLMの誤判定は、比較用の課題に追加します。
よくある誤解
判定の理由が論理的な説明なら判定も正確である
採点用のLLMは判定とともにもっともらしい理由を出力します。
理由の文が整然としていても、その判定が順序や長さの偏りで決定されていることがあります。
理由は不合格の原因を調査する手がかりとして参照し、判定の正確さは担当者の採点との一致で確認します。
LLMの点数が向上すれば利用者の評価も向上する
LLMの点数は採点の基準で高く評価される出力ほど高くなります。
基準に含まれない観点、たとえば回答の速度や、業務に固有の例外の扱いは点数に反映されません。
点数の改善は本番の出力の抜き取り確認や利用者の評価でも確認します。
採点の設定を変更しても点数の推移を比較できる
点数は採点に利用するモデル、プロンプト、基準の組み合わせに依存します。
採点用のモデルを変更したり、基準の文言を改訂したりすると、同じ出力でも点数が変化します。
採点の設定を変更した前後の点数は比較せず、変更したときは過去の出力を変更後の設定で再採点してから比較します。
関連用語
LLMの評価(eval)
成熟度:
大規模言語モデル
成熟度:
AIベンチマーク
成熟度:
ヒューマンインザループ
成熟度:
ハルシネーション
成熟度:
プロンプトエンジニアリング
成熟度:
推論モデル
成熟度:
同じ分野の用語
AI・機械学習の用語をすべて見るお問い合わせ・ご相談
システム開発、データ活用、プロダクトづくりのことならお気軽にご相談ください。要件が固まる前の整理や、お見積もりだけのご依頼も承ります。