
AIベンチマークとは
AIベンチマークは、AIモデルの性能を共通の課題と採点の手順で測定し、モデルどうしを同じ条件で比較するための試験です。
結果は課題の正答率や、人の投票で決定した順位などの形で公開されます。
たとえば大学院の水準の専門知識を選択式で出題するGPQA(Graduate-Level Google-Proof Q&A)、プログラムの不具合を修正させて自動テストで判定するSWE-bench、2つの回答を人が比較して投票するChatbot Arenaがあります。
業務で利用するモデルを選定するとき、候補のモデルの発表資料にはベンチマークの点数が掲載されています。
点数はそのうちどのモデルの能力が一般に高いかを比較する材料になります。
ただし、自社の問合せの分類や社内規程への回答が正確かは、ベンチマークの点数からは分かりません。
車の燃費のカタログ値に近く、車種どうしの比較には有用ですが、自社の配送での燃費は実際の配送で計測します。
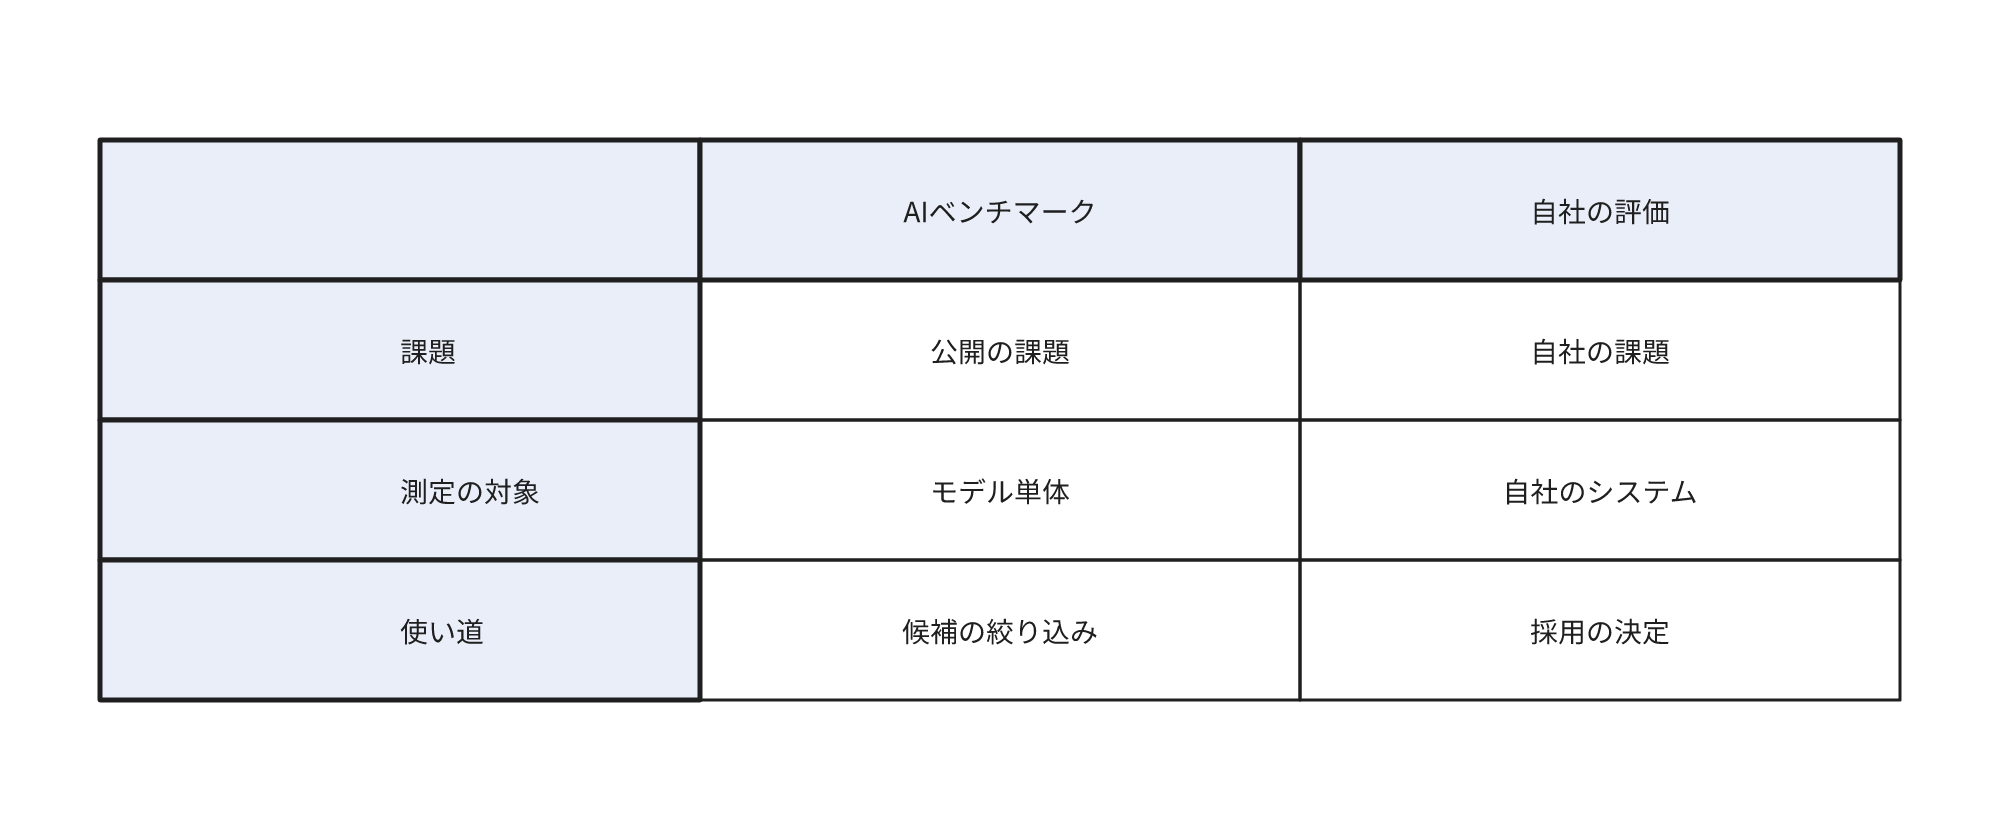
AIベンチマークは、自社のアプリケーションの品質を自社の課題で測定するLLMの評価(eval)とは別のものです。
ベンチマークはモデル単体を共通の条件で比較し、自社の評価はプロンプト、参照資料、ツールで構成した自社のシステムを、自社の業務の課題で測定します。
業務に組み込む用途ではベンチマークは候補の選別に利用し、採用するモデルは自社の評価で決定します。
ベンチマークがない場合のモデルの性能の比較の困難さ
ベンチマークがなければ他社のモデルどうしを共通の条件で比較する公開の基準がありません。
比較は提供者の説明か、自社で課題を用意した試行に依存することになります。
共通の課題と採点の手順を公開すると、異なる提供者のモデルを同じ条件で比較でき、技術の進歩も追跡できます。
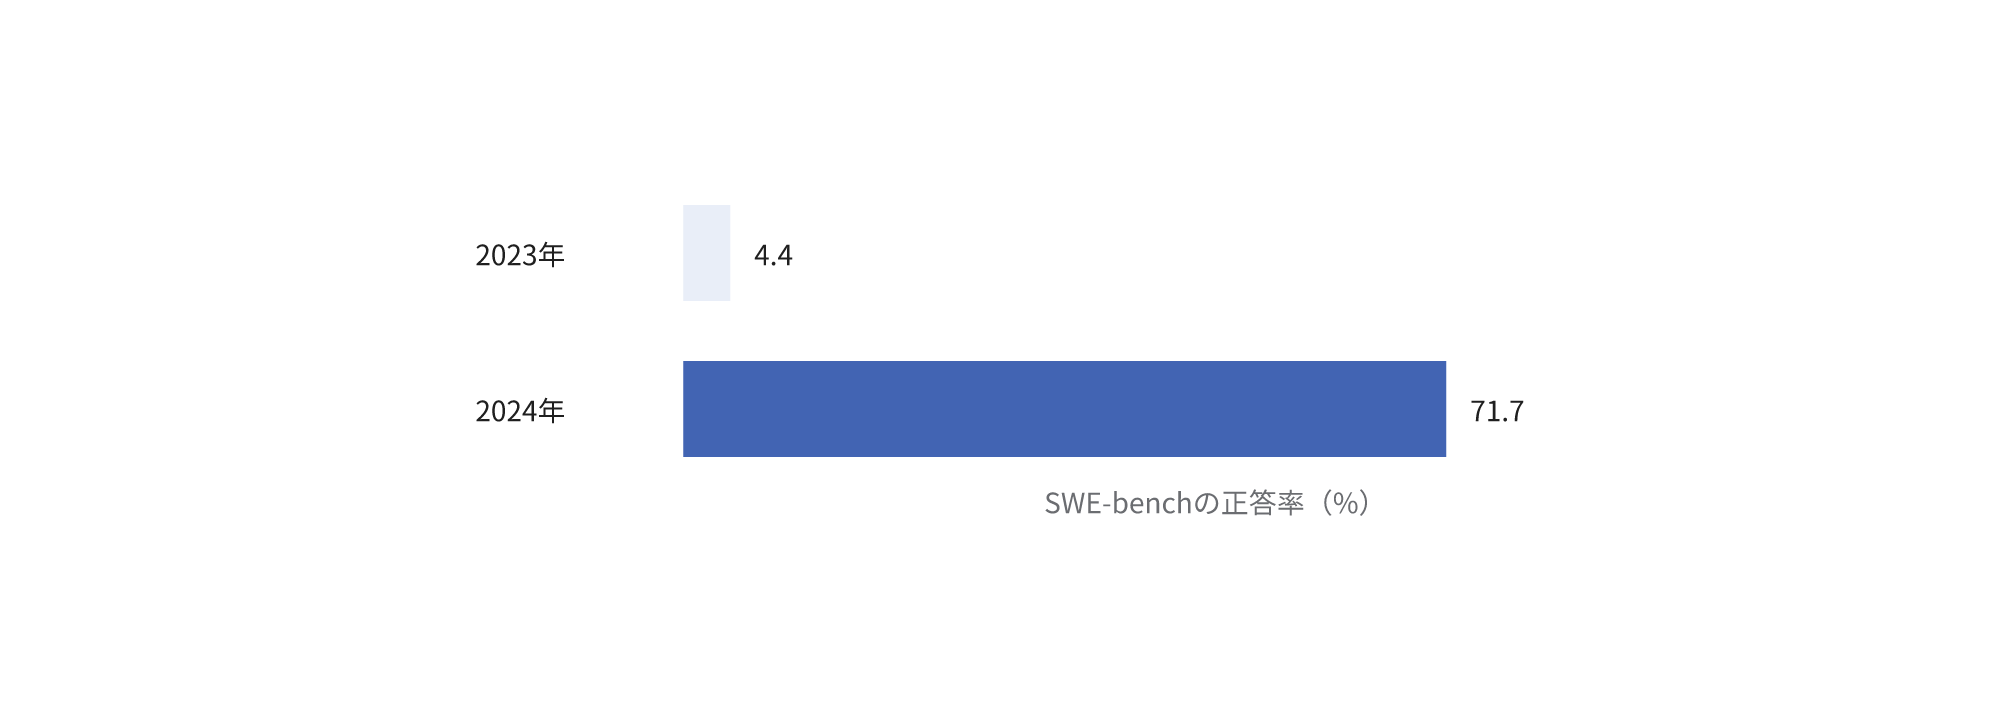
たとえばSWE-benchの課題の正答率は、2023年の4.4%から2024年には71.7%に上昇しました。
公開の点数を自社の判断に利用するときの限界
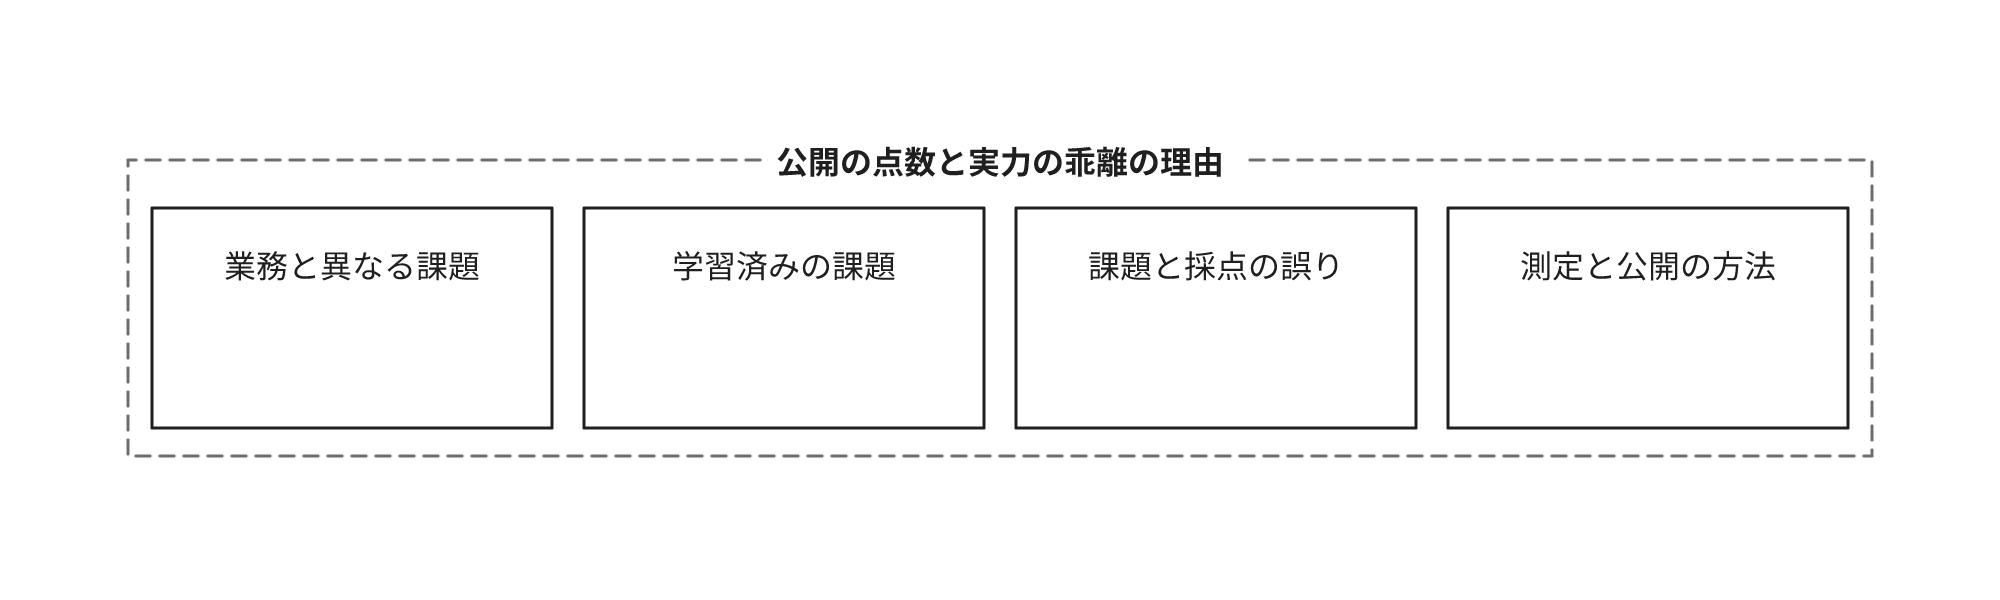
課題が自社の業務と異なる
公開のベンチマークの課題は、通常、自社の文書、用語、例外の扱いを含みません。
英語の課題も多く、日本語の業務での性能は英語の点数だけでは判断しにくくなります。
日本語の業務で利用するなら、英語の点数だけで判断せず、日本語の課題の点数を参照します。
Swallow LLM Leaderboardのように、日本語の課題で主要なモデルを同じ条件で測定し、結果を公開しているものもあります。
課題が学習データに混入する
公開された課題と解答をモデルが学習すると、学習の有無が点数に影響します。
小学校の算数の文章題で構成したGSM8k(Grade School Math 8K)と同じ難易度の課題を新たに作成すると、一部のモデルの系統では正答率が最大8ポイント低下しました。
SWE-benchの課題を人が点検して500問に厳選したSWE-bench Verifiedについて、OpenAIは2026年2月に、点数が学習時の課題への接触の度合いを反映するようになったとして点数の報告を中止しました。
課題と採点に誤りがある
SWE-bench VerifiedのうちOpenAIのモデルが安定して正答できなかった138問では、59.4%で、テストか問題文に重大な欠陥が発見されました。
この例ではOpenAI o3が安定して正答できなかった課題の半数以上に欠陥があり、欠陥のある課題での点数の差は能力の差を示しにくくなります。
測定の条件と公開の方法による点数の偏り
提供者の発表資料の点数は、測定の条件が提供者ごとに異なることがあります。
たとえば思考の量を最大にした設定か、複数回の試行をどう集計するか、ツールを使用するかです。
自社で利用する設定と条件が異なれば、同じモデルでも点数は変化します。
Swallow LLM Leaderboardも、推論型のモデルの生成の設定と標準的な評価方法との差を縮小し、開発元の公式発表の点数と比較しやすくしたと記載しています。
公開の方法も順位の偏りの原因になります。
たとえば人の投票で順位を決定するChatbot Arenaでは、Metaなど一部の提供者が非公開で多数の版を試行し、最も高い点数だけを公開できたため、順位に偏りが生じていました。
人の投票は回答の長さや見出しの多さといった書式にも左右され、書式の影響を除外すると順位が変化しました。
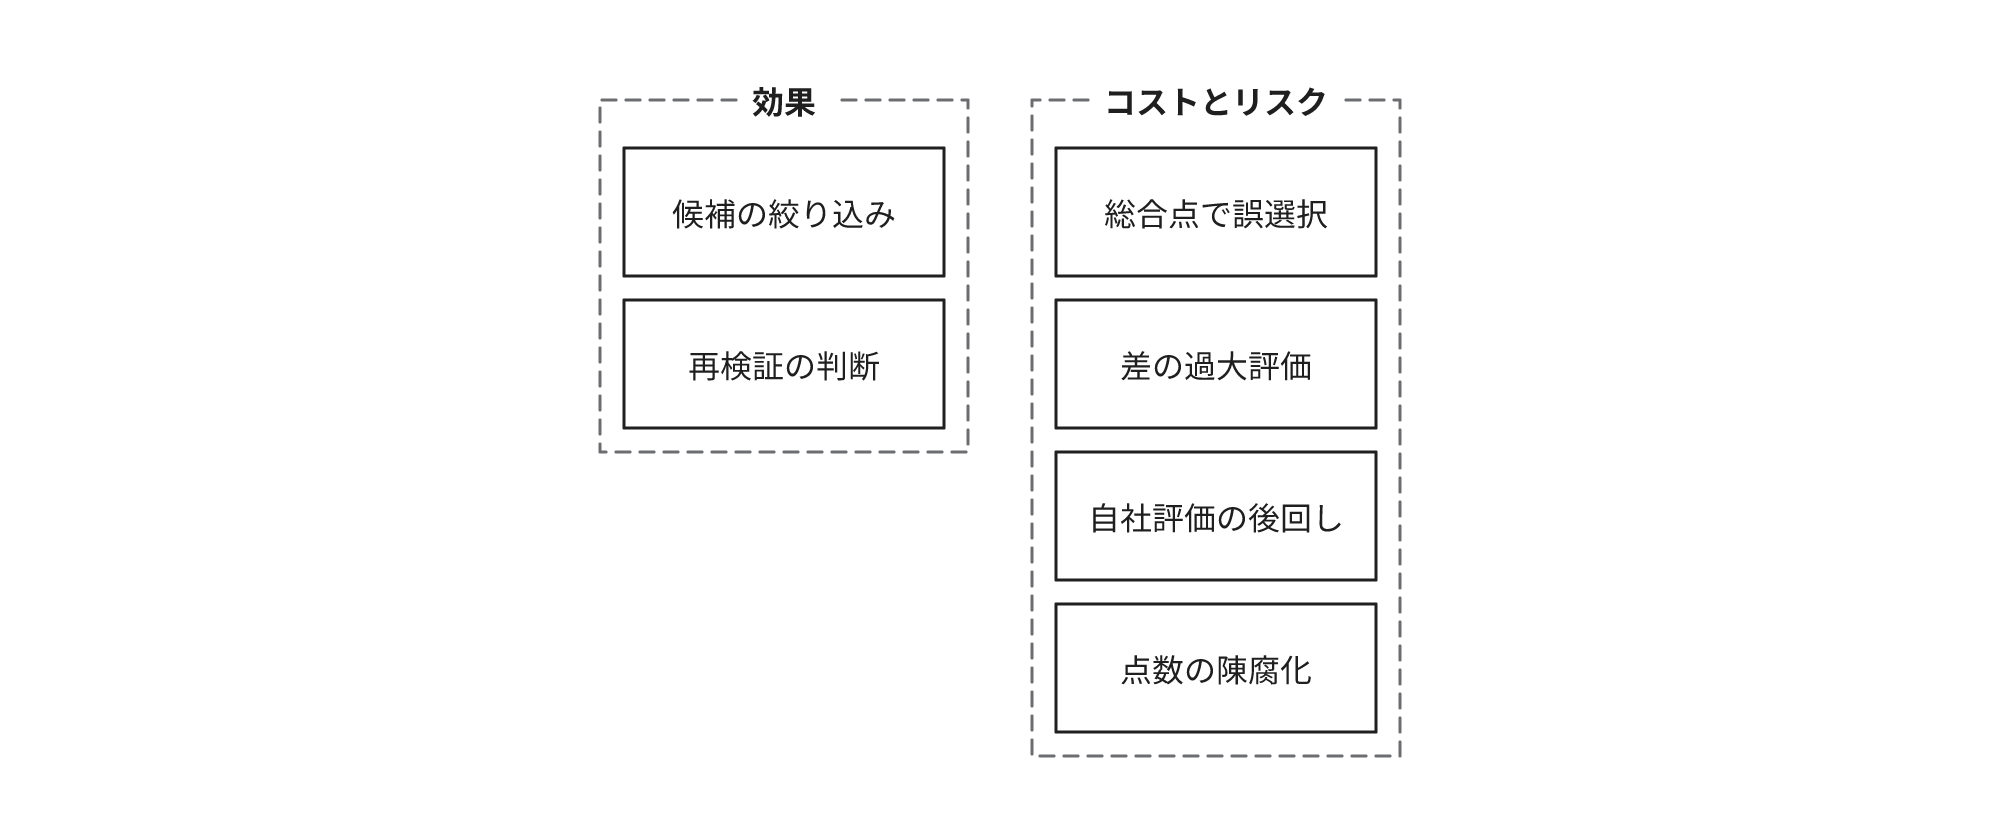
ベンチマークの点数を参照する効果とコスト・リスク
効果
- 自社で評価する前に候補のモデルを数個に限定できる
- 最新のモデルの発表時に、自社の評価で再検証する価値の有無を評価できる
- 用途に近いベンチマークの点数が著しく低いモデルを、初期の段階で候補から除外できる
コストとリスク
- 点数による選択の誤り。総合の点数が高いモデルを選定しても、自社の業務で品質が向上するとは限らない。推論を強化して点数を向上させたモデルは、回答の前の思考の処理が増加するため費用が高く、待ち時間も長いことがあり、2024年のOpenAIのo1はGPT-4oより費用が約6倍、処理が30倍遅いものでした
- 点数の差の過大評価。数ポイントの差は課題の欠陥や偶然の変動の範囲内であることがある
- 自社の評価の後回し。公開の点数だけで決定した気になり、自社の課題を作成する工程を省略すると、本番で失敗するまで品質が分からない
- 参照する点数の再検討。主要なモデルの点数が満点に接近したベンチマークでは差を測定しにくいため、より高難度の新規のベンチマークが導入される。どの点数を参照するかを継続して再検討する必要がある
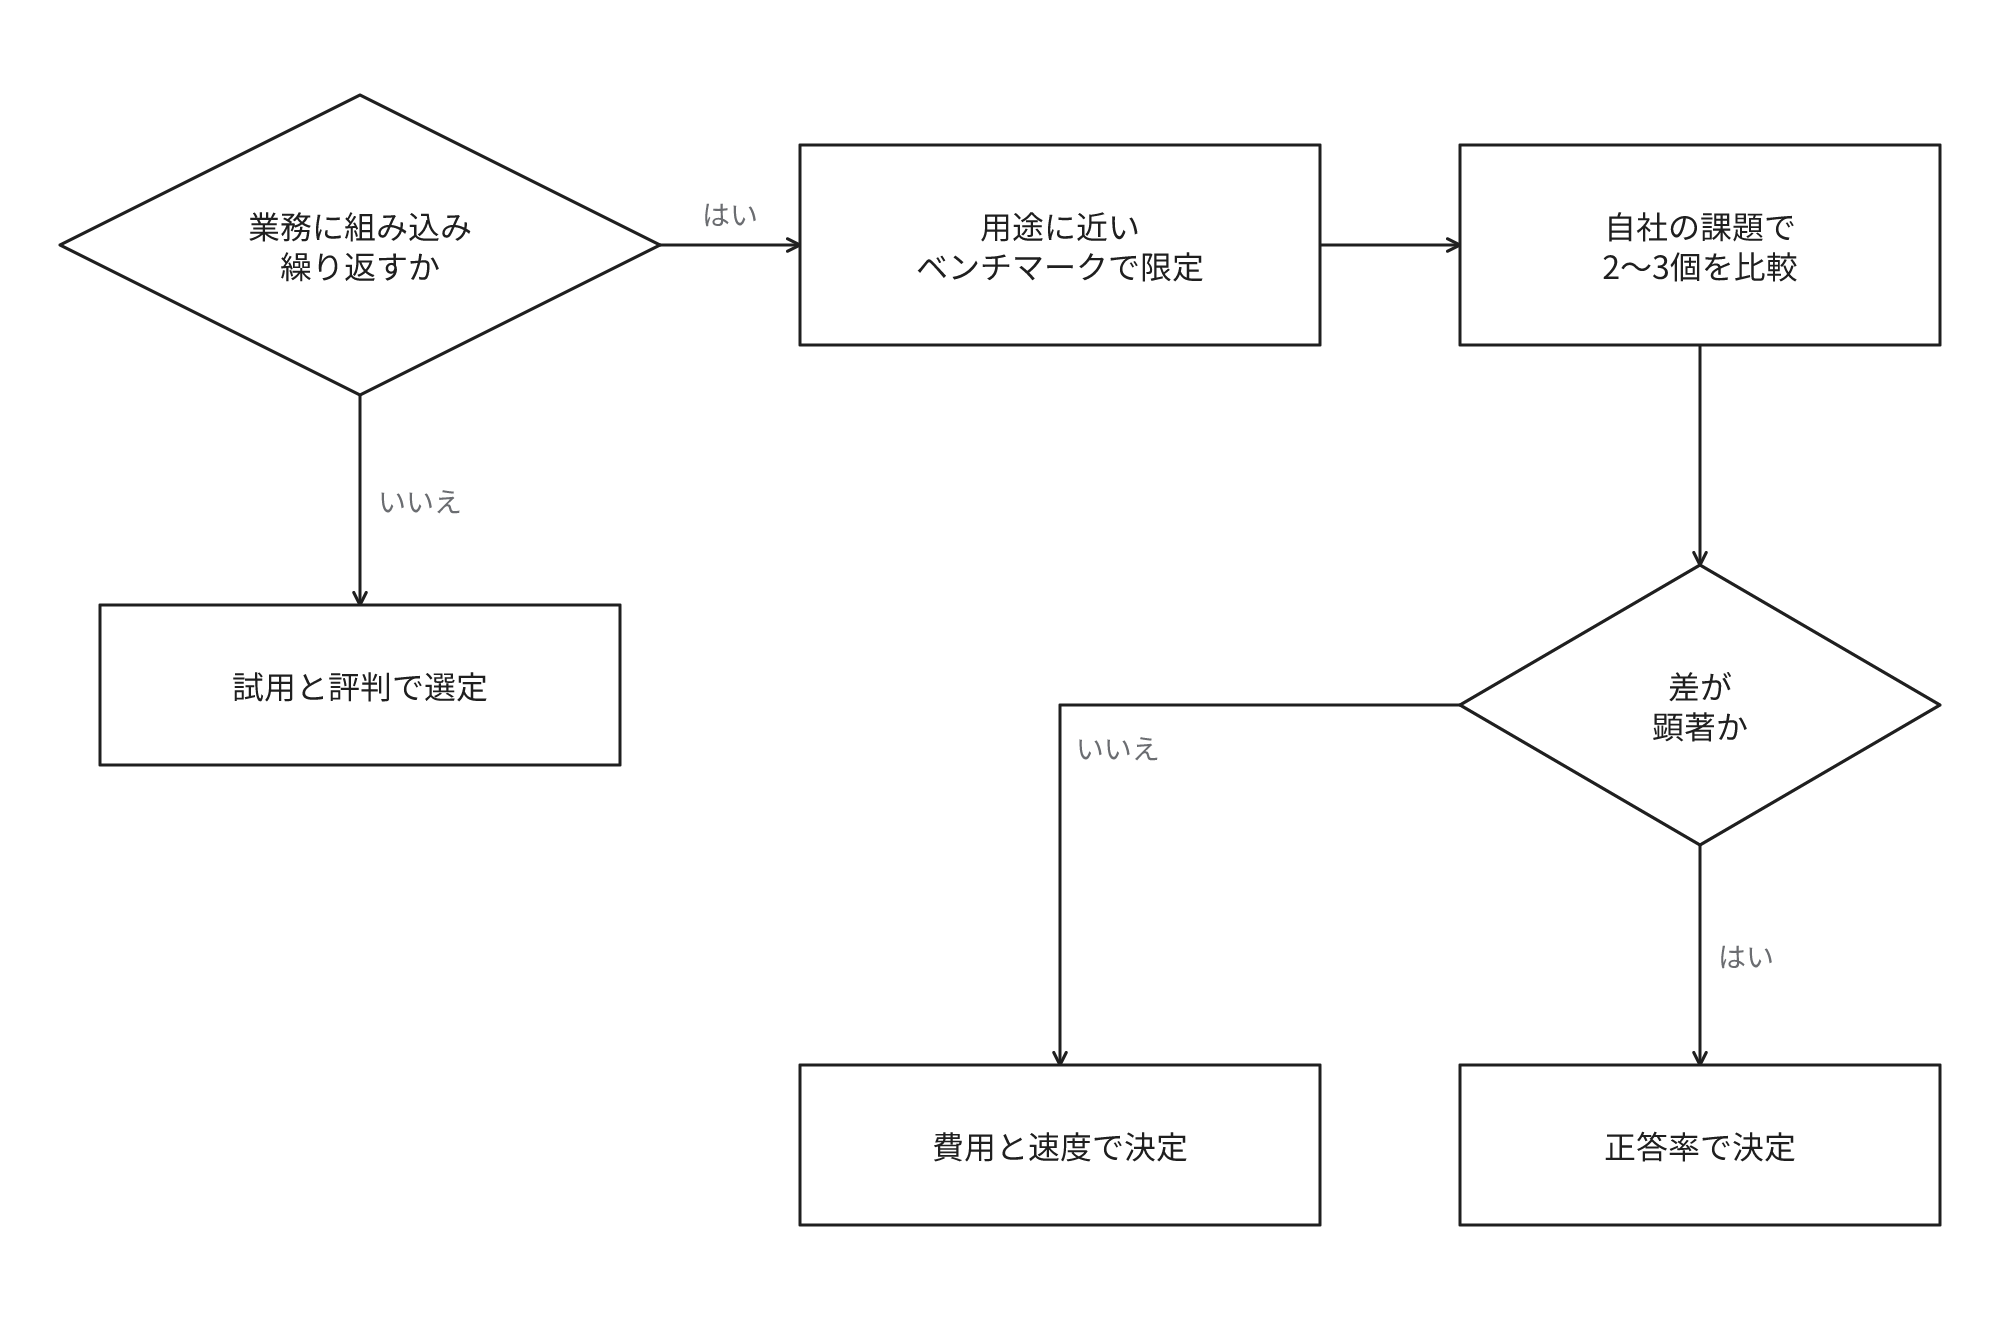
モデルの選定にベンチマークをどこまで利用するか
ベンチマークの点数は候補の選別にだけ利用し、採用するモデルは自社の課題で決定します。
- 用途に近い能力を測定するベンチマークを選定する。コーディングエージェントの評価でも、総合の点数が数ポイント変動しただけでは変化の原因は分からないため、用途に対応する点数を確認する
- 費用、処理速度、データの取り扱いの条件も考慮して、候補を2〜3個に限定する
- 自社の業務の課題を目安として数十件から100件程度用意し、候補のモデルで実行して、正答率、1件あたりの費用、待ち時間を比較する
- 自社の課題で差が軽微なら費用と速度で選定する
用途と、参照するベンチマークの種類の対応は次のとおりです。
| 用途 | 参照する点数の例 |
|---|---|
| プログラムの作成と修正 | 実在のリポジトリの不具合を修正させる課題。OpenAIは新規の評価の完成まで、SWE-bench Verifiedの代わりにSWE-Bench Proでの報告を推奨している |
| 社内システムを操作するAIエージェント | ツールを利用して顧客対応を完了させるτ-benchのような、ツールの操作と業務の規則への準拠を測定する課題 |
| 日本語の文書の読解と回答 | 日本語の課題の点数。Swallow LLM Leaderboardの日本語の項目など |
| 社員向けの汎用のチャット | 人の投票による順位と、主要な提供者の現行のモデルであるか |
点数の差の解釈には次の目安を利用します。
| 状況 | 判断 |
|---|---|
| 用途に近いベンチマークで、候補の間に目安として十数ポイント以上の差がある | 点数の低いモデルは候補から除外してよい |
| 差が数ポイント程度 | 差がないものとみなし、自社の課題で比較する |
| 提供者の発表資料にだけ掲載されている点数 | 測定の条件が自社の設定と異なることがあるため、第三者が同じ条件で測定した点数か、自社の課題で確認するまで参考の扱いにする |
| 主要なモデルの点数が上限に近いベンチマーク | 比較に利用しない |
数ポイントの差を差とみなさないのは、課題数が数百問で正答率が中程度のベンチマークでは、偶然の変動がその程度になるためです。
たとえば500問で正答率が50%前後なら、各課題を独立とみなした正規近似の95%信頼区間で、前後4ポイント程度の幅があります。
人の投票による順位は正答率ではないため、この目安は適用できません。
第三者が同じ条件で測定した点数は、自ら測定した結果を外部の結果と区別して掲載するEpoch AIや、複数のモデルを自ら測定して公開するArtificial Analysisで確認できます。
社員が文章の下書きや調査に利用する汎用のチャットの選定では、自社の評価まで作成する必要は通常ありません。
出力を社員が毎回確認して利用するため、誤りを発見して修正しやすいためです。
用途が多岐にわたり、固定の課題を作成しにくいことも理由です。
主要な提供者の現行のモデルから、データの取り扱いの条件を確認して試用で選定し、利用者の評判で再検討する方法で通常は十分です。
業務に組み込んで同じ処理を反復する用途では、ベンチマークで決定せずに、自社の課題で比較します。
よくある誤解
ベンチマークで1位のモデルが自社の業務でも最も高い品質になる
ベンチマークの順位はその課題集での成績の順位です。
自社の業務では参照する資料、プロンプト、ツールの組み合わせによって品質が決定され、順位の低いモデルのほうが高い品質になることもあります。
上位のモデルは費用が高く待ち時間も長いことがあるため、自社の課題で比較してから決定します。
点数が上がり続けているのでAIの能力も同じ割合で向上している
点数の上昇には課題の学習データへの混入や、特定のベンチマークに特化した調整も含まれます。
OpenAIがSWE-bench Verifiedの報告を中止したように、点数が能力を反映しなくなったベンチマークもあります。
能力の変化は複数のベンチマークと自社の課題での変化の両方で評価します。
関連用語
LLMの評価(eval)
成熟度:
LLM-as-a-Judge
成熟度:
大規模言語モデル
成熟度:
生成AI
成熟度:
推論モデル
成熟度:
コーディングエージェント
成熟度:
AIエージェント
成熟度:
同じ分野の用語
AI・機械学習の用語をすべて見るお問い合わせ・ご相談
システム開発、データ活用、プロダクトづくりのことならお気軽にご相談ください。要件が固まる前の整理や、お見積もりだけのご依頼も承ります。