
AIガードレールとは
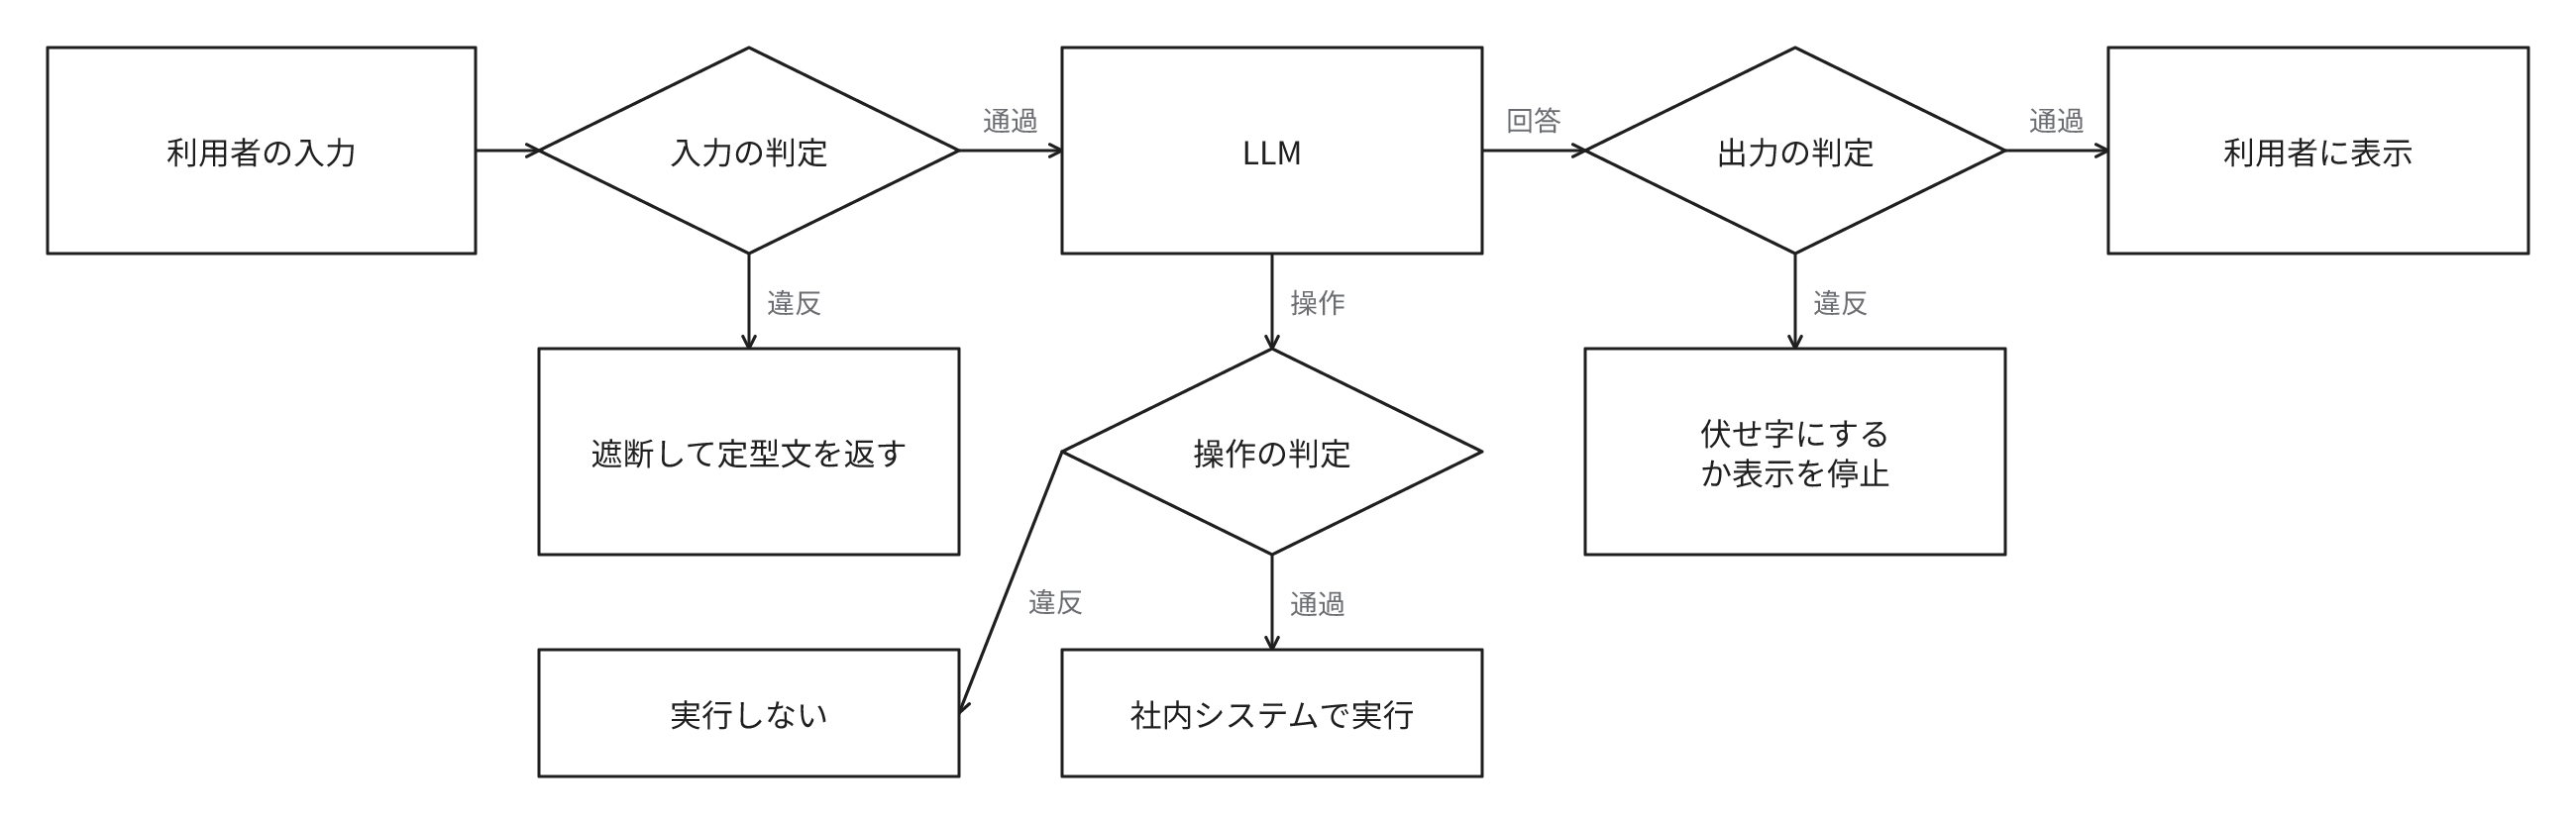
AIガードレールは生成AIへの入力、AIの出力、AIが実行する操作を、事前に定めた規則で自動判定し、規則に違反するものを遮断または修正する仕組みです。
LLM(Large Language Model)の外側に配置したプログラムや判定用のモデルが判定を担当し、判定の対象とした入力と出力には、設定した規則を一律に適用します。
たとえば社外向けの問合せ対応AIなら、次のような判定を実装します。
- 利用者の入力に、AIの制限を無視させる指示が含まれていれば、回答を生成せずに定型文を返却する
- 回答に顧客の電話番号やクレジットカード番号が含まれていれば、伏せ字にしてから表示する
- 回答が参照した社内資料に記載のない内容を含んでいれば、表示を停止する
- 競合他社の製品の評価や投資の助言のような、対象外の話題には回答しない
高速道路のガードレールが運転操作の誤りによる車両の路外への逸脱を防止する設備であるのと同様に、AIの誤りや悪用を前提に、被害を一定の範囲に限定するための仕組みです。
人が内容を確認して承認するヒューマンインザループとは、判定をプログラムやモデルが自動で行う点で異なります。
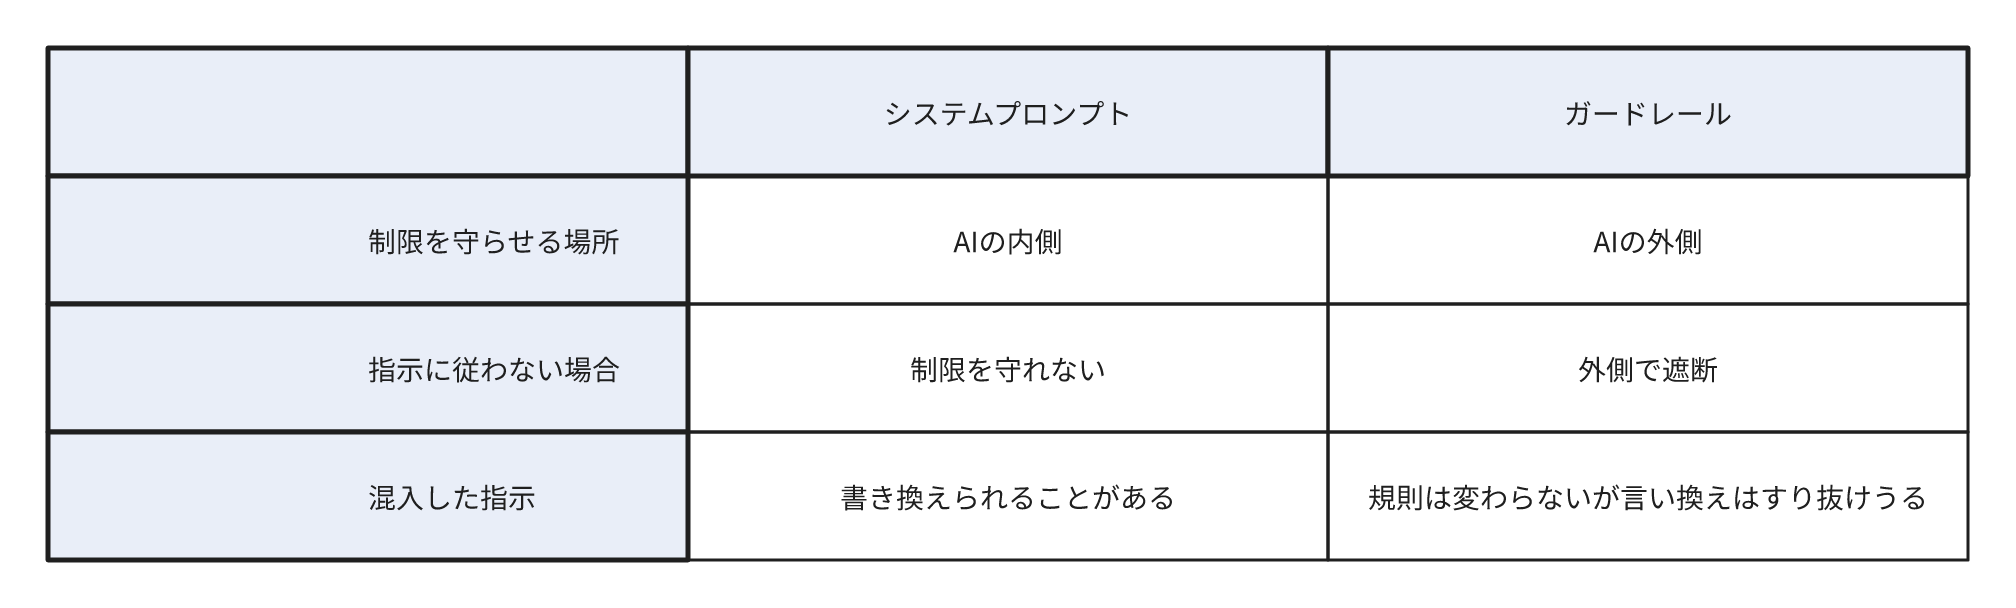
システムプロンプトでAIに禁止事項を指示する方法は、AI自身が従うかどうかに依存するため、AIガードレールとは区別します。
ガードレールはAIの外側で判定するため、AIが指示に従わなかった場合にも判定が働きます。
ただし、LLMで判定するガードレールは、判定するLLM自体が入力に混入した指示に従って誤判定することがあります。
クラウドの管理で、利用者の操作を制限する設定もガードレールと呼びますが、この記事の生成AIのガードレールとは別のものです。
プロンプトの指示だけでは制限を遵守させられない理由
LLMはシステムプロンプトで禁止した内容を、利用者の言い回しや文書に混入した指示に従って出力することがあります。
OWASP(Open Worldwide Application Security Project)のLLMアプリケーション向けリスク一覧は、AIが処理する文章に混入させた指示で本来の動作を変更させるプロンプトインジェクションを、最初の項目にしています。
事実と異なる内容を生成するハルシネーションも、プロンプトの指示だけでは発生をなくせません。
LLMは学習した文章の統計的な傾向からもっともらしい続きを生成するため、事実と異なる内容を生成することがあります。
プロンプトの指示で生成の仕組み自体は変化しないため、指示だけでは発生を完全には防止できません。
AIが社内システムを操作するAIエージェントでは、誤りを含む出力が送信や削除といった操作に直結します。
AIに必要以上の機能、権限、自律性を付与する過剰なエージェンシー(Excessive Agency)も、OWASPの一覧のリスクの1つです。
過剰なエージェンシーの下では、AIの判断の誤りが送信や削除などの被害に直結します。
権限の限定は被害の範囲を縮小しますが、限定した権限の範囲内の誤操作は防止できません。
そのため、権限の限定と併用して、AIの判断を信用せずにAIの外側で入力、出力、操作を判定する仕組みも必要になります。
判定する場所と内容
ガードレールはAIの処理の複数の箇所に配置します。
NVIDIAのNeMo Guardrailsは、配置する場所を入力、検索した資料、会話の進行、ツールの実行、出力の5種類に分類しています。
業務で特に重要なのは会話の進行を除く次の4か所です。
| 判定する場所 | 判定の例 | 防止する問題 |
|---|---|---|
| 入力 | AIの制限を無視させる指示、対象外の話題、個人情報の入力 | プロンプトインジェクション、目的外の利用、個人情報の送信 |
| 検索した資料 | 社外から受信した文書に含まれる指示 | 資料を経由したプロンプトインジェクション |
| ツールの実行 | 操作の種類、宛先、金額、件数の上限 | 意図しない送信、削除、支払い |
| 出力 | 有害な表現、個人情報、参照資料との不一致、形式の誤り | 不適切な回答、情報の漏洩、ハルシネーション |
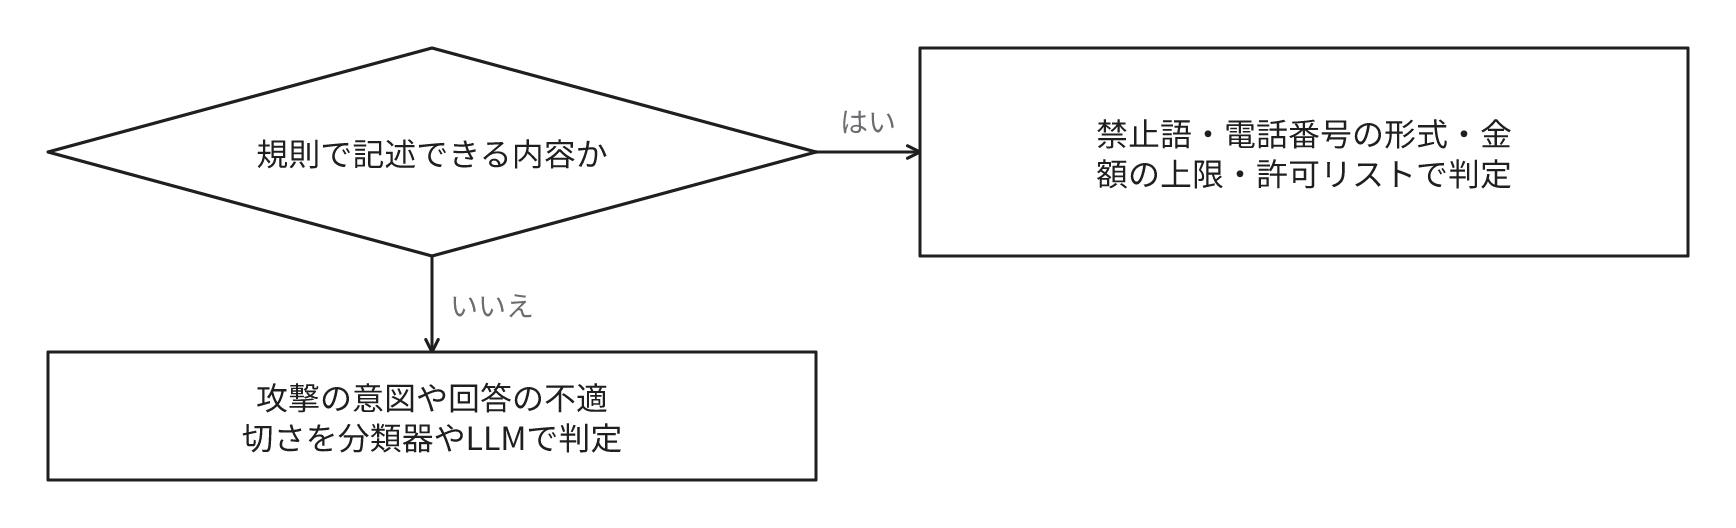
判定の方法は規則と判定用のモデルの2種類です。
規則で判定するのは、禁止語、正規表現による個人情報の形式の検出、金額の上限、送信先の許可リストなどです。
攻撃の意図や回答の不適切さのように規則で記述できない内容は、入力を種類ごとに振り分けるよう学習させた分類器やLLMで判定します。
主要なクラウドはガードレールの機能を提供しています。
2026年11月時点の例は次のとおりです。
- Amazon Bedrock Guardrails。有害な内容とプロンプト攻撃の判定、対象外の話題の拒否、個人情報の伏せ字、参照資料との不一致の検出
- Azure AI Content SafetyのPrompt Shields。利用者の入力と文書に含まれるプロンプトインジェクションの検出。文書側の検出はデフォルトで無効
機能の範囲と対応する言語は製品ごとに異なり、更新も多いため、導入する側が導入時に公式の文書で確認します。
未対応の言語や機能を前提に製品を選定すると、必要な判定を実装できないためです。
製品の判定は、自社の業務の日本語の実例で誤検知と見逃しを自社で測定してから採用します。
業務固有の規則は、製品の判定に依存させず、操作するシステムの側に実装します。
たとえば金額の上限や送信先の許可リストです。
効果とコスト・リスク
効果
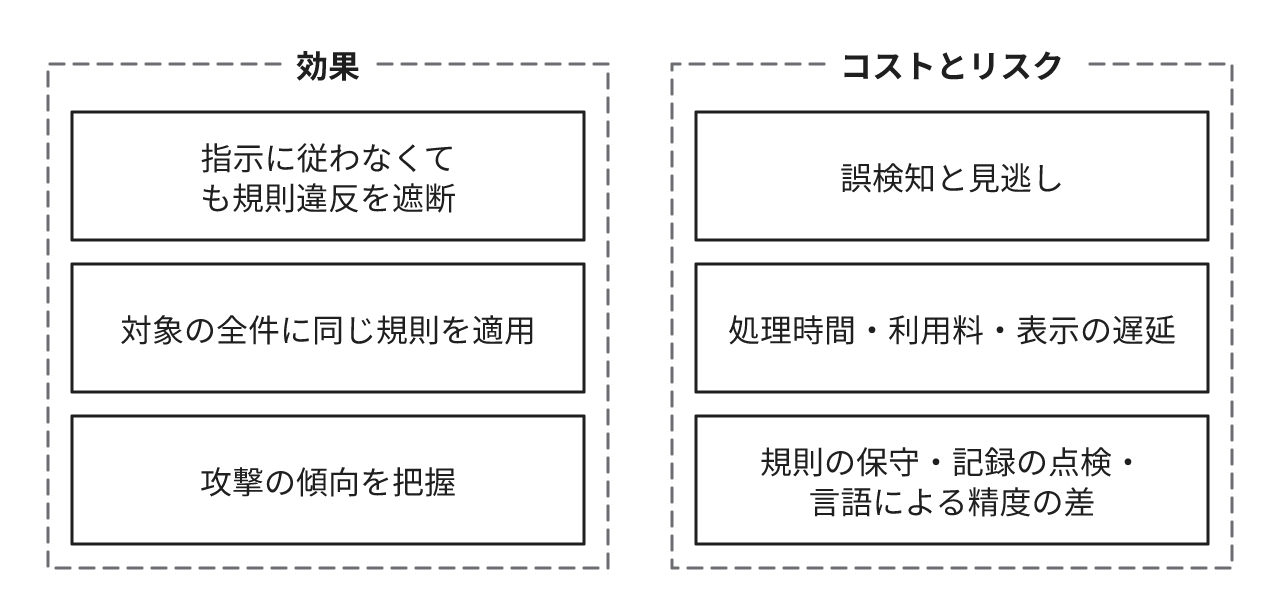
- AIがプロンプトの指示に従わなかった場合にも、規則に反する入力と出力を遮断できる
- 判定の対象とした入力と出力の全件に同じ規則を適用でき、人が確認する件数を削減できる
- 記録の機能を有効にすれば、遮断した入力と出力から攻撃の試みや誤りの傾向を把握できる
コストとリスク
- 誤検知。正当な問合せを攻撃や対象外と判定して回答を拒否すると、利用者の不満と、別の窓口への問合せの増加を招く
- 見逃し。言い換えや未知の手口は判定を通過する
- 処理時間と利用料の増加。分類器やLLMによる判定は、1件ごとに処理時間と費用が増加する
- 表示の遅延。回答を生成しながら表示する画面で出力を判定すると、全文の判定まで表示を保留するか、途中まで表示してから停止するかの選択が必要。後者では停止の前の部分が利用者に表示される
- 遮断した記録の点検。誤検知かどうかの確認と規則の修正に、担当者の人件費が継続的に発生する。記録には個人情報を含む入力も保存されるため、保存期間と閲覧者の決定が必要になる
- 規則の保守。対象外の話題、許可する送信先、上限の値は業務の変化に対応した更新が必要になる。更新が遅延すると、廃止した送信先への送信や旧来の上限での支払いを許可する
- 言語による精度の差。Prompt Shieldsの攻撃の検出モデルは主に英語の内容で学習・評価されており、英語以外の内容では検出の性能が異なる可能性がある。Microsoftは利用する言語ごとの評価を推奨している
ガードレールの限界と組み合わせ
ガードレールだけで攻撃と誤りを防止できる前提にはしません。
判定には誤検知と見逃しの両方が発生し、判定の基準を変更して一方を削減すると、もう一方が増加することがあります。
基準を厳しくすると遮断する範囲が拡大して正当な入力も遮断し、緩くすると範囲が縮小して攻撃も通過するためです。
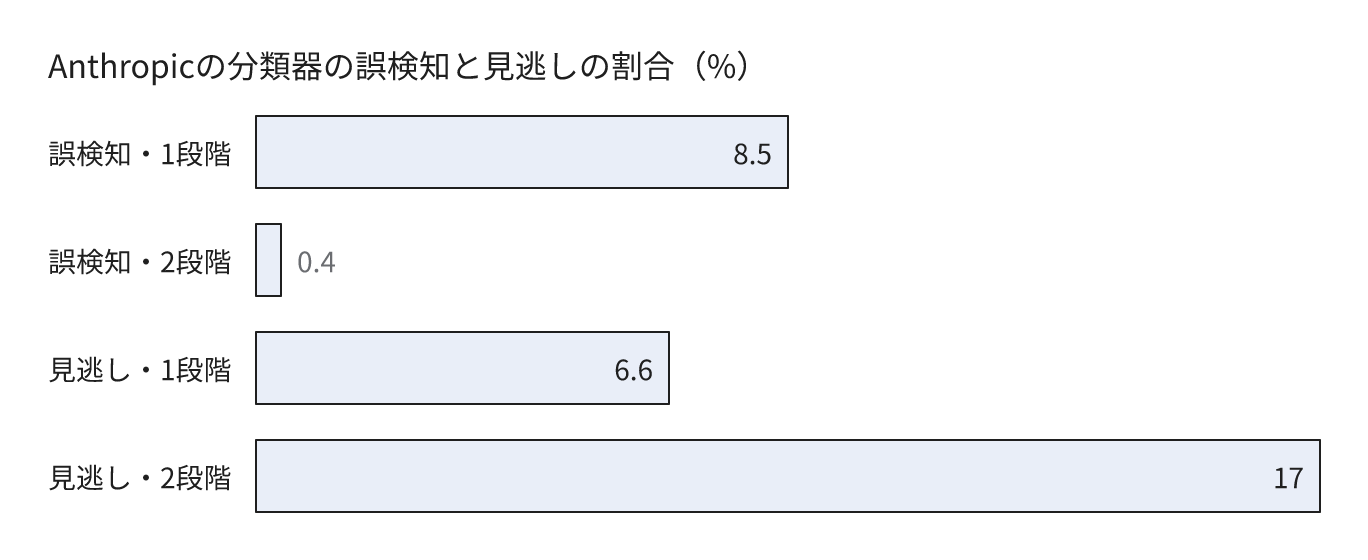
AIエージェントの危険な操作を判定するAnthropicの分類器では、2段階目の判定の追加で誤検知の割合が8.5%から0.4%に減少しました。
一方、過剰な操作の実例52件での見逃しの割合は6.6%から17%に増加しました。
そのため、ガードレールは次の対策と併用します。
- 権限の限定。最小権限の原則に従い、AIが閲覧できるデータと実行できる操作を業務に必要な範囲に限定し、見逃しが発生しても被害の範囲を制限する
- 人の承認。取り消し不能な操作はガードレールの判定を通過した後も実行の直前に人が承認する
- 評価。誤検知と見逃しの割合を、正当な入力と攻撃の実例を収集した課題で測定する
どこまでガードレールを厚くするか
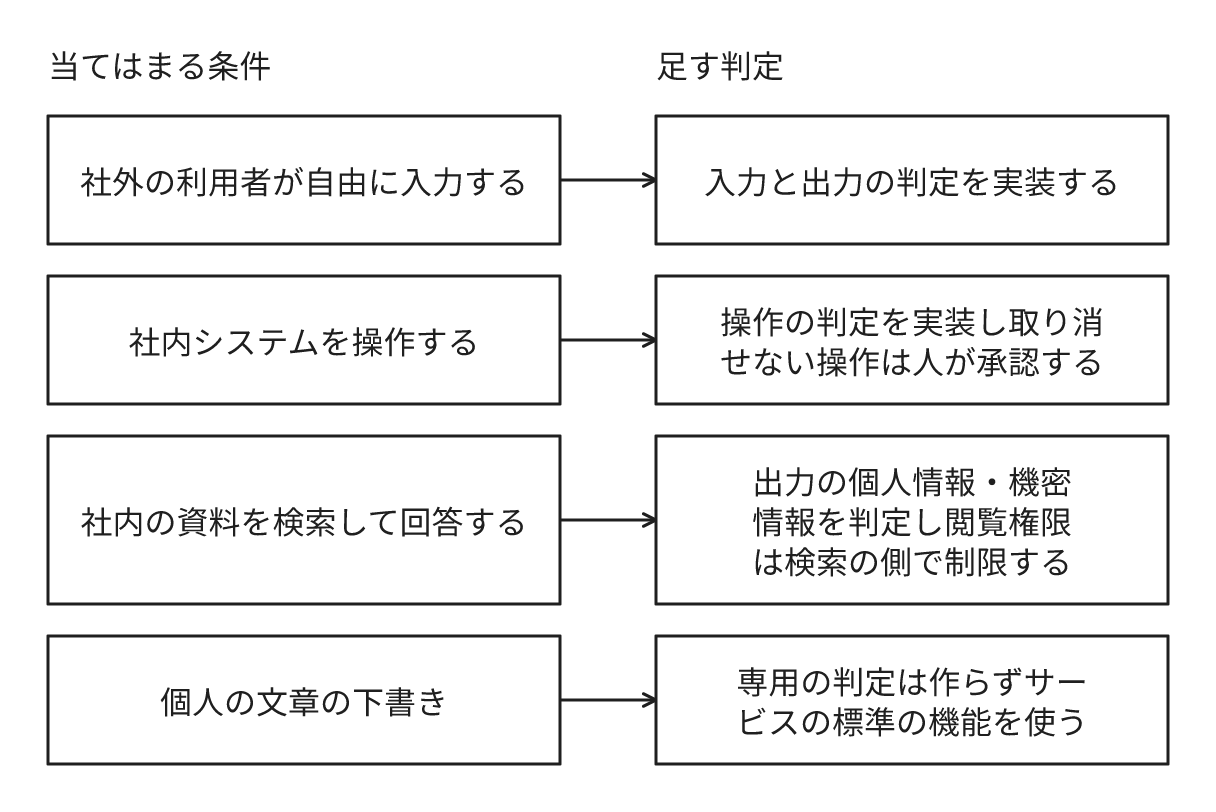
社外の利用者が自由に入力できるAIには入力と出力の判定を、社外への送信や社内システムを更新するAIエージェントには操作の判定も、公開の前に実装します。
社員が社内の資料を検索するだけのAIは、個人情報と機密情報の出力の判定から開始し、誤検知で業務を停止させない範囲に限定します。
| 用途 | 実装する判定 |
|---|---|
| 社外の利用者が自由に入力するAI | 入力の攻撃と対象外の話題、出力の有害な表現・個人情報・参照資料との不一致 |
| 社内システムを操作するAIエージェント | 操作の種類・宛先・金額の上限の判定、外部から取得した文書の攻撃の検出。取り消し不能な操作は人の承認と併用 |
| 社員が社内の資料を検索するAI | 出力の個人情報・機密情報の判定。閲覧権限は検索の仕組みの側で制限する |
| 個人の文章の下書き | 専用の判定は不要。利用するサービスの標準の機能を利用し、社外への提出の前に利用者が確認 |
判定の基準を厳しくするか緩くするかは、誤検知と見逃しのどちらの損失が重大かで決定します。
不適切な表現の出力による損失が重大な用途は、見逃しの削減を優先します。
たとえば社外の顧客に回答するAIです。
社員の業務の支援で回答の拒否が業務を停止させる用途は、誤検知の削減を優先します。
誤検知の影響は1日の件数と誤検知の割合の積で見積もります。
たとえば1日1,000件の問合せで誤検知が1%なら、正当な問合せを1日10件拒否します。
遮断した問合せを有人の窓口に引き継ぐか、定型文で終了するかも、この件数で決定します。
公開の前に、割合を測定してから基準を決定します。
攻撃の実例は数十件から開始できます。
一方、1%前後の誤検知の割合を、統計の計算上、95%の信頼区間で前後0.5ポイント程度の幅で測定するには、本番に近い正当な入力が約1,500件、2つの設定の誤検知の割合を比較するなら各数千件程度必要です。
たとえば誤検知が1%なら300件では誤検知が3件前後しか発生せず、1件の増減で割合が0.3ポイント変動するためです。
よくある誤解
ガードレールを導入すれば回答の正確さも保証される
ガードレールが判定するのは、事前に定めた規則に違反するかどうかです。
参照資料との不一致の検出は、回答が資料に記載のない内容を含むかを判定するだけで、資料そのものの誤りや、資料にない質問への誤答は判定できません。
回答の正確さは実例の課題で評価し、影響が重大な回答は人が確認します。
ガードレールは厳しく設定するほど被害を防止できる
判定を厳しくすると正当な依頼も拒否する誤検知が増加します。
回答の拒否が連続すると利用者は業務の遂行のために、承認されていない別のAIサービスを利用するおそれがあります。
誤検知と見逃しの割合を実例で測定し、用途の損失に応じて基準を決定します。
関連用語
生成AI
成熟度:
大規模言語モデル
成熟度:
AIエージェント
成熟度:
エージェントハーネス
成熟度:
プロンプトインジェクション
成熟度:
ハルシネーション
成熟度:
ヒューマンインザループ
成熟度:
LLMの評価(eval)
成熟度:
RAG
成熟度:
同じ分野の用語
AI・機械学習の用語をすべて見るお問い合わせ・ご相談
システム開発、データ活用、プロダクトづくりのことならお気軽にご相談ください。要件が固まる前の整理や、お見積もりだけのご依頼も承ります。