
LLMの評価(eval)とは
LLMの評価(eval)は、LLM(Large Language Model)を組み込んだシステムに用意した課題を入力し、出力を事前に定めた合格の基準で採点して、品質を測定する仕組みです。
英語ではevaluationの略称でevalと呼びます。
評価は多数の課題で構成し、1件の課題は入力と合格の基準の組です。
たとえば問合せを5種類に分類するAIなら、過去の問合せ200件と正解の分類を用意し、AIの分類と一致した割合を算出します。
社内規程に回答するAIなら、質問ごとに回答に含めるべき条件と引用すべき規程を合格の基準にし、回答がそれを満たすかを判定します。
同じ課題をモデルやプロンプトを変更する前と後で実行し、合格の割合を比較します。
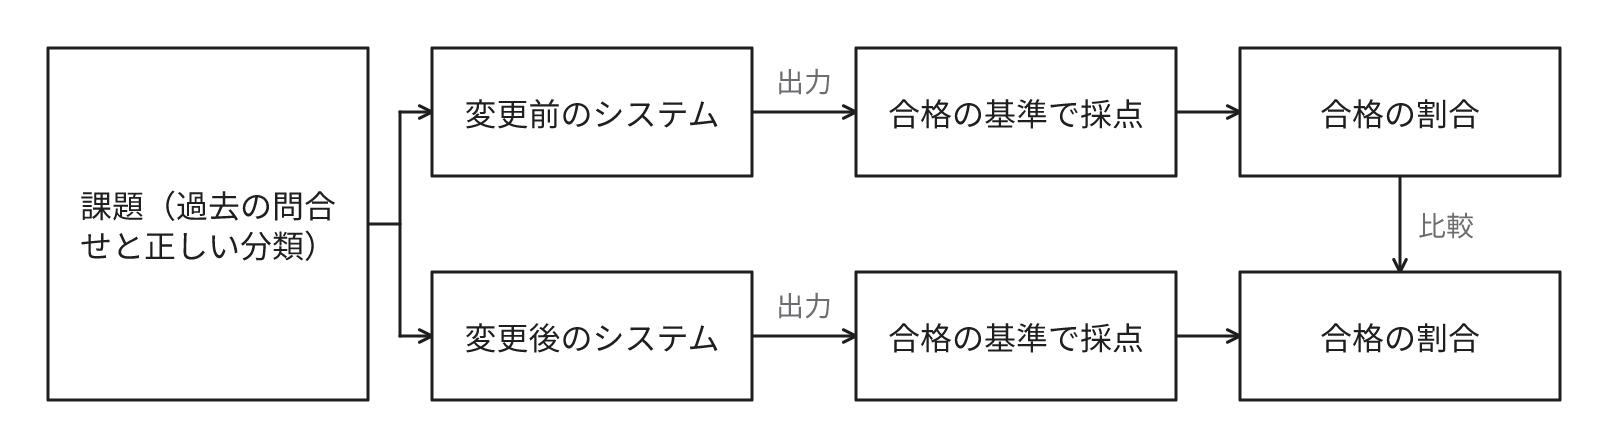
業務の手順を変更するたびに、過去の実際の案件で作成した同じ確認テストを担当者が受験し、理解度が低下していないかを確認する仕組みに近いものです。
公開されている課題集でモデルどうしを比較するAIベンチマークも評価と呼ばれますが、自社の業務での品質は保証しません。
業界のベンチマークと、自社のアプリケーションの性能を測定する評価は別のものです。
この記事の評価は後者を指します。
本番の出力を後から観察する監視とも異なり、評価は用意した課題で、変更を公開する前に品質を測定します。
試用の印象ではLLMの出力の品質を判定できない理由
LLMは同じ入力に対して実行ごとに異なる出力を生成することがあります。
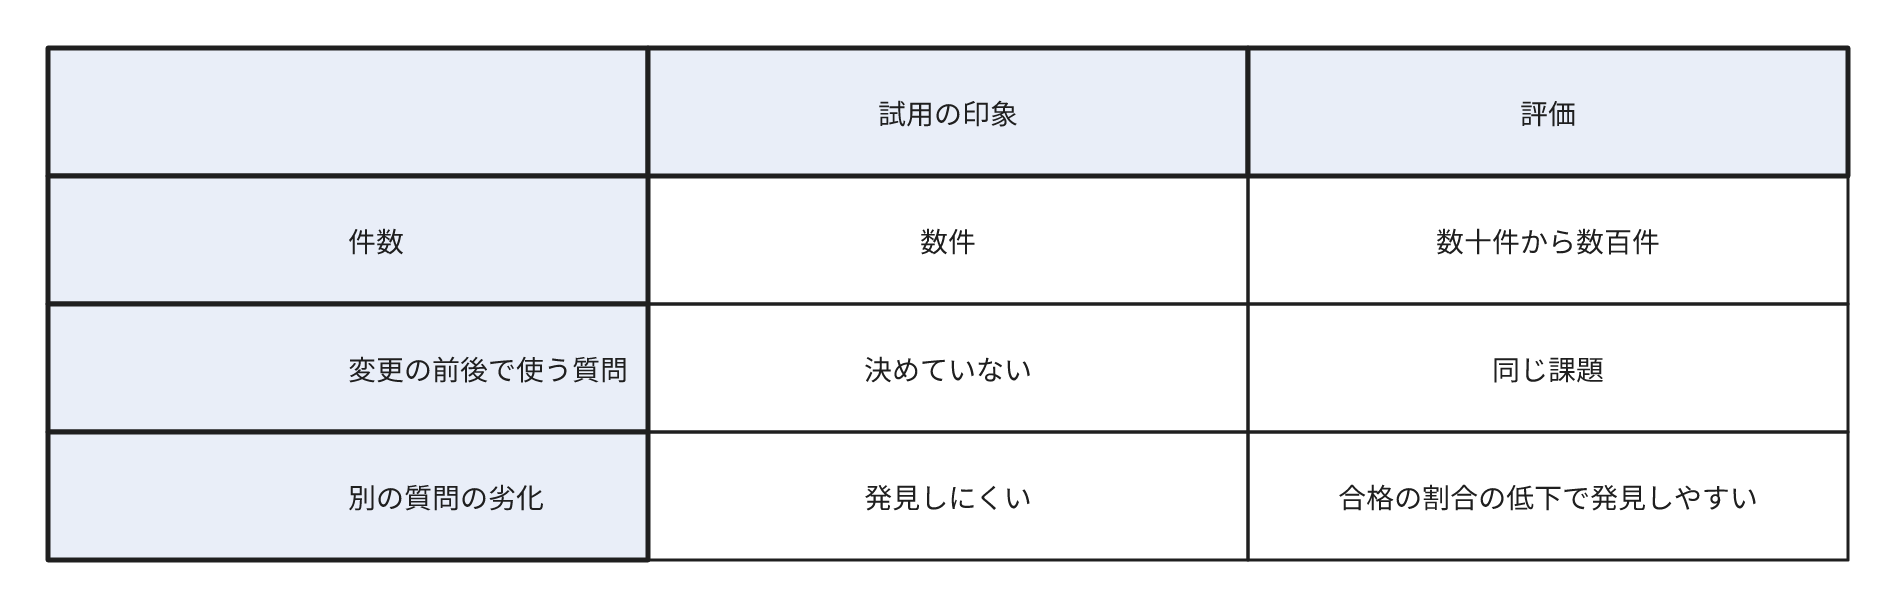
数件の試用で良好だという印象だけでは、偶然うまく回答した結果か、安定して回答できる結果かを区別できません。
OpenAIは正常に稼働しているという印象で判断する評価や、公開まで評価を作成しない進め方を、避けるべき例としています。
変更による劣化も印象では発見しにくくなります。
プロンプトの1文を修正して特定の質問への回答を改善すると、別の種類の質問への回答が劣化することがあります。
1つのプロンプトの指示は修正の対象ではない質問の回答にも影響するためです。
Anthropicは評価がない状態では利用者の苦情の受付後に手作業で再現し、修正後に別の箇所の劣化がないことを期待するだけになると説明しています。
モデルの提供者による更新でも、同じ問題が発生することがあります。
Anthropicは評価のないチームが新モデルの検証に数週間を要する一方、評価のあるチームは数日でモデルを移行できると説明しています。
APIで利用するモデルはバージョンを指定して固定できる場合がありますが、Anthropicなどの提供者は旧バージョンの提供を定期的に終了するため、移行の判断が必要になります。
評価を構成する要素
評価は課題、採点の方法、結果の記録の3つで構成します。
課題は実際の業務から収集します。
よくある依頼のほかに、過去に誤回答した事例、回答してはいけない質問、合格か不合格かの判断が条件によって分岐する質問を含めます。
採点の方法は3種類あり、長所と短所が異なります。
| 採点の方法 | 対象 | 短所 |
|---|---|---|
| プログラムによる判定 | 分類の一致、数値、形式、テストの合否、操作の結果 | 正解と表現が異なる正答を不合格にする |
| LLMによる採点 | 要約の要点の網羅、回答の丁寧さ、参照資料との整合 | 実行ごとに判定が変動し、長い回答を高く採点するといった偏りがあるため、人の判定との一致を確認する必要がある |
| 人による採点 | 専門的な判断、採点の基準そのものの確認 | 時間と費用がかかり、件数の増加が困難 |
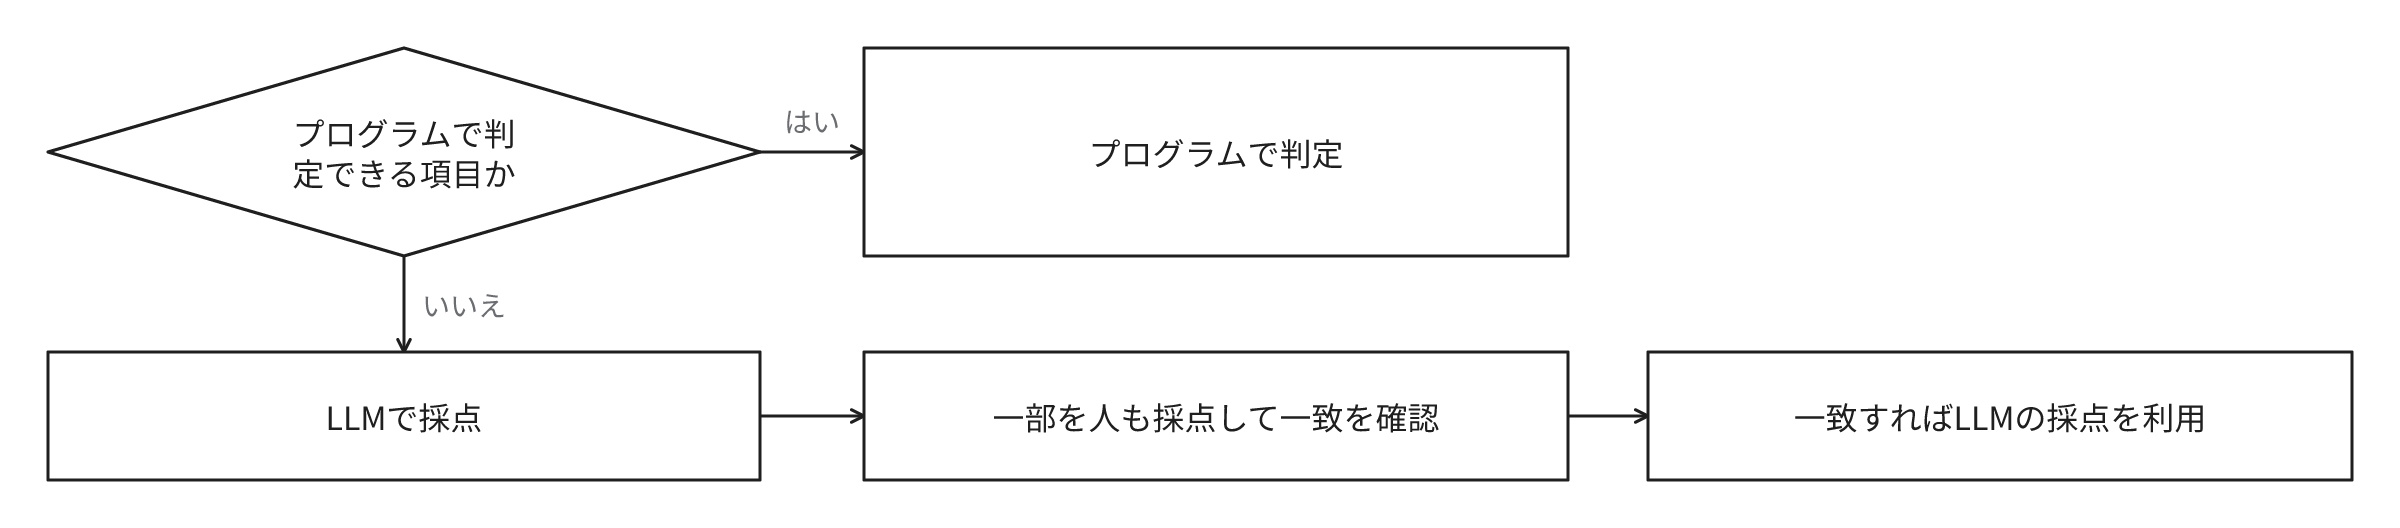
LLMによる採点はLLM-as-a-Judgeとも呼びます。
判定できる項目はプログラムで判定し、LLMによる採点は、人が採点した一部の課題と判定が一致するかを確認してから利用します。
LLMの出力は実行ごとに変動するため、Anthropicは1つの課題を複数回実行して結果を安定させています。
合格の割合は課題の件数が少ないほど偶然で変動します。
たとえば各課題を独立とみなし、200件で合格の割合が80%前後の場合に95%の信頼区間を求めると、同じ品質でも偶然によって前後5ポイント程度の幅で変動します。
この幅の範囲内の差は改善とみなさず、複数回の実行の平均で比較します。
AIエージェントでは最後の回答だけでなく結果の状態も確認します。
予約のエージェントが予約が完了したと回答しても、予約のデータベースに予約が存在しなければ不合格です。
効果とコスト・リスク
効果
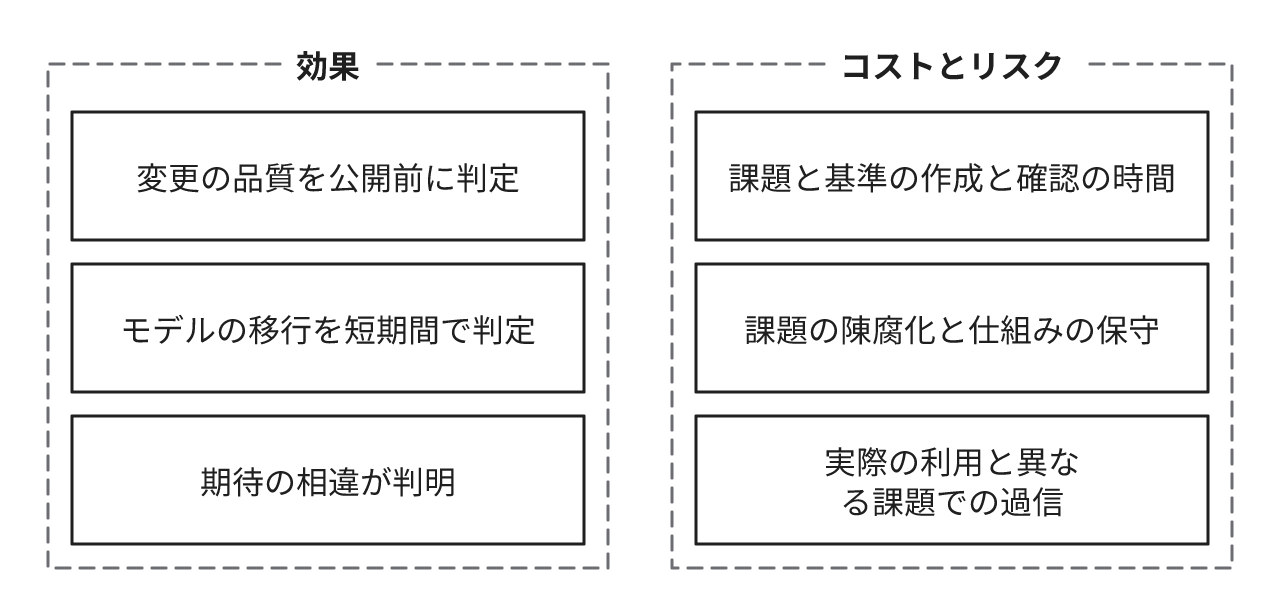
- モデル、プロンプト、参照資料を変更したときの品質の変化を、公開前に数値で判定できる
- 新モデルへの移行の可否を、自社の業務の実例で短期間に判定できる
- 開発の前に合格の基準を決定すると、担当者の間の期待の相違が判明しやすくなる
- 1件あたりの費用、処理時間、誤答率を同じ課題で継続して記録できる
コスト
- 課題と合格の基準の作成。業務を理解した担当者の時間が必要になる
- 結果の確認。変更のたびに、不合格の課題の出力を担当者が確認する時間が発生する
- 採点の費用。LLMによる採点は課題の件数と実行回数に比例してモデルの利用料が増加する
- 評価の仕組みの保守。課題を自動で実行し、結果を記録する仕組みも、モデルやシステムの変更に対応して改修する
リスク
- 本番のデータの取り扱い。本番の入力を課題に転用すると、個人情報や機密情報が評価の環境に複製される
- 課題の陳腐化。業務や規程が変更されると合格の基準が陳腐化し、更新しないと誤りを含む基準で合否を判定する
- 過信。課題が実際の利用と異なる場合や、プロンプトを特定の課題に過剰に適合させた場合、評価で合格しても本番で失敗する
- 採点の誤り。LLMによる採点は人の判定と一致するかを定期的に確認しないと、誤りを含む点数を継続して出力する
どこまで評価を作成するか
業務に組み込み継続して利用するなら、公開の前に、実例の課題と合否の基準を用意します。
Anthropicは実際に発生した失敗から収集した20〜50件の課題で開始することを推奨しています。
運用中に発生した失敗を課題に追加し、目安として数百件程度まで拡大します。
作成の工数は課題1件の入力と合格の基準の作成時間と件数の積で見積もります。
たとえば1件15分で50件なら、約12.5時間です。
一度だけの資料の下書きや、担当者が全件を確認してから利用する個人の作業支援には、専用の評価は不要です。
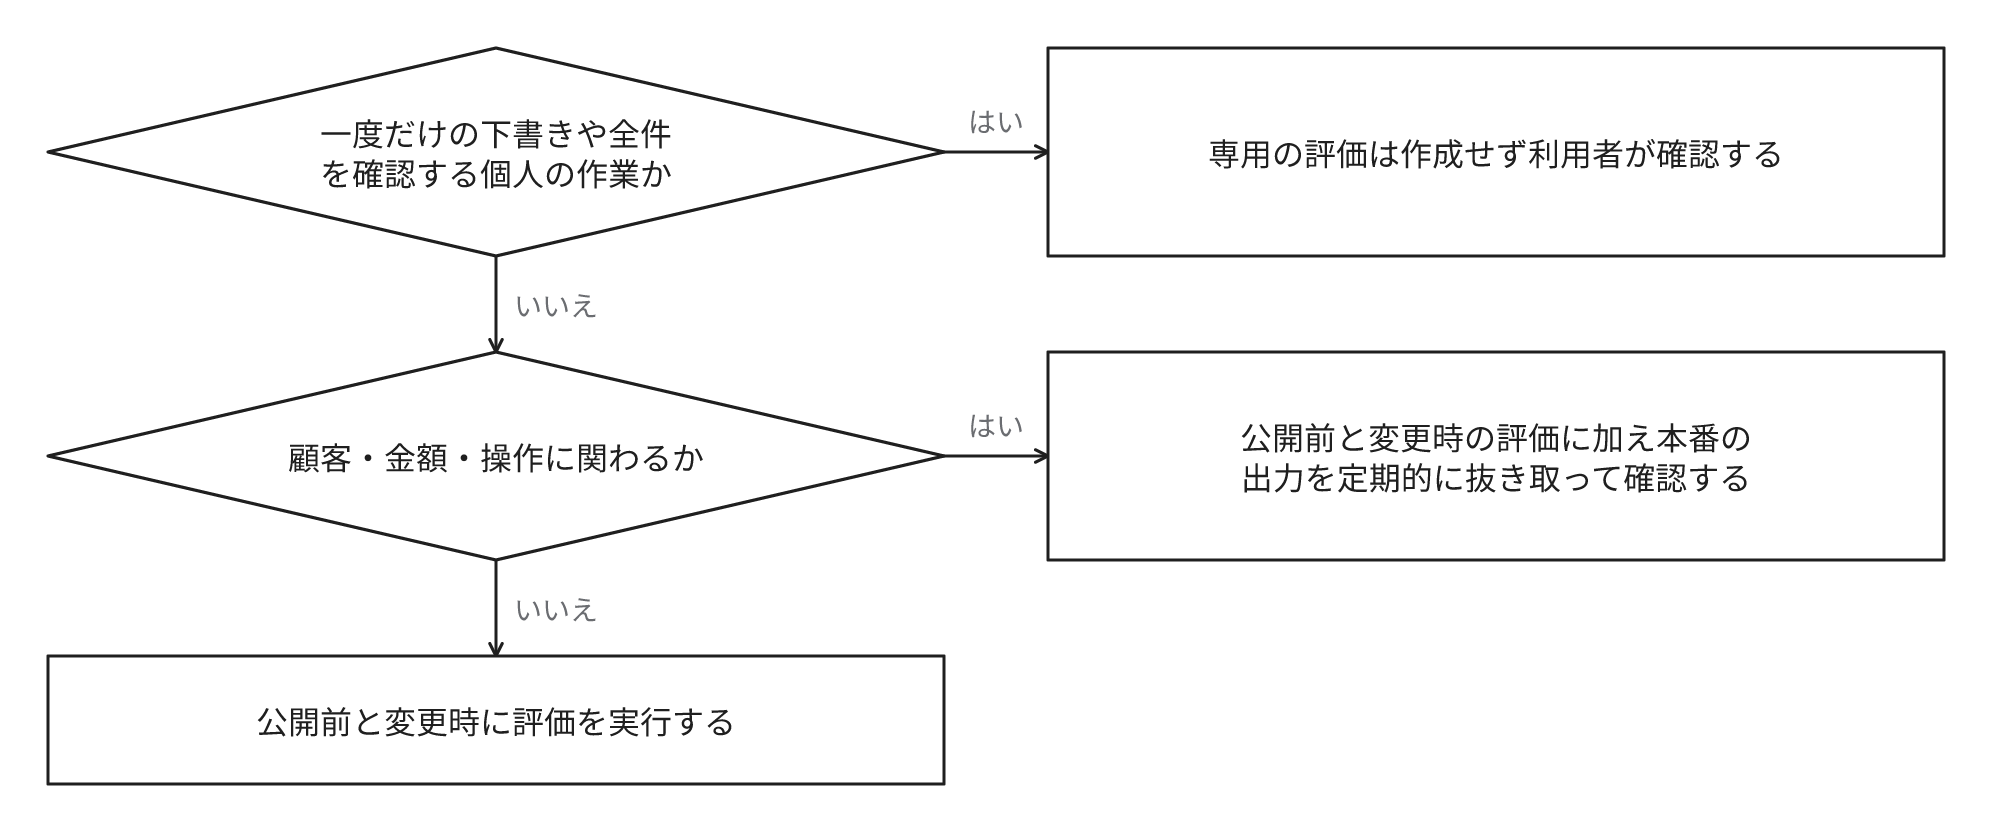
評価を作成する範囲は誤りの影響で決定します。
| 用途 | 評価の範囲 |
|---|---|
| 顧客への回答、契約や金額に関係する処理、システムを操作するAIエージェント | 公開前の評価、変更のたびの再実行、本番の出力の定期的な抜き取り確認 |
| 社内の問合せ対応、会議資料の要約 | 公開前の評価と、モデルやプロンプトの変更時の再実行 |
| 個人の下書き、アイデア出し | 専用の評価は作成せず、利用者が確認する |
評価は次のいずれかが発生したときに再実行します。
- モデルの変更、またはモデルの提供者による更新
- プロンプト、参照資料、ツールの変更
- 本番で新種の失敗が発生したとき
公開の可否は、AIの不合格の割合と、同じ課題を現在の担当者が処理したときの誤答率を比較して決定します。
現在の担当者より誤りが多ければ、AIに置換するとその業務の誤りが増加するためです。
誤りの影響が重大な課題は種類を区別して集計し、全体の合格の割合が高くてもその種類で失敗があれば公開しません。
回帰の評価は以前に合格した課題が変更後も合格するかを確認する評価です。
Anthropicは回帰の評価はほぼ100%の合格の割合を維持すべきだとしています。
合格の割合が低下した変更は利用者への影響を避けるため、原因を特定するまで公開しません。
本番の出力の抜き取り確認で発見した失敗は、同じ種類の課題として評価に追加します。
課題と正解は業務の担当者が作成する
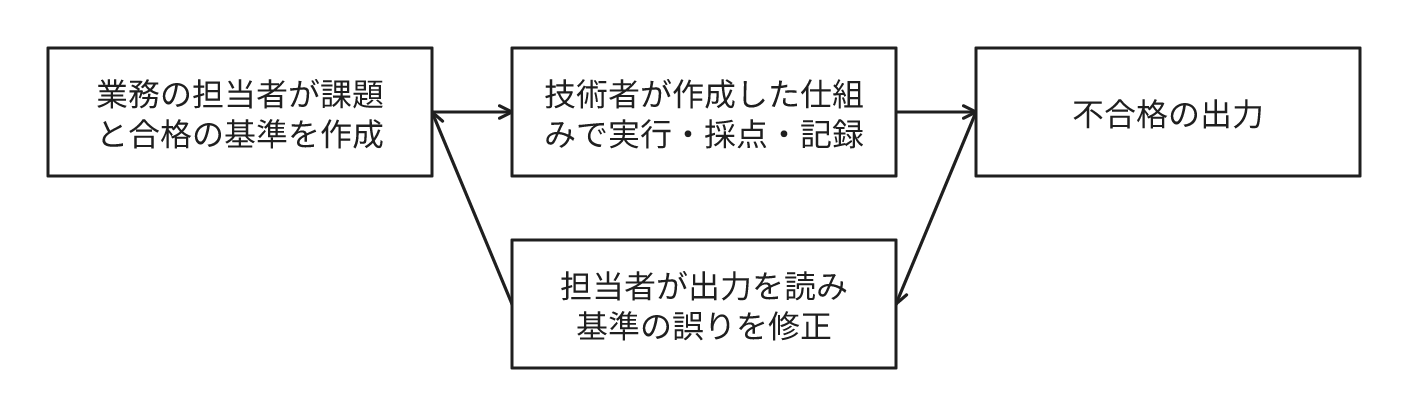
課題と合格の基準は業務の担当者が作成します。
技術者だけで作成すると課題が技術的に判定しやすい質問に偏重し、業務で重要な例外の扱いが欠落しやすくなります。
Anthropicも製品の要件と利用者に最も近い人が成功の定義に最も適任であるとしています。
技術者は課題を自動で実行する仕組み、採点の実装、結果の記録を担当します。
採点の結果だけでなく、不合格の課題でAIが実際に出力した内容を担当者が確認し、合格の基準に誤りがないかも確認します。
よくある誤解
評価で合格すれば本番の出力も同じ品質になる
評価は用意した課題の範囲でしか品質を示しません。
本番では課題に含めていない言い回し、新商品や新規の規程、想定外の操作が入力されます。
Anthropicも自動の評価は実際の利用と異なると過信の原因になると指摘しています。
公開後も本番の出力を抜き取りで確認し、発見した失敗を課題に追加します。
LLMに採点させれば人による採点結果の確認は不要になる
LLMによる採点は大量の課題を短時間で採点できますが、合格の基準の解釈に誤りが発生することがあります。
OpenAIは自動の採点を人の評価で較正するよう推奨しています。
人が採点した一部の課題とLLMの判定が一致するかを、合格の基準や採点に利用するモデルを変更するたびに確認します。
一致が確認できない間は、LLMの採点の結果で公開の可否を決定しません。
同じ分野の用語
AI・機械学習の用語をすべて見るお問い合わせ・ご相談
システム開発、データ活用、プロダクトづくりのことならお気軽にご相談ください。要件が固まる前の整理や、お見積もりだけのご依頼も承ります。