
AI推論とは
AI推論は、学習済みのAIモデルに、学習の後に新たにデータを入力して、予測値、分類の結果、生成した文章などの出力を得る処理です。
総務省と経済産業省のAI事業者ガイドラインは、推論を、学習済みモデルに未知のデータを入力して出力を得るプロセスと定義しています。
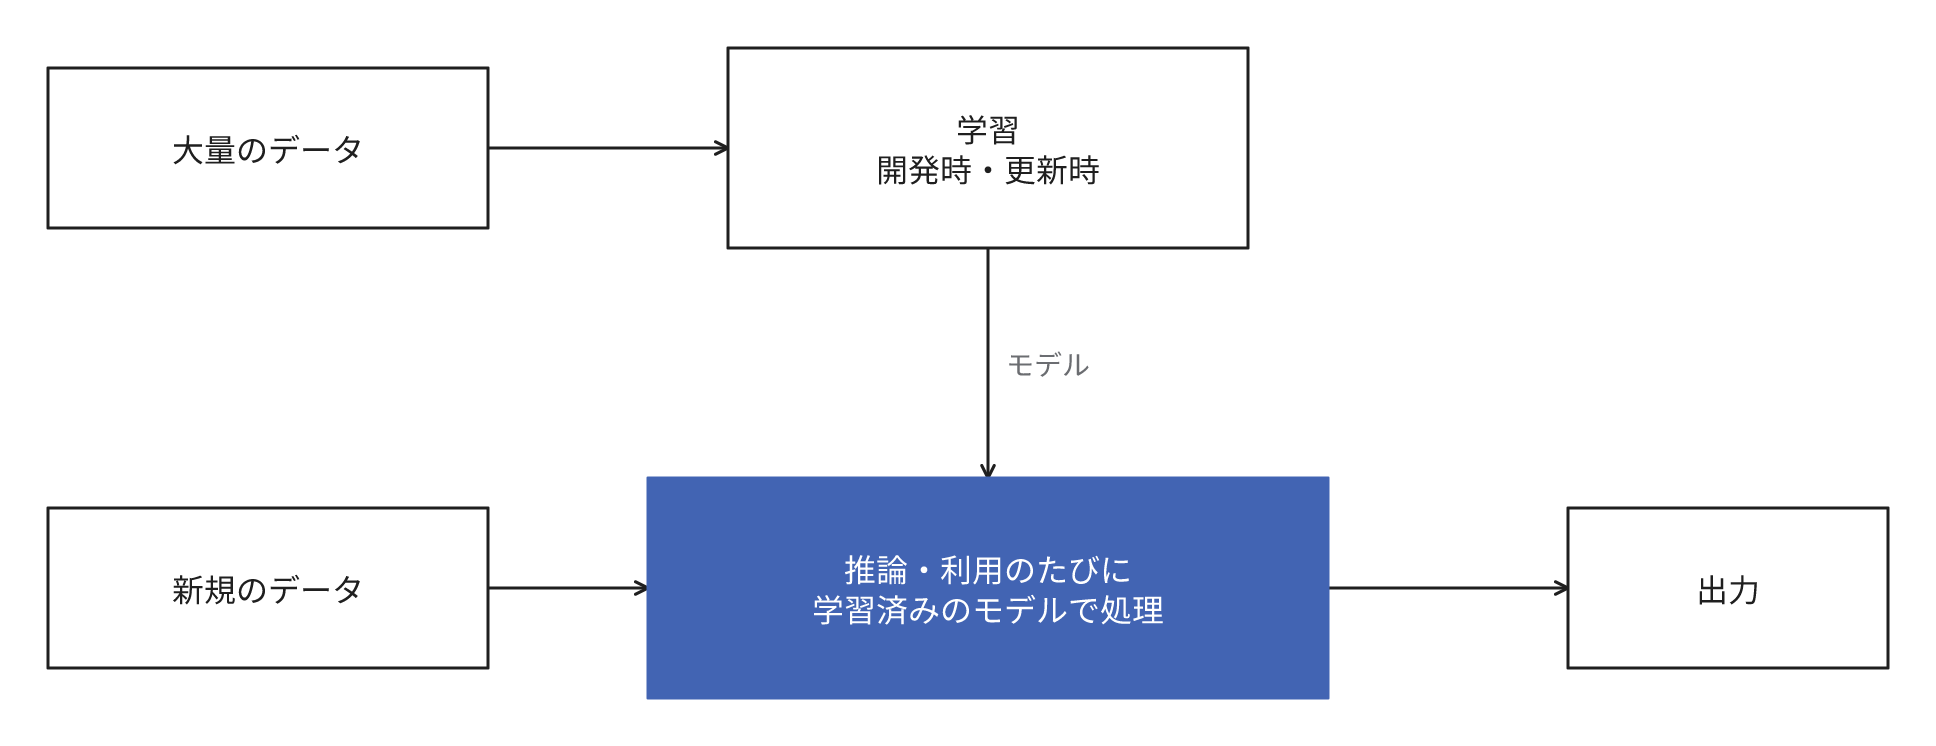
AIの利用は、大量のデータから入力に対する出力の傾向をモデルに学習させる段階と、そのモデルを業務で利用する推論の段階に区分されます。
たとえば社員がクラウドのチャットのAIに問合せの回答案を作成させるたびに、AIの提供者のサーバーでは推論が実行されます。
迷惑メールの判定、画像の検品で不良品を検出する処理、売上の予測も、学習済みのモデルを利用するたびに推論が実行されます。
推論はAIを業務で利用するたびに実行されるため、計算の費用と応答の待ち時間も推論のたびに発生し、従量課金のAPIでは推論のたびに利用料が発生します。
料理の比喩では、学習はレシピの開発と料理人の修業、推論は注文ごとに料理を調理して提供することに相当します。
推論モデルという語の推論は、回答の前にAIが内部で生成する思考の過程のことで、AI推論とは意味が異なります。
AI推論が業務の費用と体験を左右する理由
学習は、モデルを開発する時期や更新する時期に集中して実行されます。
推論は、AIを業務で利用するたびに発生し、利用が増加するほど処理の量も増加します。
1回の推論の計算量は学習よりはるかに少ない一方、推論を自社で実行する場合は、利用者が多いほど、遅延なく大量の推論を処理できる設備が必要になります。
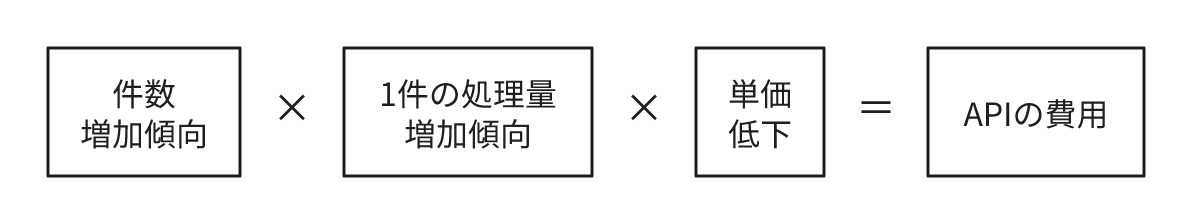
APIでLLM(Large Language Model)を利用する場合は、推論で処理した入力と出力の量に応じて利用料が発生します。
同じ性能のLLMの推論の費用は、GPT-3.5相当の性能のシステムで2022年11月から2024年10月までに280分の1以下に低下しました。
APIの単価が低下すると、同じ処理量に対するAPIの費用が減少し、購入した設備の費用は一定のため、設備の費用上の優位が縮小します。
APIでの費用の見積もりも、単価の改定のたびに再計算します。
一方、AIエージェントや推論モデルのように1件の依頼で多くの出力を生成する利用方法が増加し、1件あたりの処理の量は増加する傾向にあります。
利用者が体感する応答の速度は、通信や前後の処理の時間とともに、推論の処理時間に左右されます。
推論の処理が遅いと、利用者への応答と後続の処理が遅延します。
たとえばチャットの画面では回答の表示までの待ち時間が長くなり、業務システムでは処理の完了が遅延します。
LLMは出力をトークン単位で生成し、モデルの規模が大規模なほど1トークンごとの計算が増加し、思考の量や出力が長いほど生成するトークンが増加します。
そのため、即時の応答が必要な用途では小規模なモデルや少ない思考の量を選択します。
推論の実行場所と方式
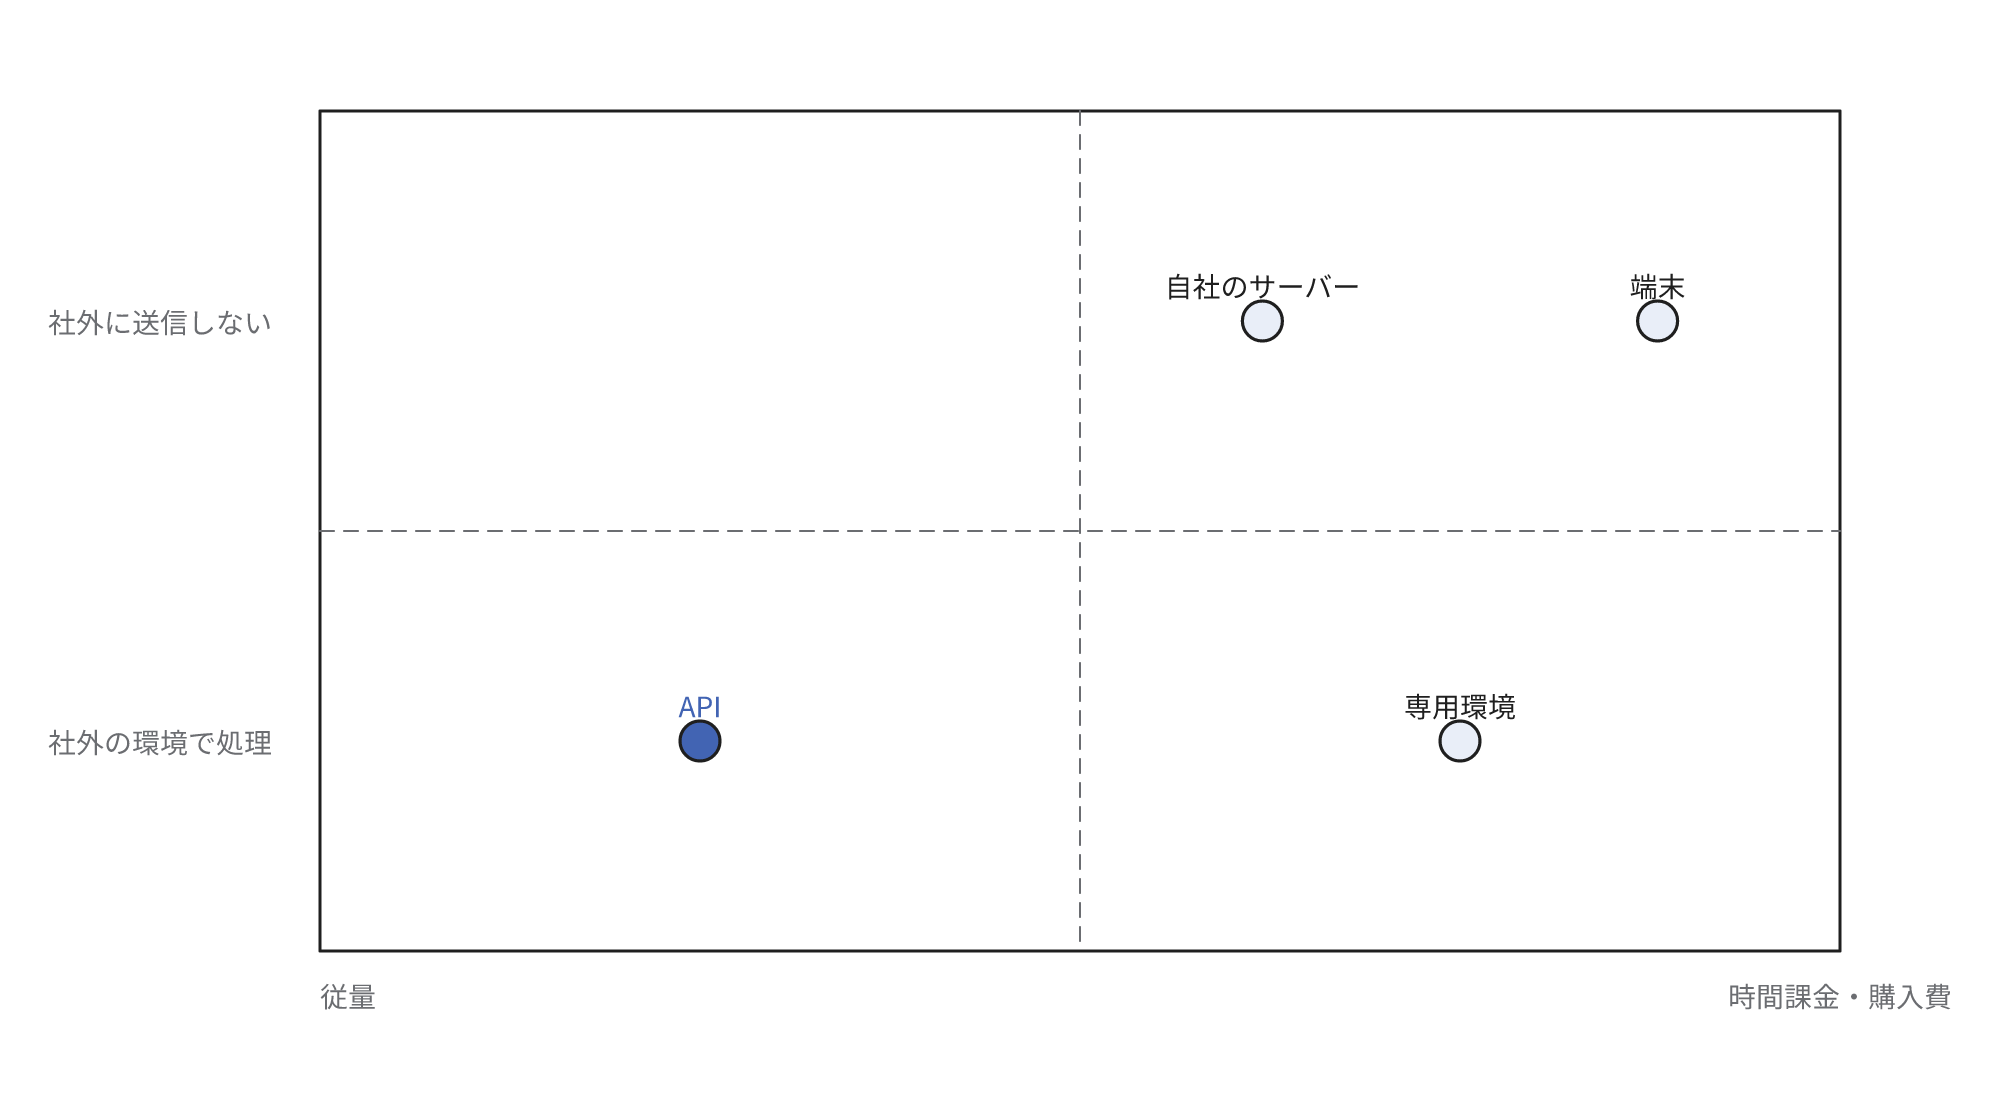
| 実行する場所 | 内容 | 利用する場合 |
|---|---|---|
| 提供者のAPI | AIの提供者やクラウドの事業者のサーバーで推論し、処理した量に応じて課金される | 利用量が変動する、すぐに開始したい、最新の高性能なモデルを利用したい |
| クラウドの専用環境 | クラウドの事業者の環境で自社専用の処理能力を確保し、時間単位で課金される。商用のモデルを選択できるサービスと、オープンウェイトモデルを自社で配置する形がある | データの処理場所や処理の量を自社で管理したい、利用量が多く安定している |
| 自社のサーバー | 自社が管理するサーバーにモデルを配置して推論する | 社外にデータを送信できない、ネットワークに接続できない環境で利用する |
| 端末上 | スマートフォン、PC、工場の機器などの端末上で推論する | 即時の応答が必要、通信を経由せずに処理したい |
APIは処理した量に比例して課金され、専用環境は確保した時間に課金されます。
自社のサーバーと端末の費用は機器の購入費と運用の費用で、利用量に比例しません。
端末上で推論すると、データをクラウドに送信せずに処理でき、通信の遅延と通信量に応じた費用を削減できます。
ただし端末の性能に応じた規模のモデルに限定されます。
自社が保有するサーバーで推論するには、重みが公開されたオープンウェイトモデルを利用します。
重みが公開されていない商用のモデルは自社のサーバーに配置できませんが、Amazon BedrockやAzure OpenAIのように、クラウドの中で自社専用の処理能力を確保して商用のモデルを利用するサービスがあります。
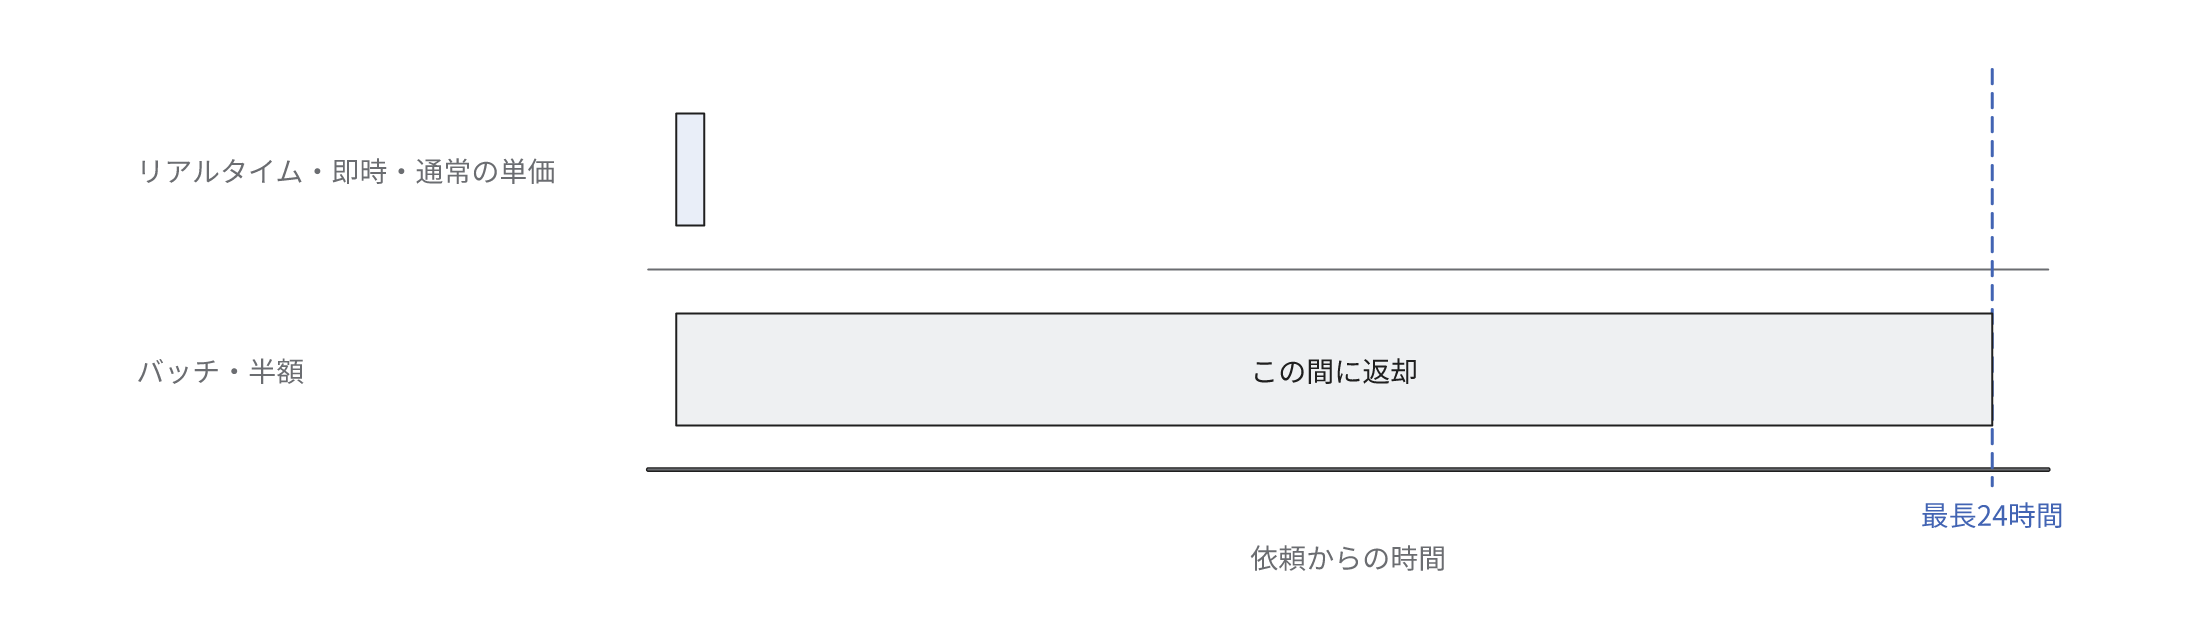
処理の方式には、依頼を受信するたびにすぐに処理するリアルタイムの推論と、大量の依頼を一括で処理するバッチの推論があります。
即時の応答が不要な処理は、バッチの推論にすると費用を削減できます。
2026年11月時点で、OpenAI、Anthropic、Googleのバッチ処理は、対応するモデルの単価が通常の半額です。
結果の返却までの時間は、OpenAIとAnthropicが最長24時間で、Googleは24時間を目標としています。
翌営業日の朝までに結果があればよい処理は、利用する会社の判断でバッチの推論に変更できます。
同じ前置きの指示や資料を反復して送信する処理は、プロンプトのキャッシュで入力の費用を削減できます。
キャッシュは、同じ先頭部分を含む入力を一定時間内に再び送信したとき、提供者がその部分を再利用し、単価を割引する仕組みです。
提供者によっては、初回の保存に割増しの単価がかかります。
問合せの分類や項目の抽出のような簡単な処理は、同じ提供者の小規模なモデルに変更すると、多くの場合は単価が低下します。
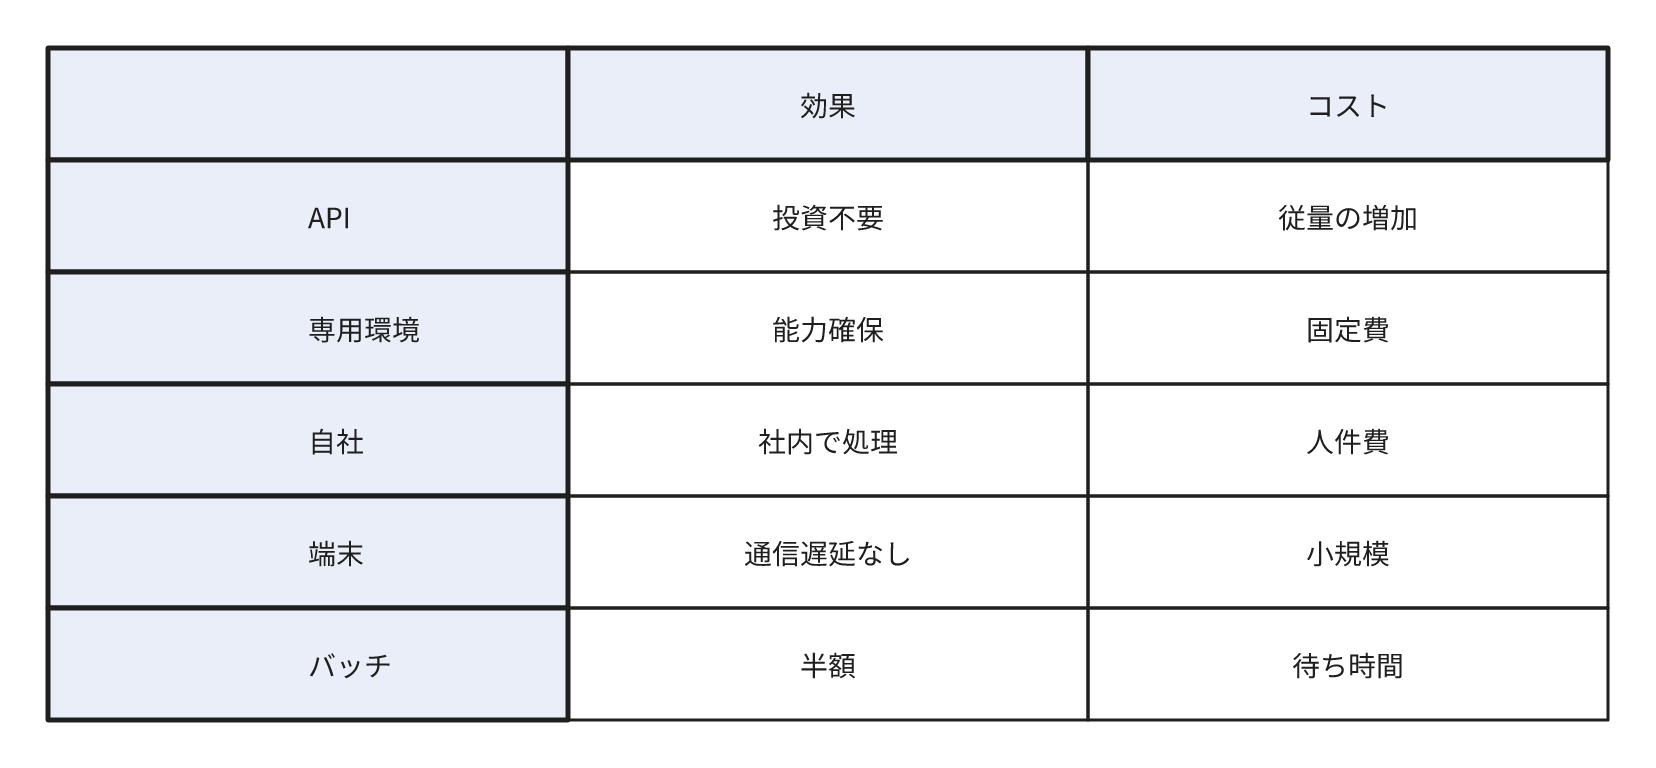
推論の場所と方式の選択による効果とコスト・リスク
効果
- バッチの推論では、対応するモデルの単価が低下する。2026年11月時点のOpenAI、Anthropic、Googleでは半額
- 端末上での推論は、通信の遅延がなく、ネットワークに接続できない環境でも稼働する
- クラウドの専用環境は、他の利用者と処理能力を共有しないため、利用の集中による待ち時間の増加を抑制しやすく、データを処理する地域を指定できる
コストとリスク
- 利用量に比例する費用。APIの従量の費用は、利用者と1件あたりの処理の量に比例して増加する。月の予算の上限と利用量の監視が必要になる
- 専用の処理能力の固定費。クラウドの専用環境は、利用の有無に関係なく確保した処理能力の分を時間単位で課金される。Amazon Bedrockでは1か月や6か月の契約期間を選択すると単価が低下するが、期間中は解約できない
- 自社で実行する場合の運用の費用。GPUを搭載したサーバーの購入または賃借とともに、モデルの更新、監視、障害対応の担当者の費用が必要になる
- データの送信先。提供者のAPIでは、入力したデータが提供者のサーバーで処理される。学習への利用や保存の条件は契約で確認する
- 応答の遅延。利用が集中すると、提供者のAPIの処理の上限や自社の基盤の能力を超えて、待ち時間の増加やエラーが発生する
- モデルの変更。提供者がモデルを更新、終了すると、同じ入力でも出力の傾向が変化する。自社で配置したモデルは変化しないが、性能の改善も自社で導入する必要がある
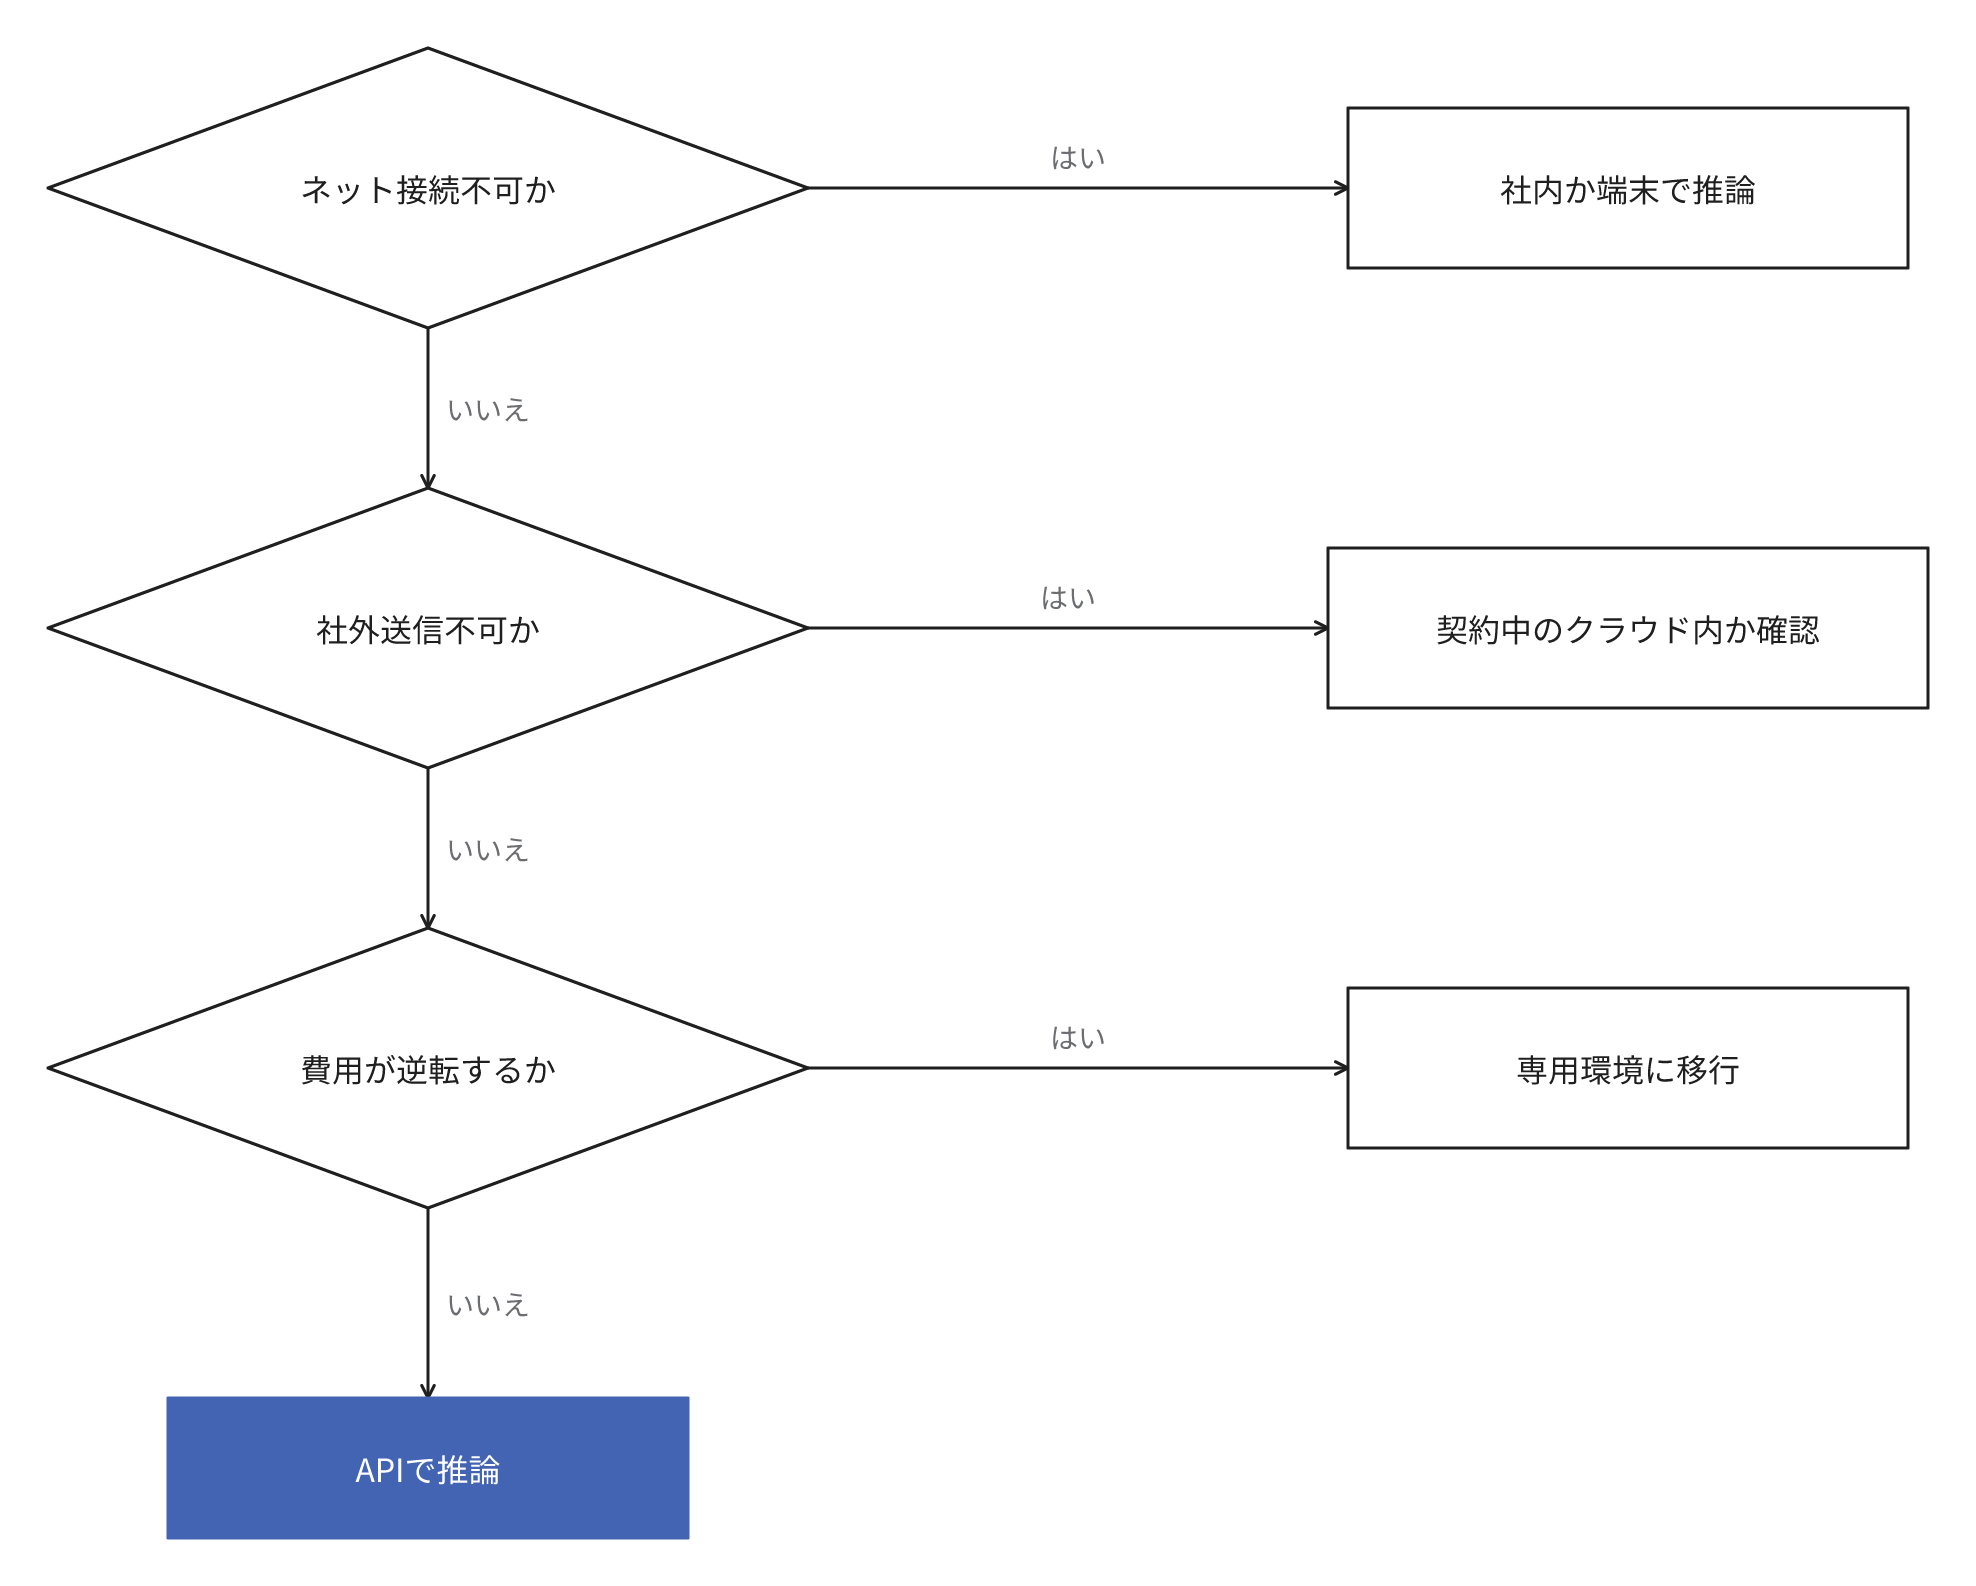
推論の実行方法の選び方
データの制約やネットワークの制約がない会社は、提供者のAPIでの推論から開始します。
初期の投資が不要で、利用量が少ない段階では費用も少額で、最新のモデルを利用できるためです。
次のどれかに該当する場合は、自社のサーバーやクラウドの専用環境での推論の費用を見積もり、APIと比較して採否を決定します。
- 契約や規程で、データを社外の提供者に送信できない。この場合も、すでに契約しているクラウドの中で商用のモデルを利用する形で条件を充足できるかを先に確認する
- 工場や店舗の機器など、ネットワークに接続できない環境で推論する
- APIの月の費用が、専用環境の稼働の費用と運用の担当者の費用の合計を継続して上回る
費用は、APIの月の費用と、専用環境の月の稼働の費用と運用の担当者の人件費の合計で比較します。
自社でGPUのサーバーを稼働させる場合も、AWSの米国東部のオンデマンドの料金で、GPU1基の構成で月に600〜1,400ドル程度、大規模なモデル向けのH100を8基搭載した構成では月に4万ドル程度になり、運用の担当者の費用が追加されます。
Microsoftの試算の例の単価、処理能力の1単位あたり月260ドルで計算すると、Azure OpenAIの専用環境は、最小の配置が15単位のモデルでも月3,900ドル程度になり、時間課金や地域を指定する配置ではこれより高くなります。
APIの月の費用がこの水準を下回るうちは、Azure OpenAIの専用環境に移行すると費用が増加する可能性が高くなります。
他のクラウドの専用環境も、最小の契約の単位と時間単価から同じ方法で月額を計算して比較します。
自社のサーバーも、GPUの費用と運用の担当者の人件費の合計がAPIの月の費用を下回るかで判断します。
専用環境は利用量が少ない時間帯も費用が発生するため、利用量の増減が日や時間帯で顕著な用途では、APIのほうが安価になることが多くなります。
自社で実行する場合は、オープンウェイトモデルの性能が業務の要件を満たすかを、自社の実例で評価してから決定します。
よくある誤解
AIを利用すると入力したデータでAIが学習する
推論はモデルを利用する処理で、推論の実行だけではモデルは変化しません。
入力したデータが学習に利用されるかは、推論の仕組みではなく、提供者の契約と設定で決定されます。
OpenAIのAPIのように、業務のデータを特に設定しなくても学習に利用しないと示す契約がある一方、個人向けの無料のプランでは条件が異なることがあるため、利用するプランの規約を確認します。
AIの利用者の費用は主にモデルの学習の費用である
APIでモデルを利用する会社がAIの利用料として負担するのは、主に推論の対価です。
推論の費用は利用のたびに発生し、利用が拡大するほど増加するため、導入の判断では、想定する件数と1件あたりの処理の量から月の費用を見積もります。
関連用語
機械学習
成熟度:
大規模言語モデル
成熟度:
生成AI
成熟度:
推論モデル
成熟度:
トークン(生成AI)
成熟度:
ファインチューニング
成熟度:
クラウド
成熟度:
オンプレミス
成熟度:
同じ分野の用語
AI・機械学習の用語をすべて見るお問い合わせ・ご相談
システム開発、データ活用、プロダクトづくりのことならお気軽にご相談ください。要件が固まる前の整理や、お見積もりだけのご依頼も承ります。