
コンテキストエンジニアリングとは
コンテキストエンジニアリングは、LLM(Large Language Model)が回答や作業の各段階で参照する情報を選択し、整理して入力する設計の取り組みです。
対象は指示文であるシステムプロンプト、参照する資料、それまでの会話の履歴、使用できるツールの定義と実行の結果、作業の記録です。
ここでのコンテキストは1回の処理でLLMに入力する情報の全体を指します。
限られた量の入力の中で、目的の結果を得られる組み合わせを検討します。
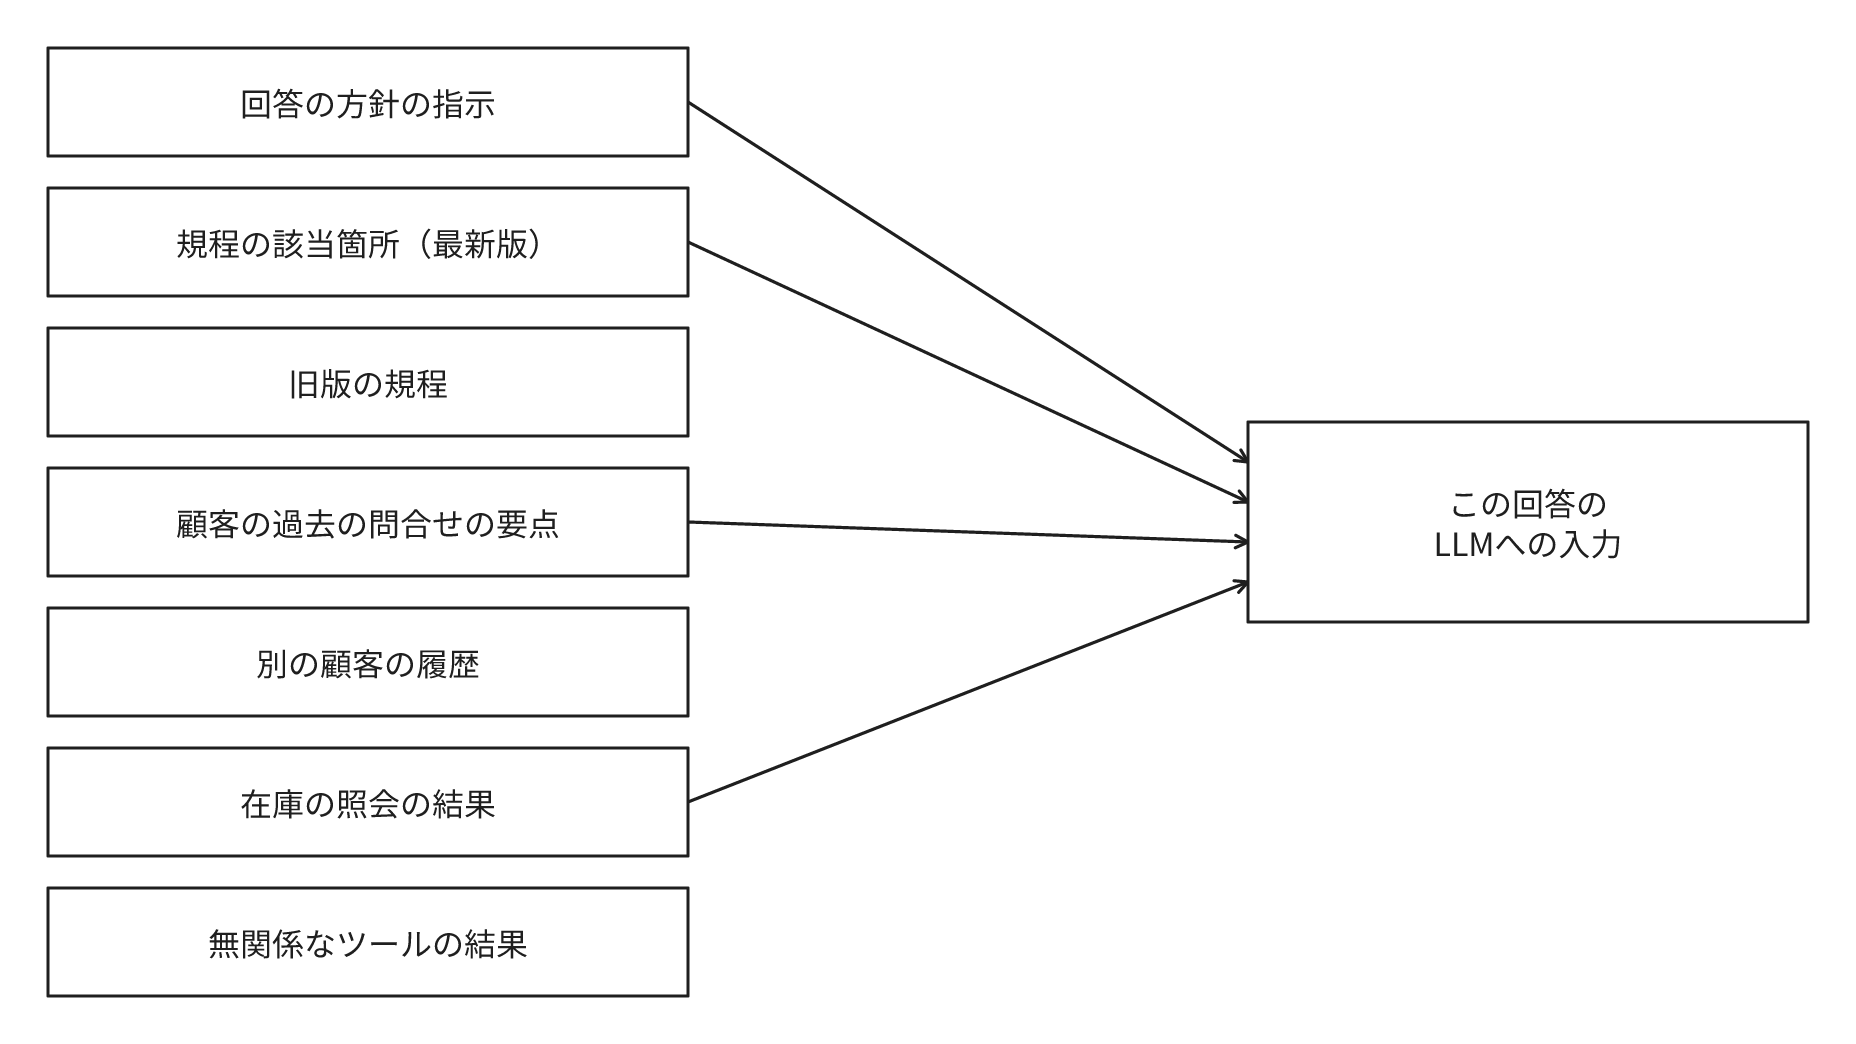
たとえば社内の問合せに回答するAIエージェントの入力は、回答の方針の指示、質問に関係する規程の該当箇所、顧客の過去の問合せの要点、在庫の照会の結果です。
これらを回答のたびに選択して入力します。
旧版の規程や回答に関係しない過去のやり取りまで入力すると、誤答と費用が増加します。
会議の前に、出席者の机に今日の議題に必要な資料だけを、参照する順に配置する作業に相当します。
プロンプトエンジニアリングの主な対象は、指示文の書き方です。
コンテキストエンジニアリングは指示文を含め、モデルに入力するすべての情報を対象とし、作業の進行に応じて入力の内容を選択し直します。
Anthropicは、プロンプトの作成を1つのまとまった作業とし、コンテキストエンジニアリングはモデルへの入力を決定するたびに反復すると区別しています。
作業の手順ごとに入力が増加する問題
LLMに入力できる情報の量にはコンテキストウィンドウという上限があります。
上限の範囲内でも入力が長いほど必要な情報が他の情報と混在し、抽出の精度が低下します。
程度の差はありますが、この低下はすべてのモデルで発生します。
AIエージェントが多数の手順で作業すると、ツールの結果と会話の履歴が手順のたびに蓄積します。
たとえば社内の文書を検索しながら報告書を作成させると、検索の結果、参照した文書の本文、途中の下書きが、すべて次の手順の入力に加算されていきます。
整理しない場合、入力は上限に接近し、必要な情報が不要な情報の中に混在し、毎回の費用と待ち時間も増加します。
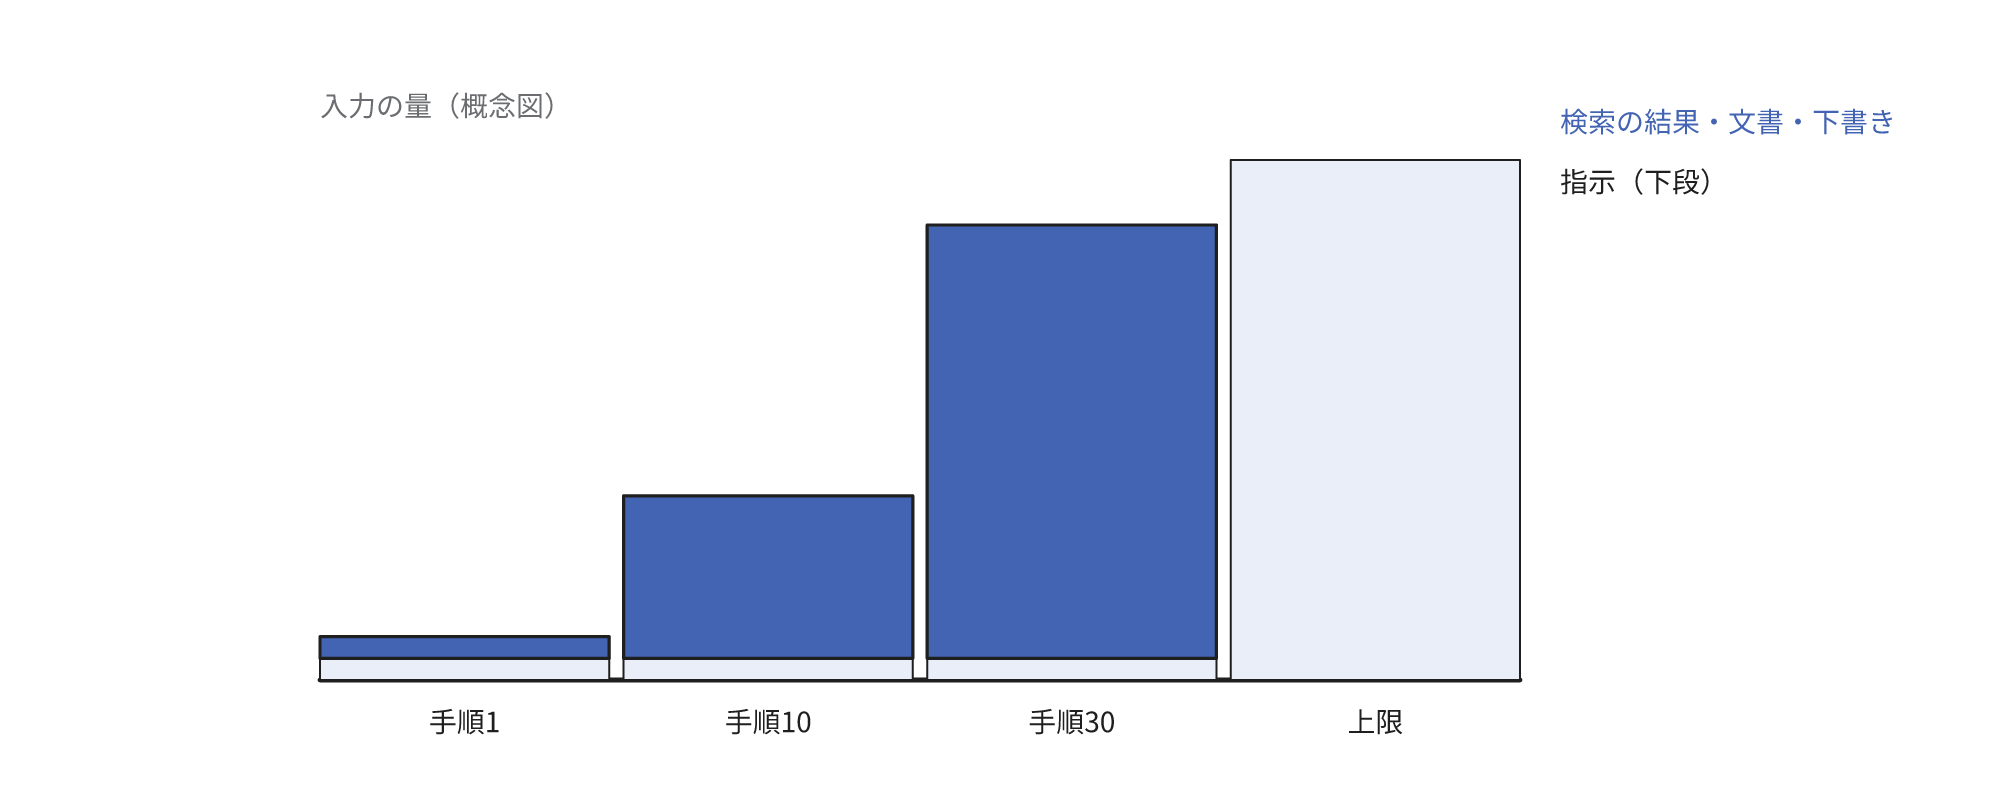
このためAnthropicは、入力を限られた資源として管理するよう求めています。
主な手法
| 手法 | 内容 | 用途の例 |
|---|---|---|
| 必要な資料の選択 | 質問に関係する資料だけを検索して入力に追加する。RAGはその代表的な方法 | 規程やマニュアルが多い問合せ対応 |
| 必要な時点での取得 | 資料の保管場所だけを指定し、AIが必要になった時点でツールで参照する | 数百件の議事録を保管した共有フォルダから、必要な回だけを参照する |
| 履歴の要約 | 上限に接近した会話の履歴を要約し、要約から作業を再開する | 長い会話、長時間の作業 |
| 作業の記録 | 進捗、決定事項、未解決の課題をファイルに記録し、後で参照する | 中断と再開を反復する作業 |
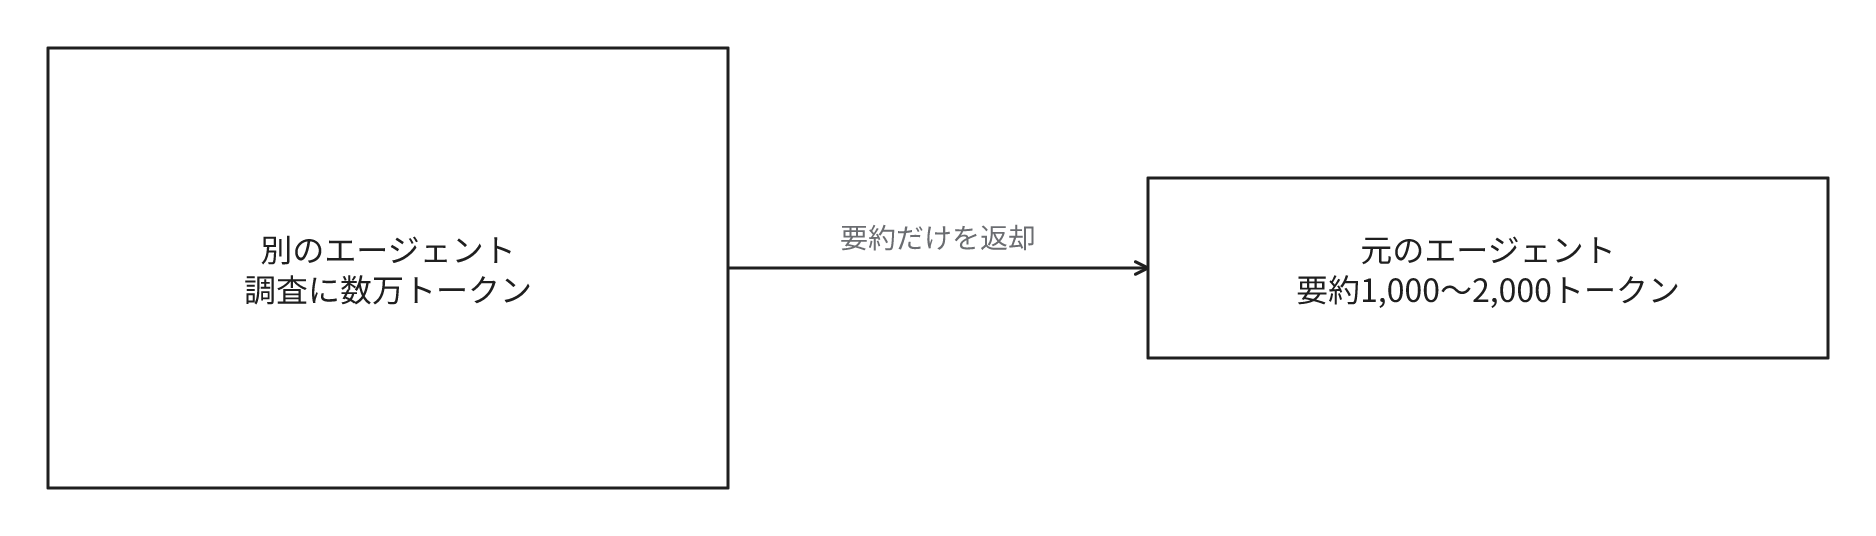
| 作業の分担 | 調査を別のエージェントに委任し、結果の要約だけを受領する | 調査の範囲が広範な作業 |
| ツールの限定 | 業務に必要なツールだけを有効にし、機能の重複したツールを接続しない | ツールを多数接続したエージェント |
手法は併用できます。
Claude Codeは作業ルールのファイルを最初に入力し、他のファイルは検索のツールで必要なときに参照します。
作業の分担では、別のエージェントが数万トークンで調査しても、元のエージェントへの返却は1,000〜2,000トークン程度の要約だけです。
作業の記録と不要になったツールの結果の消去を併用した構成では、Anthropicの社内の評価で検索の作業の成績が基準の構成と比較して39%向上しています。
ツールの結果の消去だけを使用した、100回の手順のWeb検索の評価では、上限への到達で失敗していた作業が完了し、トークンの消費は84%減少しました。
コンテキストエンジニアリングの効果とコスト・リスク
効果
- 同じモデルのまま、回答の正確さと長い作業の完了率を改善できる場合がある
- 不要な情報を入力しないことで、1回あたりの費用と待ち時間を抑制できる
- 外部に送信する社内の情報を、作業に必要な範囲に限定できる
コストとリスク
- 必要な情報の欠落。要約や選択で、後になって重要だと判明する情報を除外することがある。Anthropicは、過度に要約すると、詳細だが重要な情報が欠落すると注意している
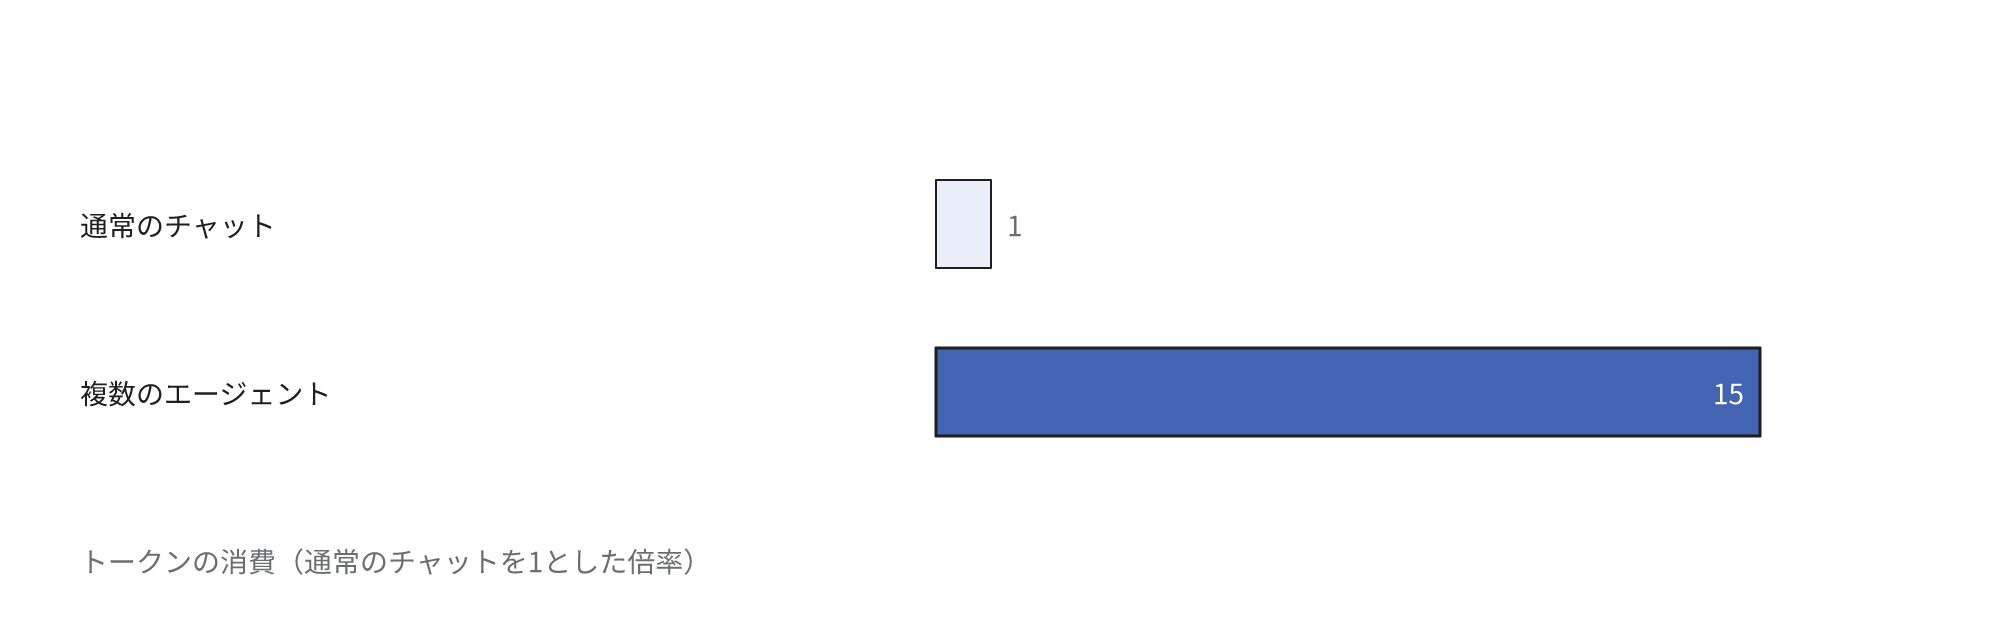
- 作業の分担による費用の増加。元のエージェントの入力は減少しても、全体のトークンは増加する。各エージェントが別々のコンテキストで作業するため、複数のエージェントで分担する仕組みは、Anthropicの集計で通常のチャットの約15倍のトークンを消費した。分担は費用に相当する価値の高い調査に限定する
- 処理の遅さ。必要な時点でツールで情報を取得する方法では、手順ごとにツールの実行と結果の参照が追加されるため、事前に用意した情報を入力する方法より時間がかかる
- プロンプトキャッシュの効果の低下。プロンプトキャッシュは入力の先頭から一致する部分を再利用して割引する仕組みのため、入力の先頭の部分を毎回組み替えると機能しなくなる。固定の指示や資料は先頭に配置する
- 資料の整備。選択の精度は資料の改訂履歴の管理と分類に依存する。旧版の資料が残存していると、選択しても誤答する
- 閲覧権限の反映。検索で資料を選択するときに利用者の閲覧権限を反映しないと、本人が閲覧できない資料の内容が回答に含まれる
- 外部の文章の扱い。Webページやメールなど外部から取得した文章に指示が混入していると、AIがその指示を利用者の指示と区別できずに従い、動作を誘導される場合がある。プロンプトインジェクションと呼ばれる攻撃である
- 評価と保守。資料の選択の条件を変更すると、それまで入力していた必要な資料が除外され、回答の品質が低下することがある。条件の変更とモデルの更新のたびに、同じ実例で再評価する
製品を利用する場合と自社で構築する場合の担当範囲
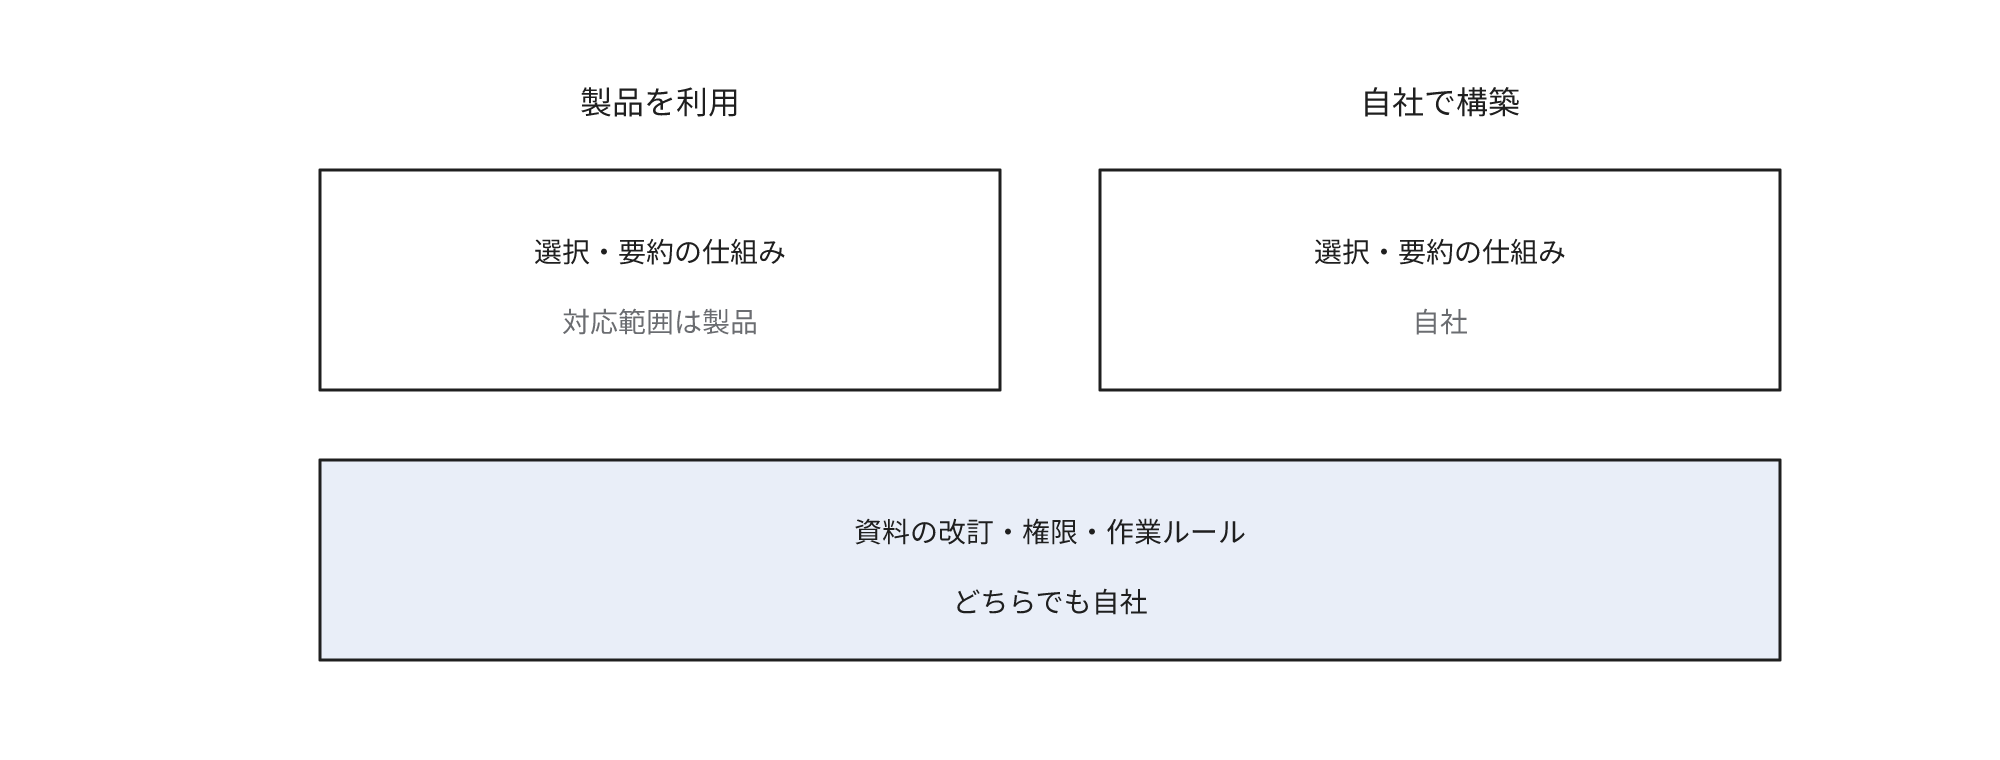
チャットの製品やエージェントの製品を利用する場合、要約、必要な時点での取得、作業の分担といった仕組みは、製品によっては製品の側が実装しています。
利用する組織が担当するのは、入力する資料と指示の整備です。
| 担当 | 製品を利用する場合 | 自社で構築する場合 |
|---|---|---|
| 資料の改訂履歴の管理、旧版の整理、閲覧権限の設定 | 自社 | 自社 |
| 作業ルールの文書、接続するツールの限定 | 自社 | 自社 |
| 資料の選択、要約、作業の記録と分担の仕組み | 製品が対応する範囲は製品 | 自社 |
| 入力の構成と費用の評価 | 製品の設定の範囲で自社 | 自社 |
製品の比較では次の4点を確認します。
- 長い作業の途中で、どの情報を保持し、どの情報を除外するか
- 作業ルールの文書を参照させられるか
- 接続するツールを限定できるか
- 資料の検索に閲覧権限を反映するか
自社でコンテキストを設計する必要があるか
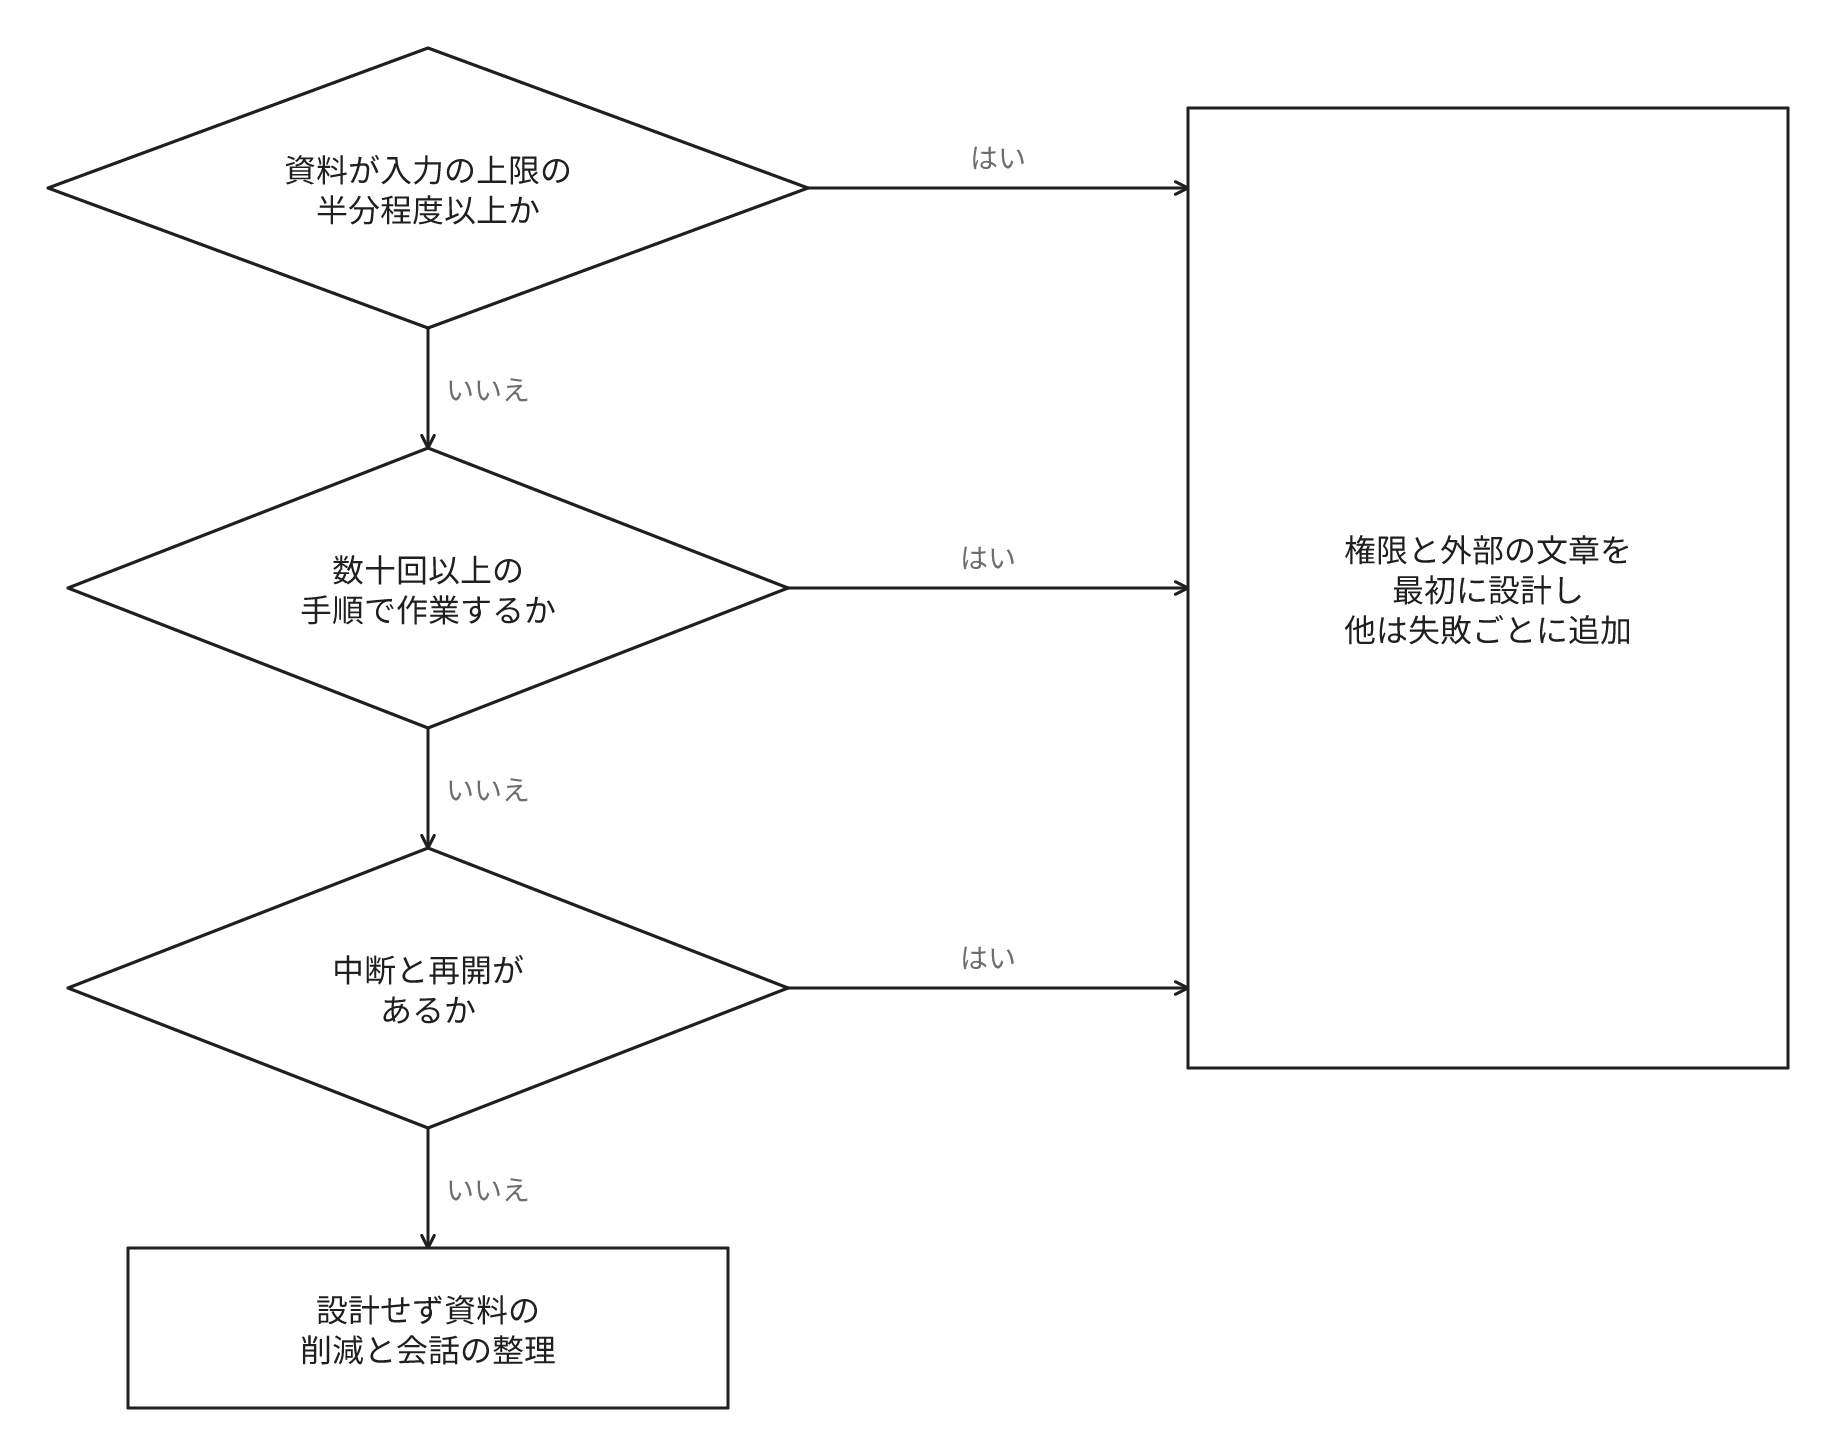
チャットで1回の質問に資料を添付して回答を得る使い方なら、設計は不要です。
資料が長すぎる、会話が長くなって前提が欠落するといった問題が発生したら、資料の削減や、要点を整理した新規の会話の開始で対応できます。
次のどれかに該当する仕組みを業務に導入する場合は、設計が必要です。
- 参照する資料の全体が1回の入力の上限を超える、または上限の半分程度以上を占める
- AIエージェントがツールを使用し、数十以上の手順で作業する
- 1件の作業が長く、途中で中断と再開がある
この場合は最初から多くの手法を導入せず、実例で失敗を観察してから対策を追加します。
ただし閲覧権限の反映と外部の文章の扱いは、漏洩が発生した後の対策では流出した情報を回収できないため、最初から設計に含めます。
誤答の原因が資料の不足なら資料の選択を、途中で条件が欠落するなら作業の記録や要約を追加します。
どの対策も目安として数十件から100件程度の同じ実例で、追加の前後の正答率と1件あたりの費用を比較して効果を判定します。
よくある誤解
関係しそうな資料をすべて入力したほうが正確になる
入力が長くなるほど、必要な情報の抽出の精度は低下し、旧版の規程のような紛らわしい情報による誤答も増加します。
たとえば問合せ対応では、質問に関係する規程の最新版の該当箇所だけを入力します。
プロンプトエンジニアリングとは別の技術である
プロンプトの設計はコンテキストエンジニアリングの一部で、指示文の書き方の工夫は引き続き必要です。
違いは対象の範囲です。
コンテキストエンジニアリングは指示文のほか、資料、履歴、ツールの結果を作業の段階ごとに選択し直します。
製品を利用していれば自社で対応することはない
製品が実装するのは選択や要約の仕組みで、選択の対象になる資料の改訂履歴と閲覧権限、作業ルールの文書は利用する組織が整備します。
旧版の資料が整理されず検索の対象に残存していれば、改訂の新旧を識別して除外する機能がない製品では、旧版の内容による誤答が残存します。
社内の資料を参照するAIや複数の手順で作業するAIエージェントを導入するときは、実例による評価を用意したうえで、モデルの選定と並行して、どの情報をどの時点で入力するかを設計します。
関連用語
プロンプトエンジニアリング
成熟度:
コンテキストウィンドウ
成熟度:
トークン(生成AI)
成熟度:
RAG
成熟度:
AIエージェント
成熟度:
エージェントハーネス
成熟度:
ハーネスエンジニアリング
成熟度:
MCP
成熟度:
大規模言語モデル
成熟度:
LLMの評価(eval)
成熟度:
同じ分野の用語
AI・機械学習の用語をすべて見るお問い合わせ・ご相談
システム開発、データ活用、プロダクトづくりのことならお気軽にご相談ください。要件が固まる前の整理や、お見積もりだけのご依頼も承ります。