
プロンプトエンジニアリングとは
プロンプトエンジニアリングは、プロンプトの内容を設計し、結果を評価しながら改善して、生成AIの出力を期待どおりに安定させる取り組みです。
設計の対象は作業の目的と背景、手順、遵守すべき条件、入力と出力の例、出力の形式です。
モデルそのものを追加で学習させずに、入力の書き方だけで品質を改善する点が特徴です。
たとえば問合せのメールを10種類の区分に分類させる業務では、区分ごとの定義と判定が困難な例、区分ごとの実例、回答は区分名だけを出力するという形式の指定をプロンプトに記述します。
そのうえで過去の問合せを入力し、正確に分類できた割合を確認し、誤分類した種類の問合せに対応して定義や例を修正します。
Anthropicはモデルを職場の慣習に不慣れな有能な新入社員とみなし、文脈を共有していない同僚でも理解できる指示を記述するよう勧めています。
新規に配属された担当者向けの業務の手順書を、担当者の質問に応じて改訂していく作業に相当します。
隣の取り組みとの違いは変更する対象にあります。
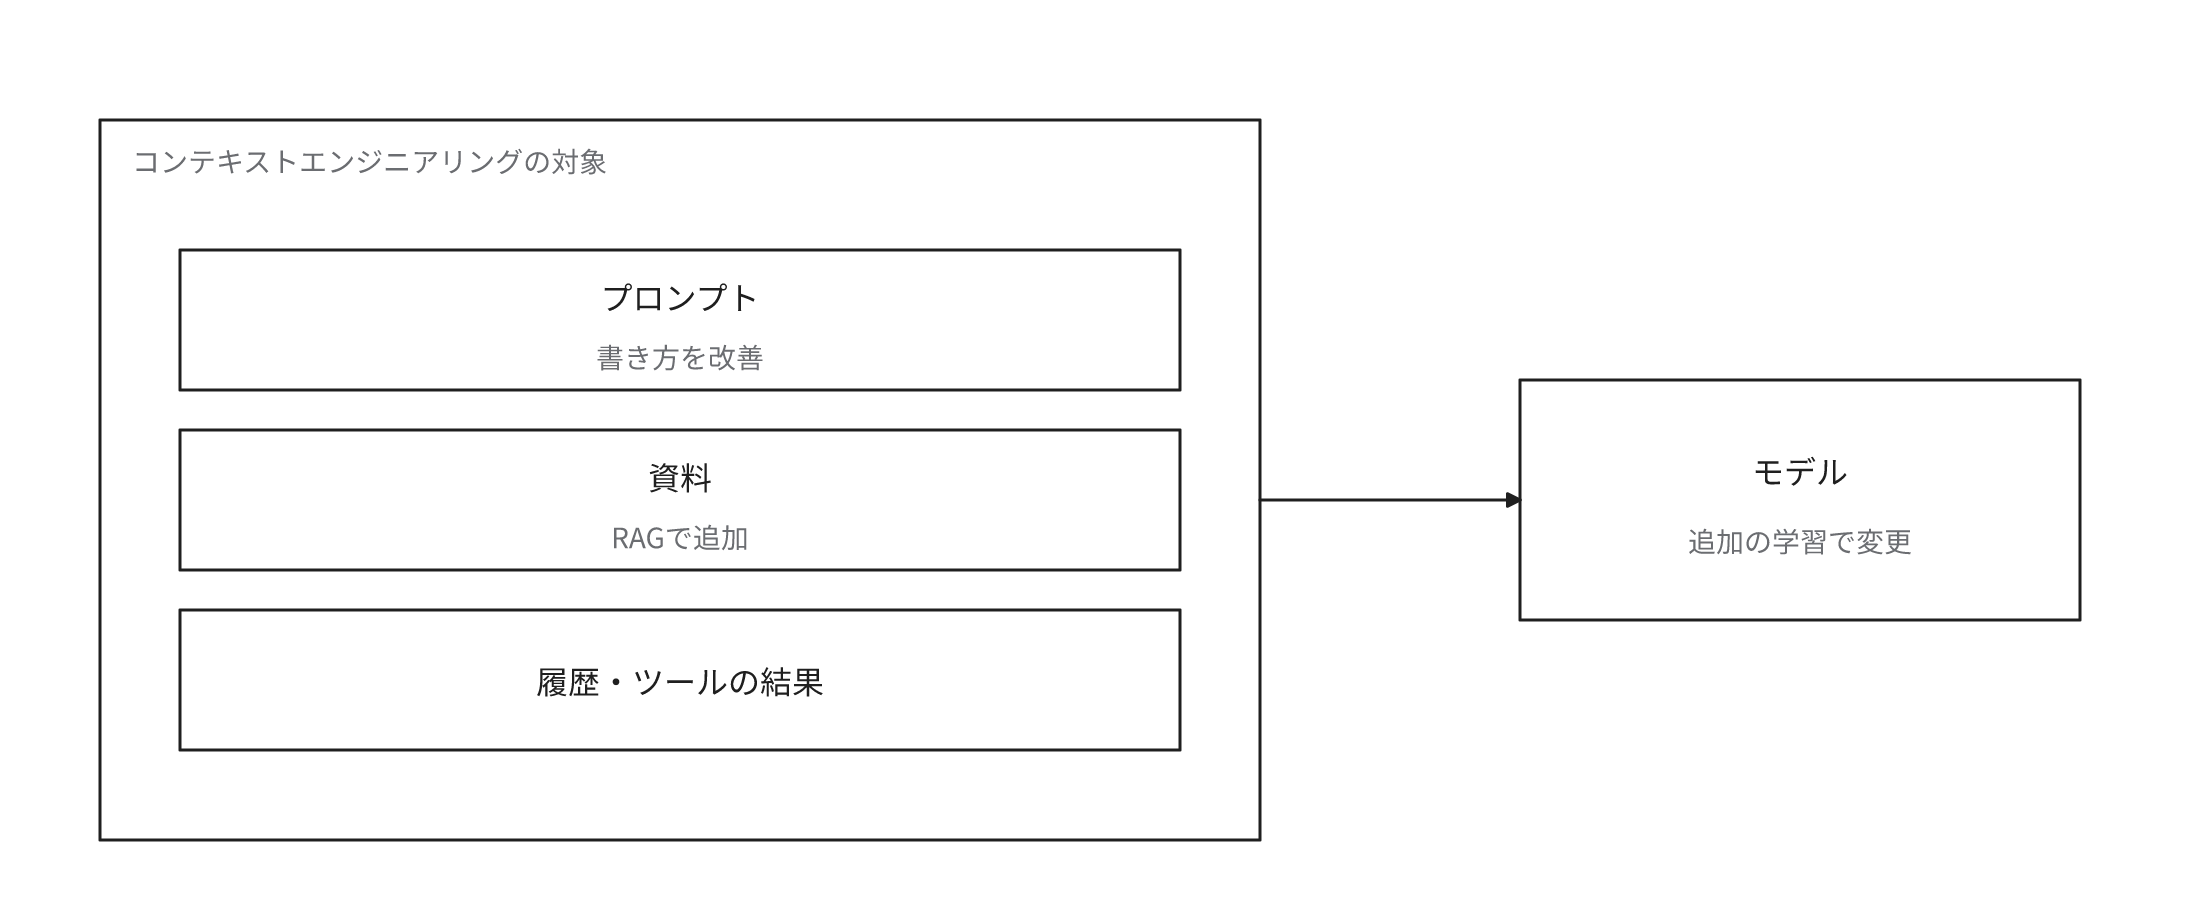
ファインチューニングはモデルの内部を追加の学習で変更し、RAGは質問に関係する社内資料を検索して入力に追加します。
コンテキストエンジニアリングは、プロンプトのほか会話の履歴、ツールの結果、参照する資料まで、モデルに入力する情報の全体を設計の対象にします。
Anthropicはコンテキストエンジニアリングをプロンプトエンジニアリングから発展したものと位置づけています。
同じ依頼でも出力の品質が一定しない問題
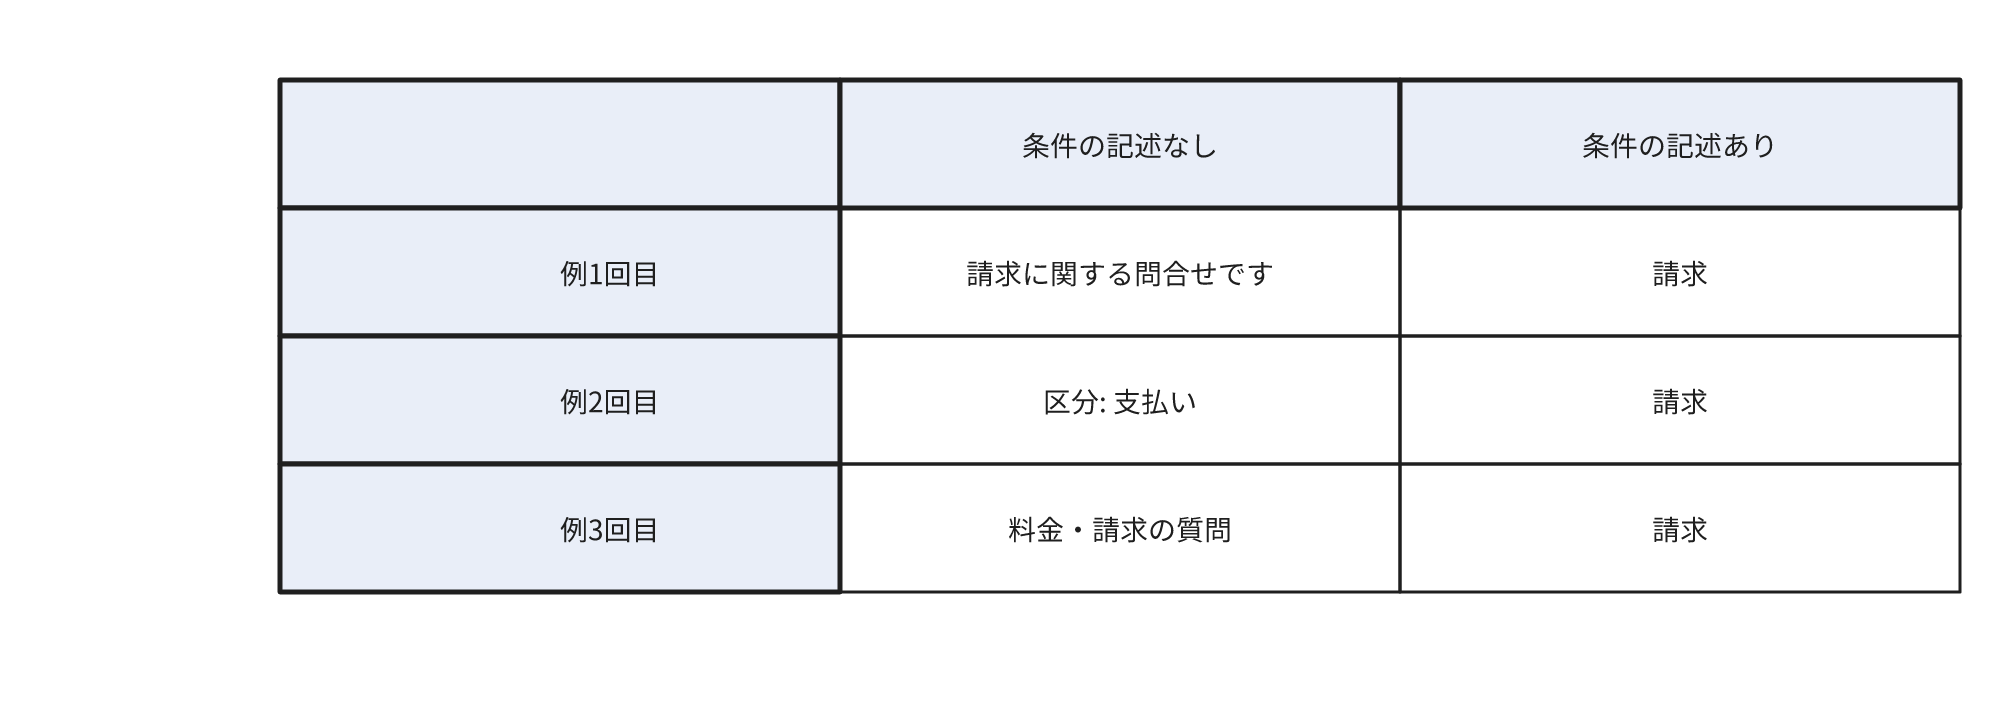
生成AIは指示に記述のない条件を推測で補完することがあります。
「この問合せを分類して」と依頼すると、区分の数や名前、判定が困難な場合の扱い、回答の書式が毎回変わることがあります。
同じ系列のモデルでもバージョンによって結果が変化するうえ、同じプロンプトに同じ入力をしても出力が毎回同じになるとは限りません。
このばらつきは、業務の仕組みに導入した場合に後の処理の誤りや人の確認と修正の手間の原因になります。
チャットで1回だけ質問する利用方法なら、結果を確認して再度質問すれば十分です。
同じ指示を毎日数百件の処理に使用する場合は再度の質問ができないため、どの入力でも同じ基準で出力するよう、条件を事前にプロンプトに記述しておく必要があります。
分類の業務での改善の手順
問合せの分類を例に、改善の進め方を示します。
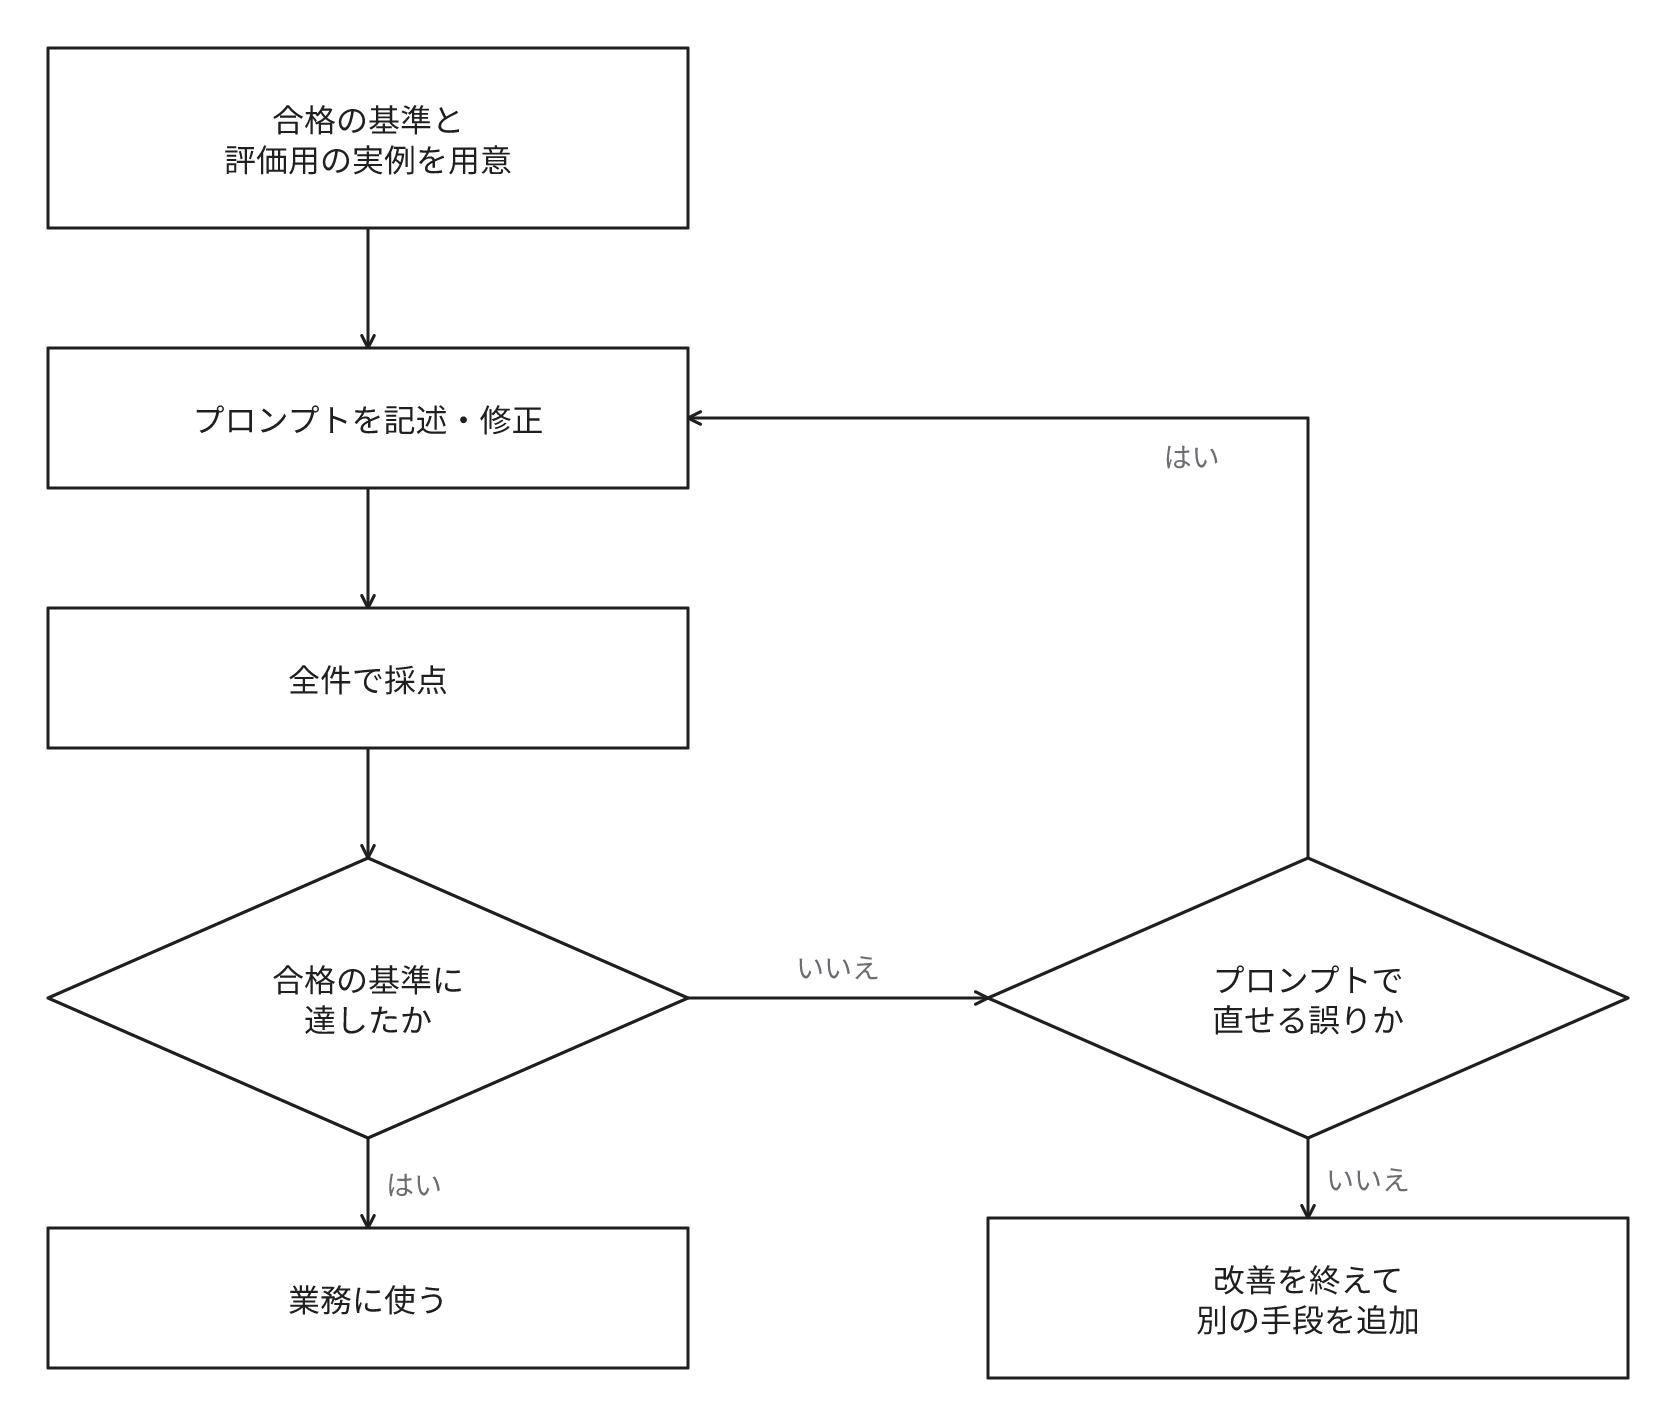
- 合格の基準を決定する。何割を正確に分類できれば業務に利用できるかを、誤分類が後の処理でどの程度の手戻りを生じるかから決定する。たとえば現在の担当者による誤分類の割合を、許容できる誤分類の上限の目安にする
- 評価用の実例を用意する。区分ごとに正答率を確認するため、区分の数が多いほど件数が必要になる。区分ごとに10〜20件あれば区分ごとの正答率の差を確認しやすく、この例の10区分なら全体で100〜200件程度が目安になる。判定が困難な問合せを多めに含める。試作の段階では数十件から開始してよい
- 最初のプロンプトを記述する。作業の目的、区分ごとの定義、出力は区分名だけという形式を記述する。指示、区分の定義、分類する問合せは、見出しや区切りの記号で区分し、指示と資料を混同させない
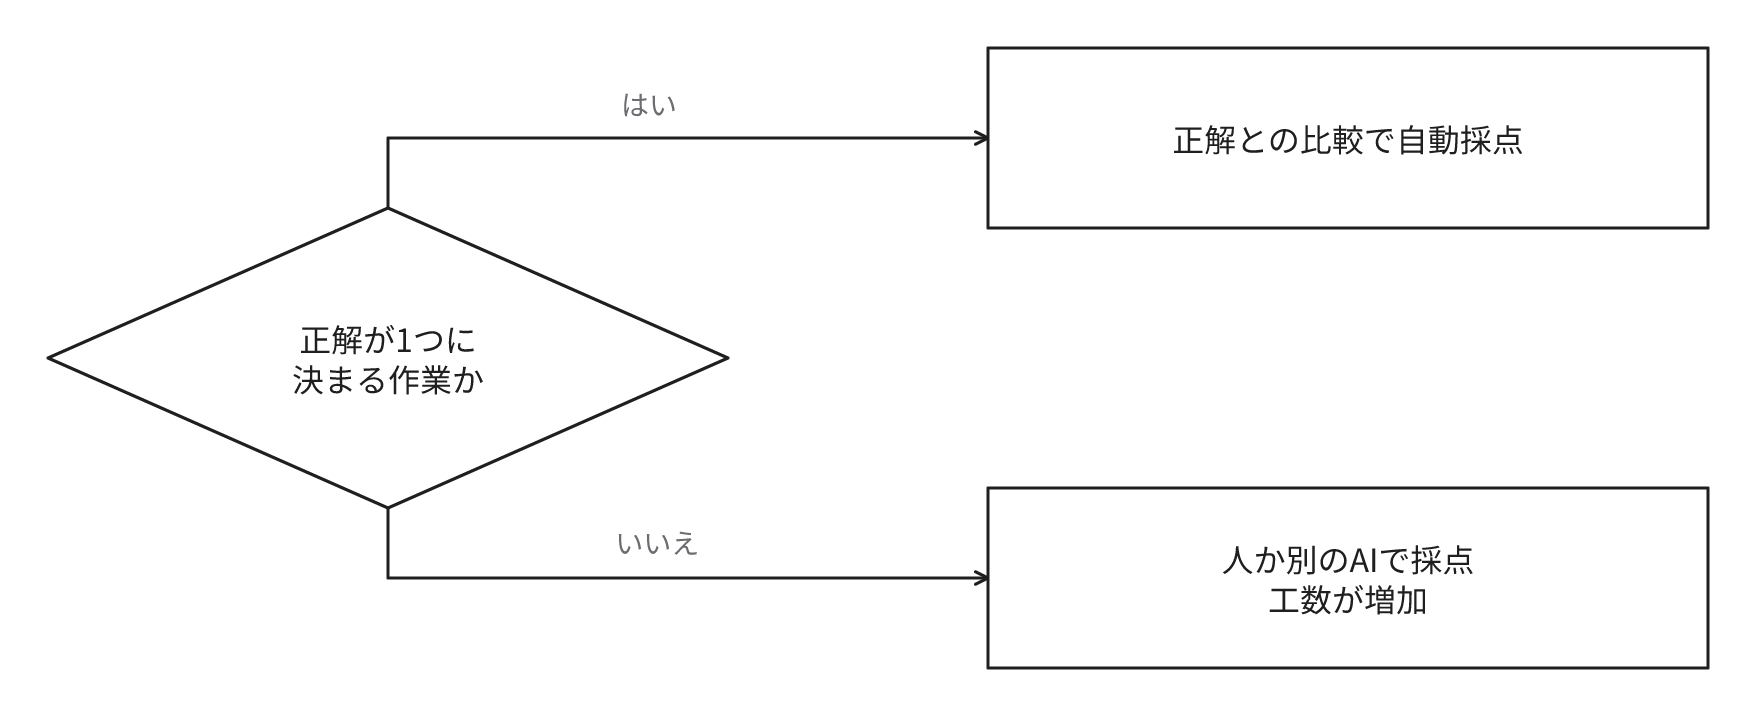
- 実例を入力して採点する。分類のように正解が1つに確定する作業は、正解との比較で自動で採点できる。出力が毎回同じとは限らないため、同じ実例を複数回実行して結果を比較する
- 誤りの種類を確認して修正する。特定の区分どうしで混同していれば、その2つの定義の違いと判定が困難な例を追加する。Anthropicは、形式と口調を統一する手段として3〜5件の例を推奨している
- 修正のたびに全件で再評価する。プロンプトの指示はすべての問合せの判定に適用されるため、1つの区分の改善のために追加した1文が、他の区分の正答率を低下させることがある
手順や条件を詳細に固定しすぎると、規則に該当しない入力で判断ができなくなり、規則を追加するたびにプロンプトの保守も困難になります。
Anthropicは、複雑な規則を書き込みすぎる失敗と、曖昧すぎる指示の失敗の中間を目標にするよう勧めています。
1回の依頼で多くの作業をさせず、抽出、分類、文章の作成のように作業を分割して順に処理させる方法もあります。
プロンプトエンジニアリングの効果とコスト・リスク
効果
- モデルの追加の学習や新規の仕組みの構築なしに、分類の正答率や出力の形式の統一度を改善できる
- 評価用の実例を一度用意すれば、修正から結果の確認までを短時間で反復できる
- 出力の形式を統一することで、後の処理を自動化しやすくなる
コストとリスク
- 評価の準備。改善したかどうかは、実例を入力して結果を採点しなければ判定できない。Anthropicのガイドは、合格の基準と、それを試験する方法があることを前提にしている。正解が1つに確定しない文章の作成では、人か別のAIによる採点が必要になり、工数が増加する
- モデルの変更による再調整。OpenAIは、同じ系列のモデルでもバージョンによって結果が変化しうるとして、本番のアプリケーションを特定のバージョンのモデルに固定し、プロンプトの挙動を測定する評価を用意するよう勧めている
- 費用と待ち時間。例や条件を追加するほどプロンプトが長くなり、毎回の入力のトークンが増加し、応答までの時間と、従量課金のAPIでは費用が増加する
- プロンプトの流出。プロンプトの内容を表示するよう利用者が依頼すると、AIがその依頼に従って内容を出力することがある。OWASPは認証情報などの機密情報をシステムプロンプトに含めないよう求めている
- 限界。指示の書き方の調整では、モデルが保有しない社内の知識や最新の情報は補完できない
- 管理の手間。業務に使用するプロンプトは、変更の履歴、変更の理由、評価の結果を記録し、担当者の交代時に引き継ぎができるようにする。記録がないと、後任者が変更の意図を確認できず、過去に悪化を確認した修正を再度適用することがある
プロンプトの改善を終了して別の手段を追加する条件
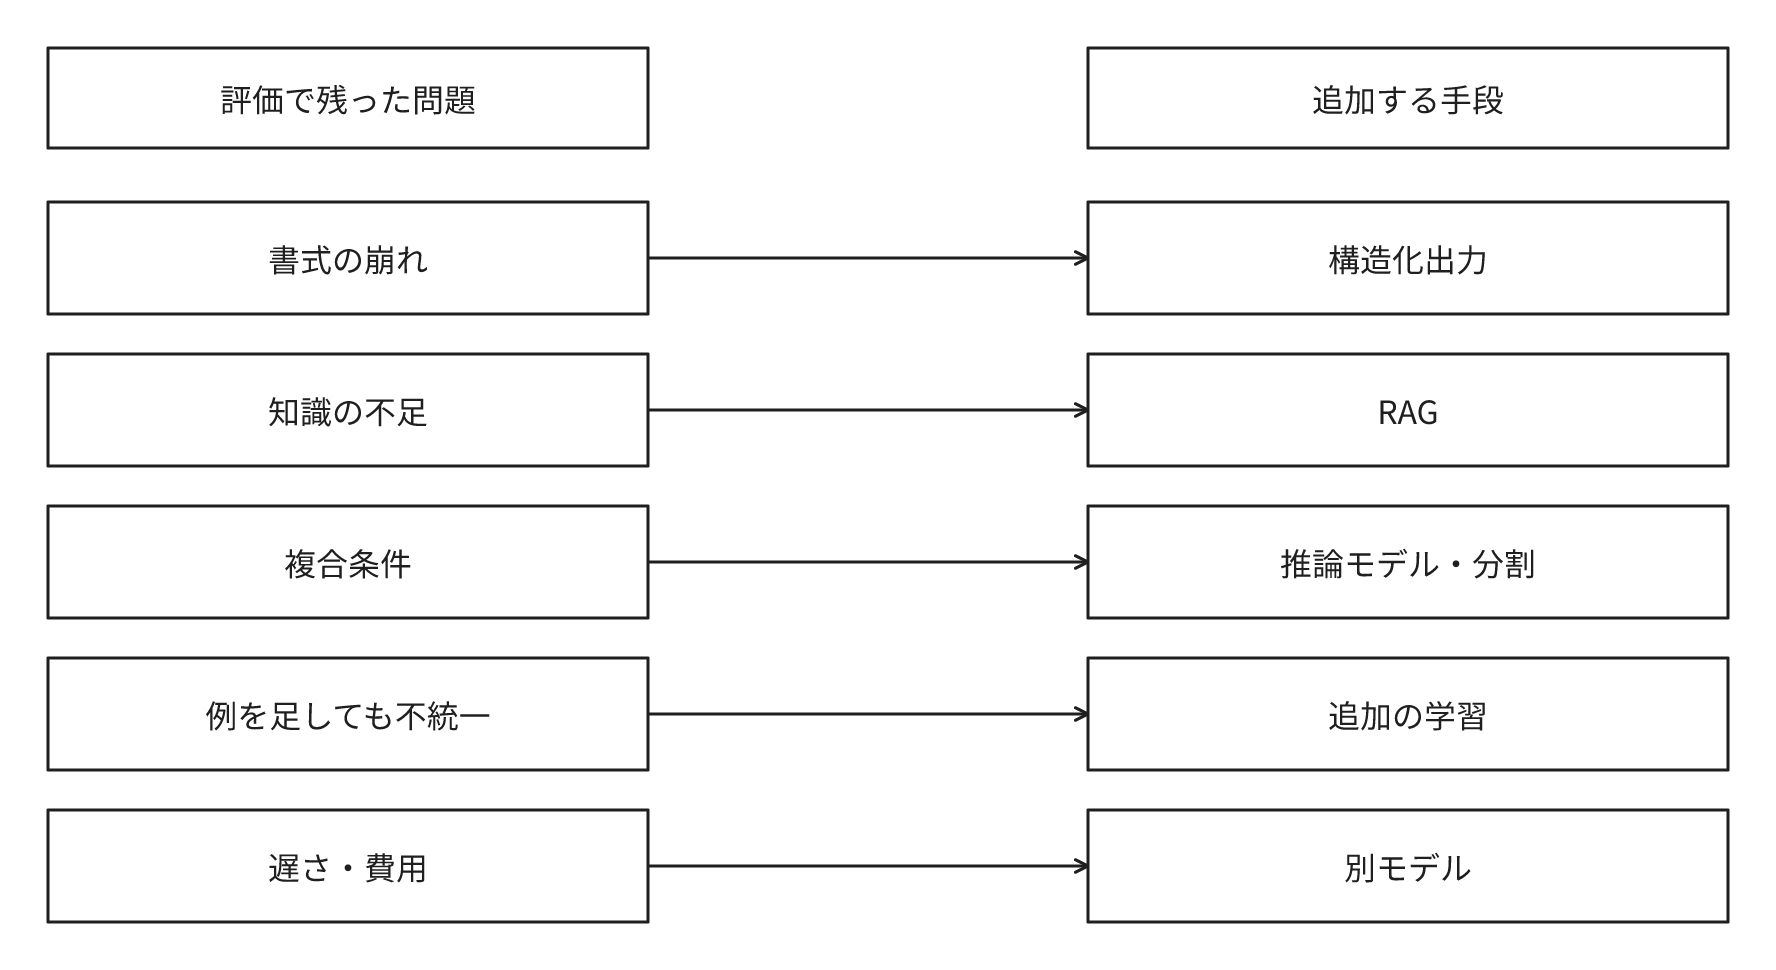
修正を反復しても合格の基準に達しない場合や、誤りの原因がプロンプトの書き方以外にある場合は、評価で残存した問題の種類に応じて別の手段を追加します。
| 評価で残存した問題 | 追加する手段 |
|---|---|
| 書式の崩れや項目の欠落が継続する | 構造化出力など、出力の形式をシステムの側で強制する機能 |
| 社内の規程や最新の情報の欠如で誤答する | RAGなどで、関係する資料を入力に追加する |
| 複数の条件を同時に考慮する判断で誤答する | 推論モデル、または作業の分割 |
| 区分の判定や口調が、例を追加しても統一されない | ファインチューニング |
| 処理が遅い、費用が高い | 同じ評価で小規模なモデルや別のモデルを比較する |
評価で判明した問題のすべてがプロンプトで改善できるわけではなく、待ち時間の短縮や費用の削減はモデルの変更で実現しやすい場合があります。
組織として投資する範囲
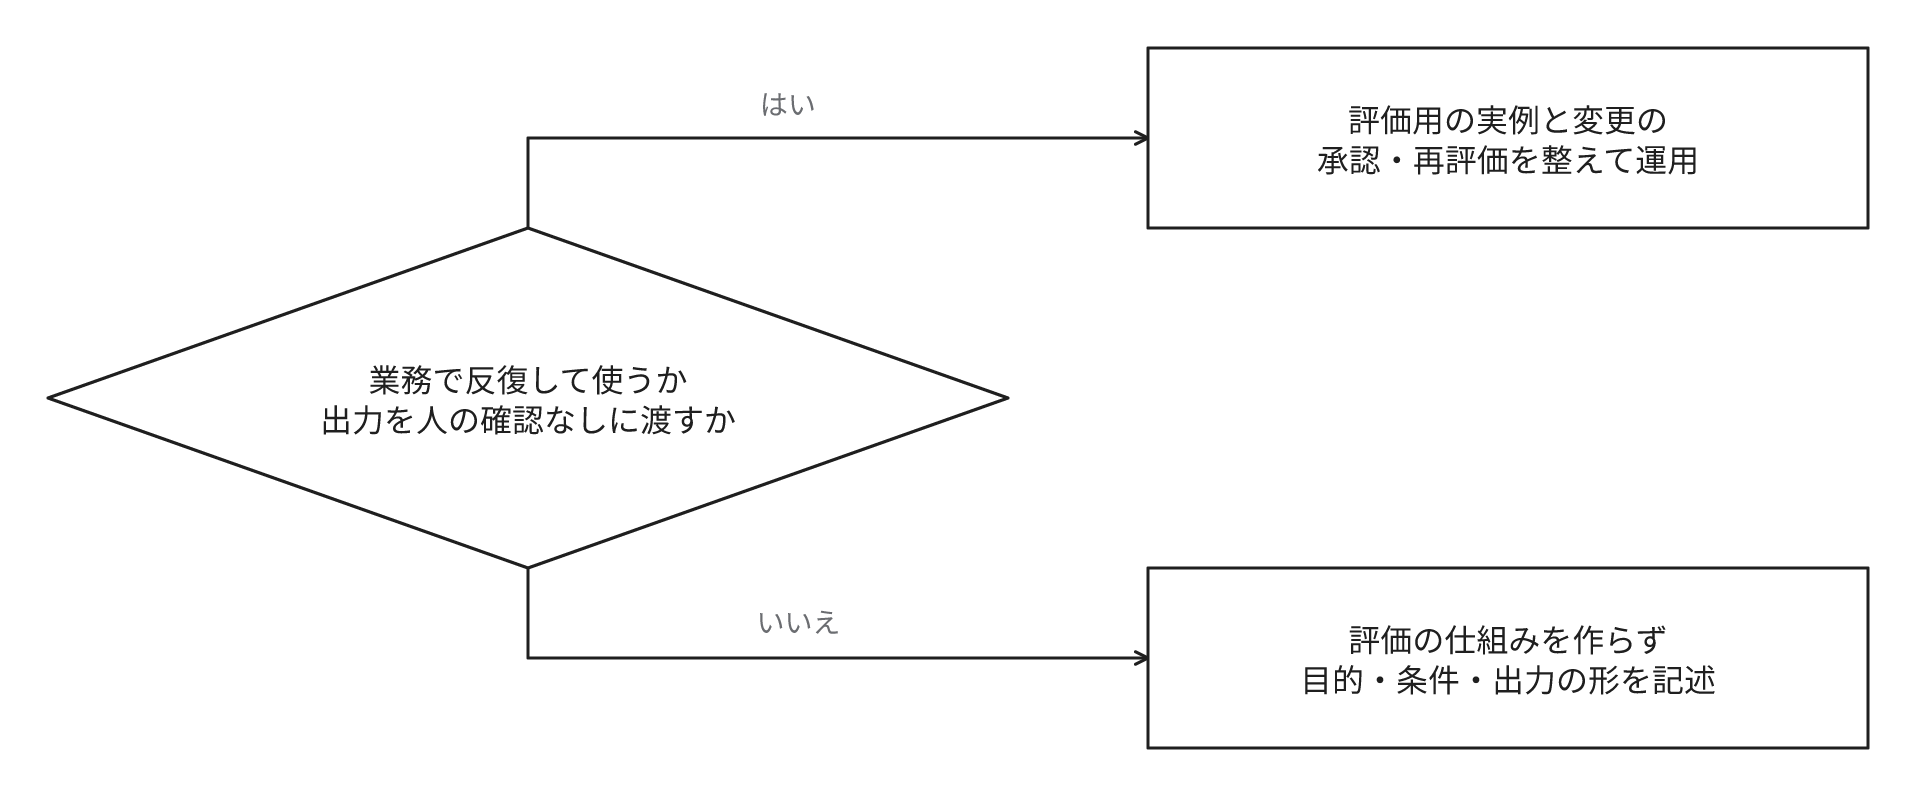
チャットでの日常の質問や1回限りの資料の作成では、評価の仕組みまで用意する必要はありません。
目的、条件、出力の形を記述し、結果を確認して追加で指示すれば十分です。
社員向けの研修やテンプレート集を用意する場合も、この3点を記述する習慣の定着を目的にすれば十分で、定型の言い回しの収集に時間をかける必要はありません。
投資すべきなのは同じプロンプトを業務の仕組みで反復して使用する場合と、出力を人の確認なしに後の処理で使用する場合です。
この場合は評価用の実例を先に用意し、プロンプトを仕様の一部として、誰が変更を承認し、変更のたびに同じ実例で再評価するかを決定してから運用します。
よくある誤解
定型の書き方や言い回しの使用で出力が改善する
効果のある書き方はモデルや作業の内容によって異なります。
Anthropicは特定のモデルで確認された手法を別のモデルに適用する前に、自社の評価で確認し直すよう注記しています。
定型の書き方を探索するより、自社の実例で結果を比較するほうが、自社の業務に適合する書き方を選択できます。
モデルの性能が向上すればプロンプトエンジニアリングは不要になる
性能が向上しても、自社の業務の条件、区分の定義、出力の形式をモデルが正確に推測できるとは限らないため、プロンプトに記述する必要があります。
性能の向上で減少するのは言い回しの細かな工夫の必要性で、何を記述するかを決定する作業は引き続き必要と予想されます。
メールやWebページに混入した指示への追従はプロンプトで防止できる
追従しないようプロンプトで指示すると影響を軽減できることはありますが、プロンプトインジェクションを確実に防止する方法は確立していません。
AIが実行できる操作と閲覧できるデータを、システムの側で限定する対策と併用します。
業務の仕組みで使用するプロンプトの改善は、合格の基準と評価用の実例の用意から開始します。実例があれば、プロンプトやモデルの変更の良否を、印象ではなく同じ実例の採点の結果で比較できます。
関連用語
大規模言語モデル
成熟度:
生成AI
成熟度:
コンテキストエンジニアリング
成熟度:
コンテキストウィンドウ
成熟度:
ファインチューニング
成熟度:
RAG
成熟度:
LLMの評価(eval)
成熟度:
ハルシネーション
成熟度:
プロンプトインジェクション
成熟度:
ハーネスエンジニアリング
成熟度:
推論モデル
成熟度:
同じ分野の用語
AI・機械学習の用語をすべて見るお問い合わせ・ご相談
システム開発、データ活用、プロダクトづくりのことならお気軽にご相談ください。要件が固まる前の整理や、お見積もりだけのご依頼も承ります。