
セマンティックレイヤーとは
セマンティックレイヤーは売上や解約率といった指標の計算方法と、月別・地域別といった集計の切り口の意味を1か所で定義する層です。複数の利用先がその定義を共通して参照します。元データとBI(Business Intelligence)ツールやAIエージェントなどの利用側との間に、返品の扱いや集計日の基準といった業務上の計算規則を共通に配置する技法です。例えば、売上高に返品を含めるか、注文日と出荷日のどちらで集計するかを定義に記述しておくと、営業部のBIツールも経理部の表計算も同じ定義で集計できます。部署ごとのレシピ帳を廃止し、共通のレシピ集を用意するようなものです。
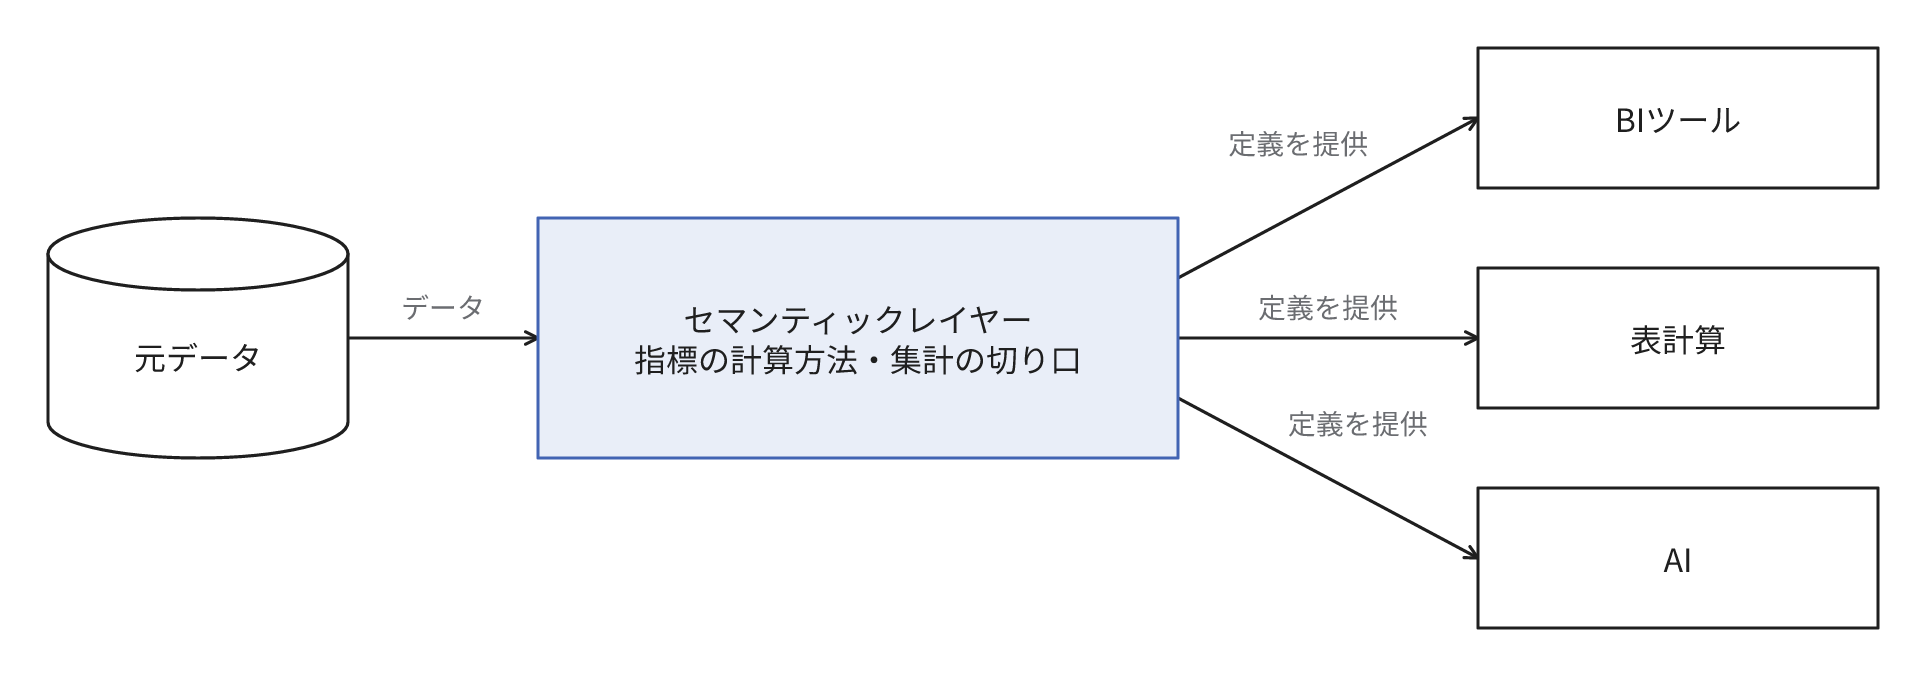
BIツールは集計結果を画面に表示し、データウェアハウスは元データを蓄積します。これに対し、セマンティックレイヤーの役割は定義の管理です。dbt Semantic LayerやLookerは、利用先の要求に応じて、データベースへの問い合わせ文であるSQLを定義から生成します。複数のレポートが共通利用するデータ項目と計算方法をBIツール内で管理する共有モデルも、この層の実装の1つです。
数字が一致しない原因の1つは集計式の分散
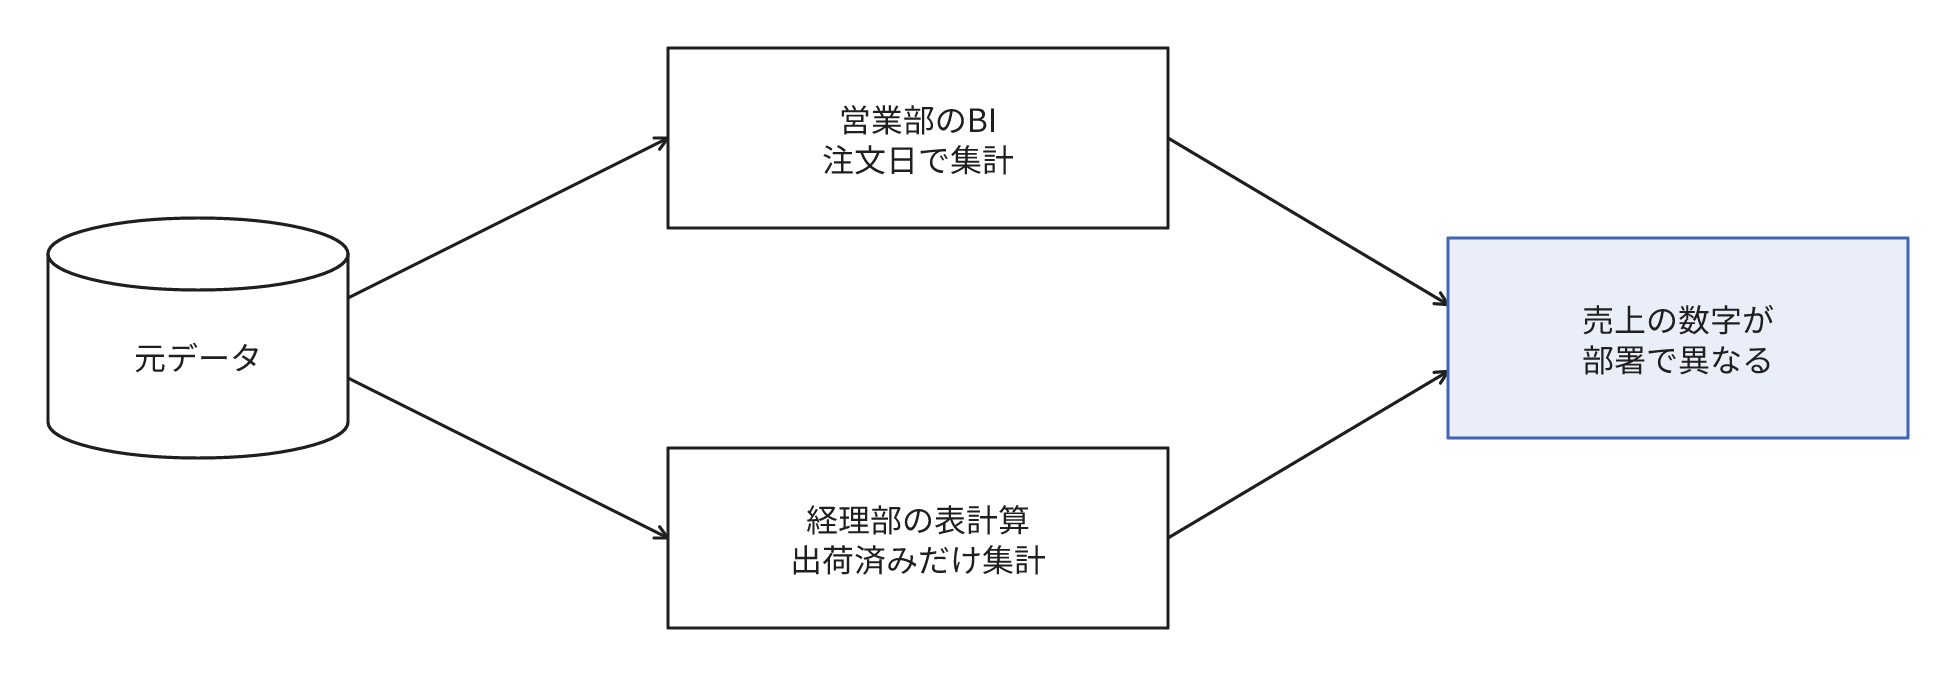
元データが正確でも、同名の指標を別の式で計算していれば、数字は部署ごとに異なります。例えば、営業部は注文日で集計し、経理部は出荷済みの分だけを集計し、返品の扱いも画面ごとに異なる状態です。業務ロジックがダッシュボードや下流アプリに分散すると、定義が無自覚のうちに乖離していきます。利用先にAIが追加されたことも注目の理由です。大規模言語モデルで文章を単純にSQLへ変換すると、売上計上のような業務規則がテーブルの構造の外にある場合は特に、不正確な結果になりやすいとされています。
近年はSnowflakeのsemantic viewやDatabricksのmetric viewのように、データ基盤の製品への内蔵例が増加しています。
独立した層の追加が必要になる条件
独立した層を追加する目安
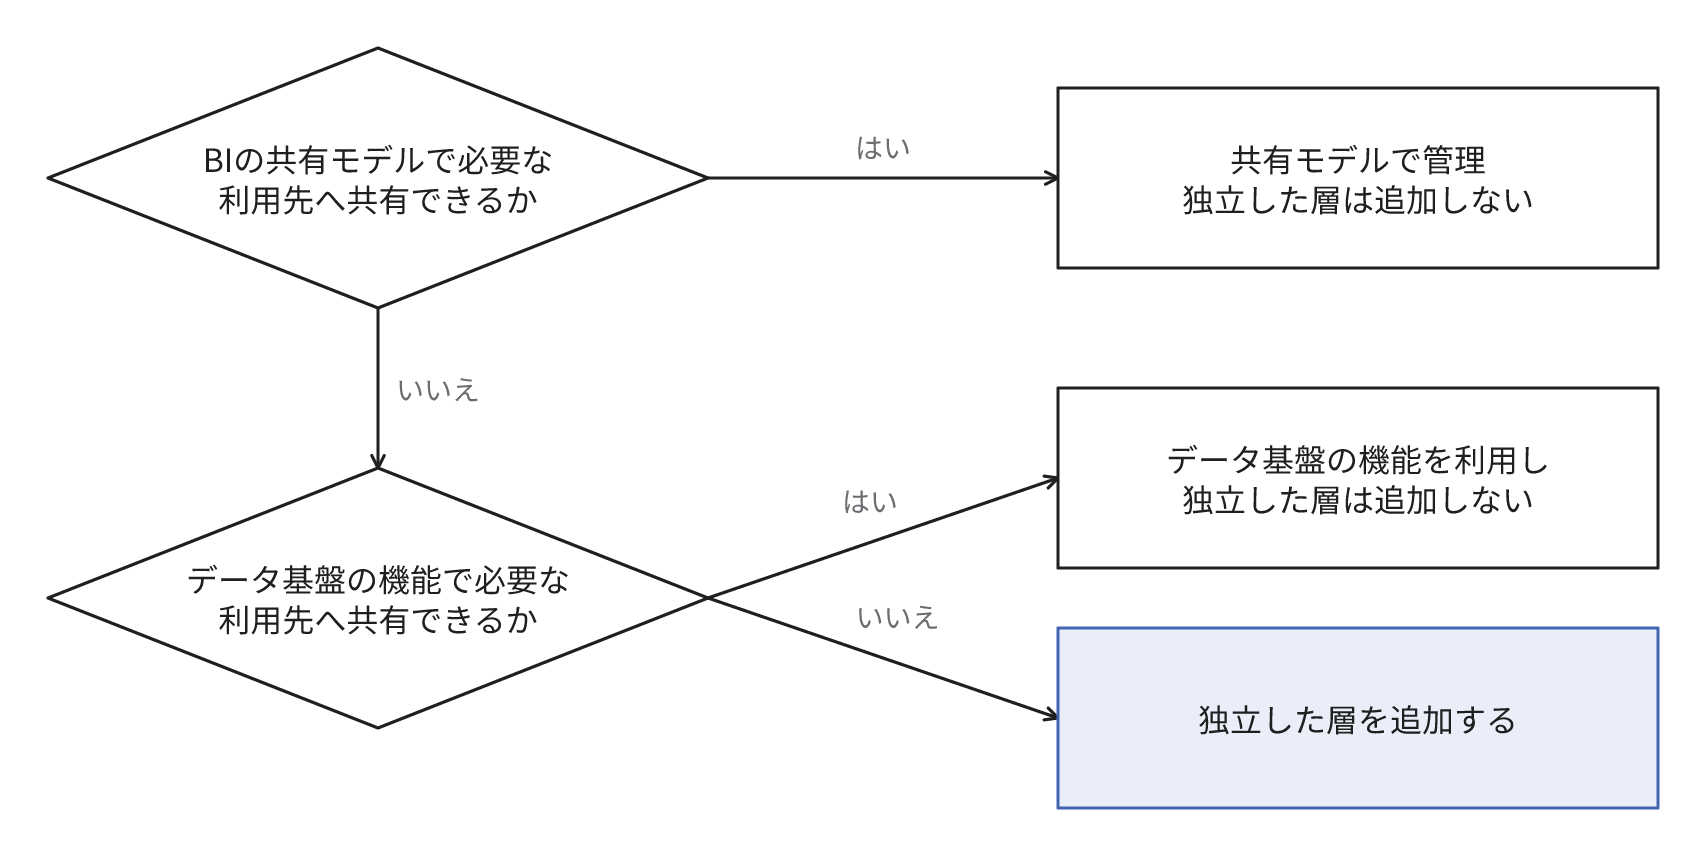
利用先が1つのBIツールだけで、その共有モデルで定義を管理できている場合、独立したセマンティックレイヤーを追加する必要性は高くありません。この場合は指標名・計算式・責任者を記述した定義書を共有モデルと並行して保守すれば十分です。複数のBIツールで同じ定義が必要になり、重複実装や数字の一致確認が継続する場合は、独立した層の追加を検討します。
判断の指標は重複実装の数、修正と一致確認にかかる時間、誤集計の影響度です。これらの作業は指標・部署・利用先の増加に伴って増加しやすいため、次のうち2つ以上に該当する場合は追加を検討します。経験に基づく目安で、業界の基準ではありません。
- 共通で管理したい指標が10個以上
- その指標を利用する部署が3つ以上
- 共有モデルから参照できない取り出し先が1つ以上
- 集計式を自分で記述する人が5人以上
指標が少なくても、経営会議や外部報告に利用する指標は定義を厳密に管理します。導入の効果が限定的になりやすいのは、次の場合です。
- 不一致の原因が元データの欠損や重複
- 部署間で売上などの意味に合意できていない
- 定義の保守担当を配置できない
セマンティックレイヤーは確定した定義を各利用先に提供するだけで、妥当な定義の選定はしません。先に業務側で意味を決定します。目的が異なれば受注額と会計上の売上高のように複数の定義が並存するため、名称・用途・計算条件を区別して管理します。統一の対象は目的と条件が同じなのに式が異なる指標に限ります。
定義の置き場所の選択
置き場所は次の条件で選択します。
- 今のBIの共有モデルから、必要な利用先へ定義を共有できるか。他のBIツールから参照できる製品の例はLooker
- 共有できない利用先で式の重複管理が発生するか。その場合の複数ツールに共通する独立した層の例はdbt Semantic LayerやCube
- データ基盤が内蔵する機能で十分か
共通仕様のOpen Semantic Interchangeは、現在Apache Ossieとして開発中です。直接読める製品は限られ、多くは変換ツールを経由します。特定の製品の書式だけで定義を管理する場合は、置き場所の移行費用を想定します。
セマンティックレイヤーの導入後の運用コスト
主なコストは元データの項目や関係を業務上の指標に対応させるデータモデリングへの先行投資です。広範囲への展開では旧来のレポートの並行稼働で不一致が再発する場合があるため、1つの領域からの開始が推奨されています。最初は例えば5指標前後の1領域に限定します。
運用で発生する作業
- 定義の保守: 指標の追加、条件の変更、元テーブルの変更への追従。工数は変更頻度、データ源、検証と承認の範囲で変動するため、最初の領域で記録して展開後を試算する
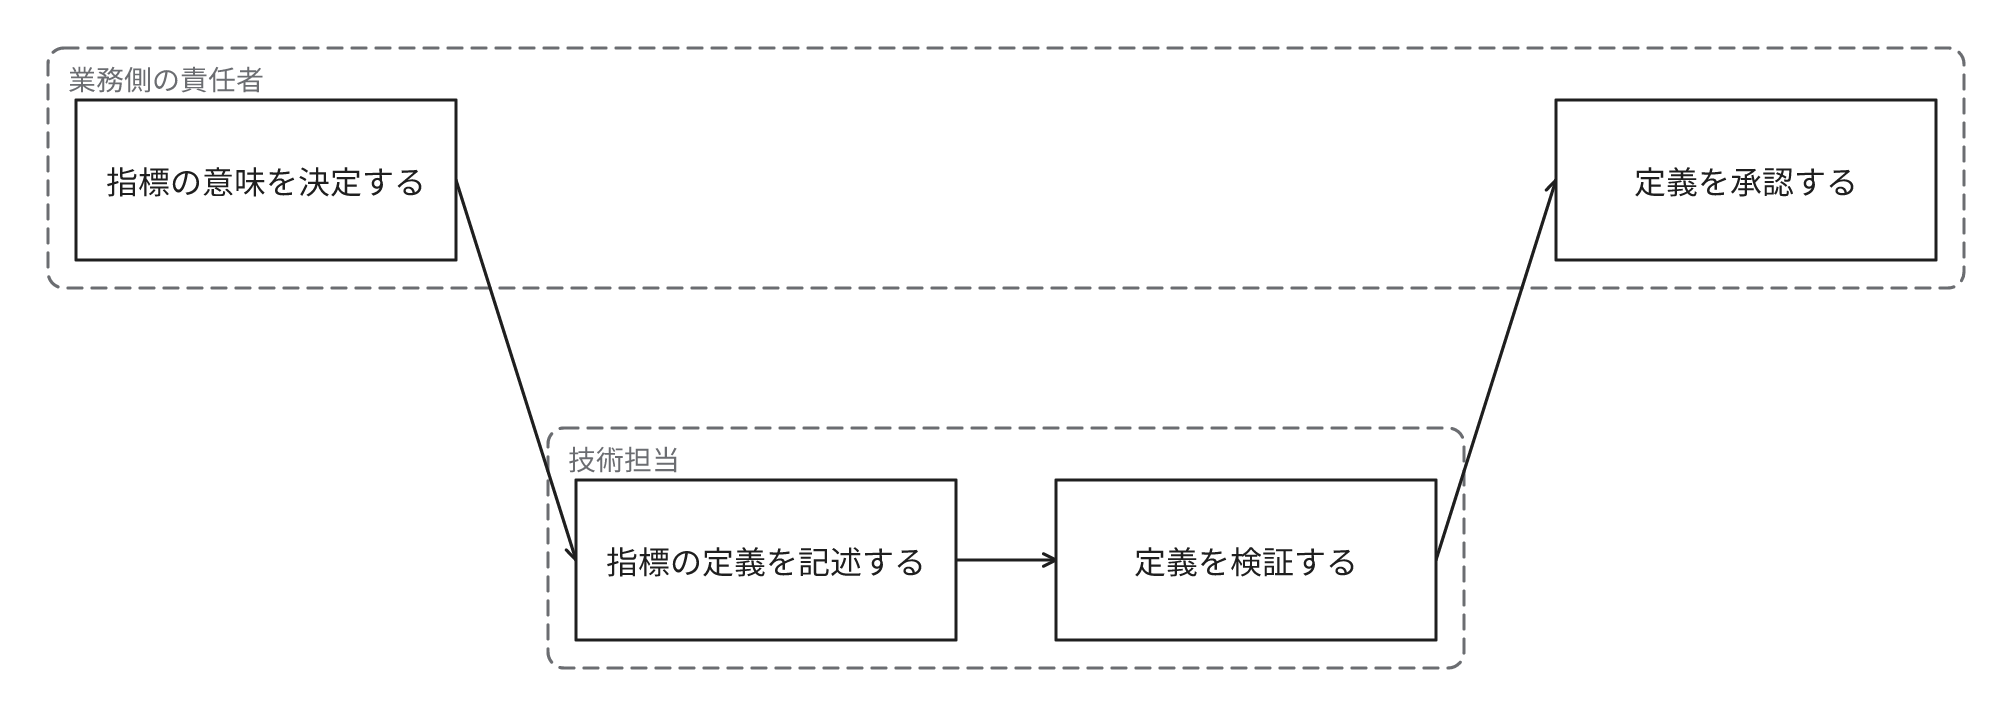
- 担当の分担: 定義を記述して検証する技術担当と、意味を決定して承認する業務側の責任者を、指標ごとに指定する
- 閲覧権限: 共通化するのは定義で、閲覧範囲は別に設定する。dbtではデータ基盤へ接続するための認証情報が閲覧範囲を決定するため、BIやAIからの接続でも制限が維持されるか確認する
- 計算費用と接続保守: 問い合わせはデータ基盤の計算費用になる。dbtにはEnterprise/Enterprise+向けのキャッシュ機能があり、対応する実行環境などの条件がある
- 障害時の対応: 共通部分が停止すると複数の利用先に影響するため、監視と復旧の担当を指定する
- 変更管理: dbtでは本番へ反映した定義が、それを利用する問い合わせに適用される。画面や表計算への反映時期は各ツールの更新設定で異なる
定義の変更で過去の月次資料と数字が一致しなくなる場合は、変更管理の担当が変更前に影響する画面と資料を一覧化し、変更日と理由を記録し、新旧の数字を併記します。Lookerは定義ファイルの変更履歴を、バージョン管理ソフトウェアのGitで記録し、本番に影響しない開発モードで検証してから反映します。dbtの検証機能は定義が参照する列やテーブルの実在を確認し、元テーブルの変更による不具合の早期発見に使用できます。
dbtでは外部BI向けサービスと、共通定義に基づく指標の問い合わせ用APIがStarter以上のプランで提供されるため、機能の選定時にプランを確認します。SQLを生成するMetricFlow単体では利用できません。
よくある誤解
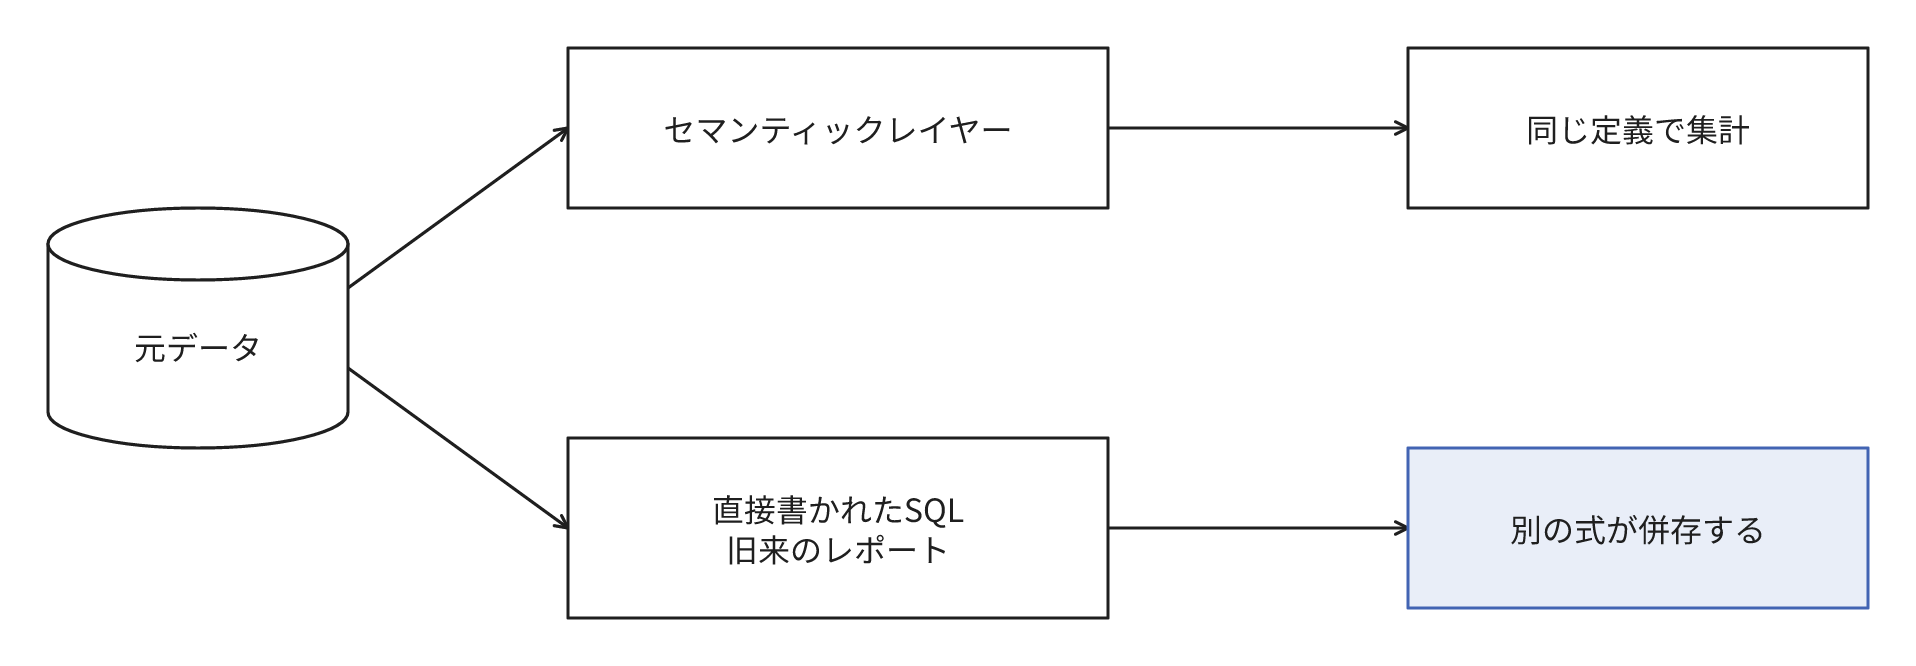
導入しただけで数字が一致する、という誤解があります。セマンティックレイヤーを経由した集計ではずれを軽減できますが、対象期間、条件、更新時点、閲覧権限のいずれかが相違すると、数字は異なる場合があります。直接記述されたSQLや旧来のレポートが存在すると、別の式も併存します。対象の指標を1つ選択し、既存の計算箇所を一覧化して共通定義の参照へ移行し、新旧の差を同条件で確認します。参照できない利用先があれば、置き場所を再検討します。
データウェアハウスやBIツールの代わりになる、という誤解もあります。Snowflakeではsemantic viewが保存するのはデータそのものではなく定義なので、データを蓄積する場所と画面に表示するツールは別に必要です。
お問合せ
事業の課題や技術的な悩みなどどんなことでもお聞かせください