
AIオブザーバビリティとは
AIオブザーバビリティはAIシステムの動作と出力の品質を記録から把握し、問題の原因を調査できるようにする取り組みです[1]。システムの内部の状態を把握するオブザーバビリティを、使用量や回答の品質、モデルの性能の変化といったAIに固有の記録まで拡張したものです[1:1]。生成AIを利用するシステムでは、回答と検索・生成などの処理を対応させて記録し、品質・費用・失敗の理由を調査します[2]。
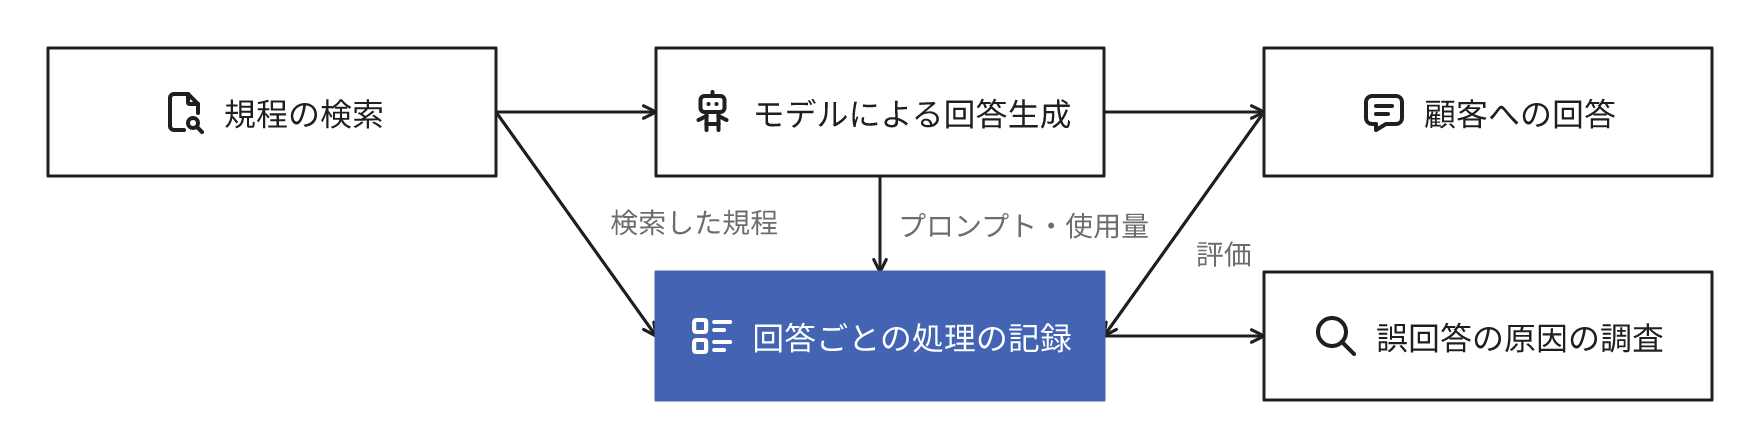
例えば顧客の返品条件に回答するAIでは、回答ごとに検索した規程、モデルに回答方法を指定したプロンプト、回答までの時間や使用量を一括で確認できます。誤回答の報告から処理の記録を確認し、旧規程を検索したのか、取得した規程をモデルが誤解したのかを調査します。
稼働やエラーに限らず、回答内容や途中の処理も観測の対象です。本番の回答にも業務の基準による評価を適用し、処理が正常に終了しても業務に利用できない回答を検出します[3]。
既存の監視に何を追加すべきか
稼働やエラーの監視に、回答ごとの品質評価と使用量、検索やツールの実行結果の記録を追加します。
例えば旧規程の返品条件を案内する回答は、正常に生成されても業務上は失敗です。回答だけの記録では検索対象とモデルの解釈のどちらに問題があるかを調査する材料が不足します。RAG(Retrieval-Augmented Generation)では検索結果まで、AIエージェントではツールの実行結果まで処理を追跡します[2:1]。
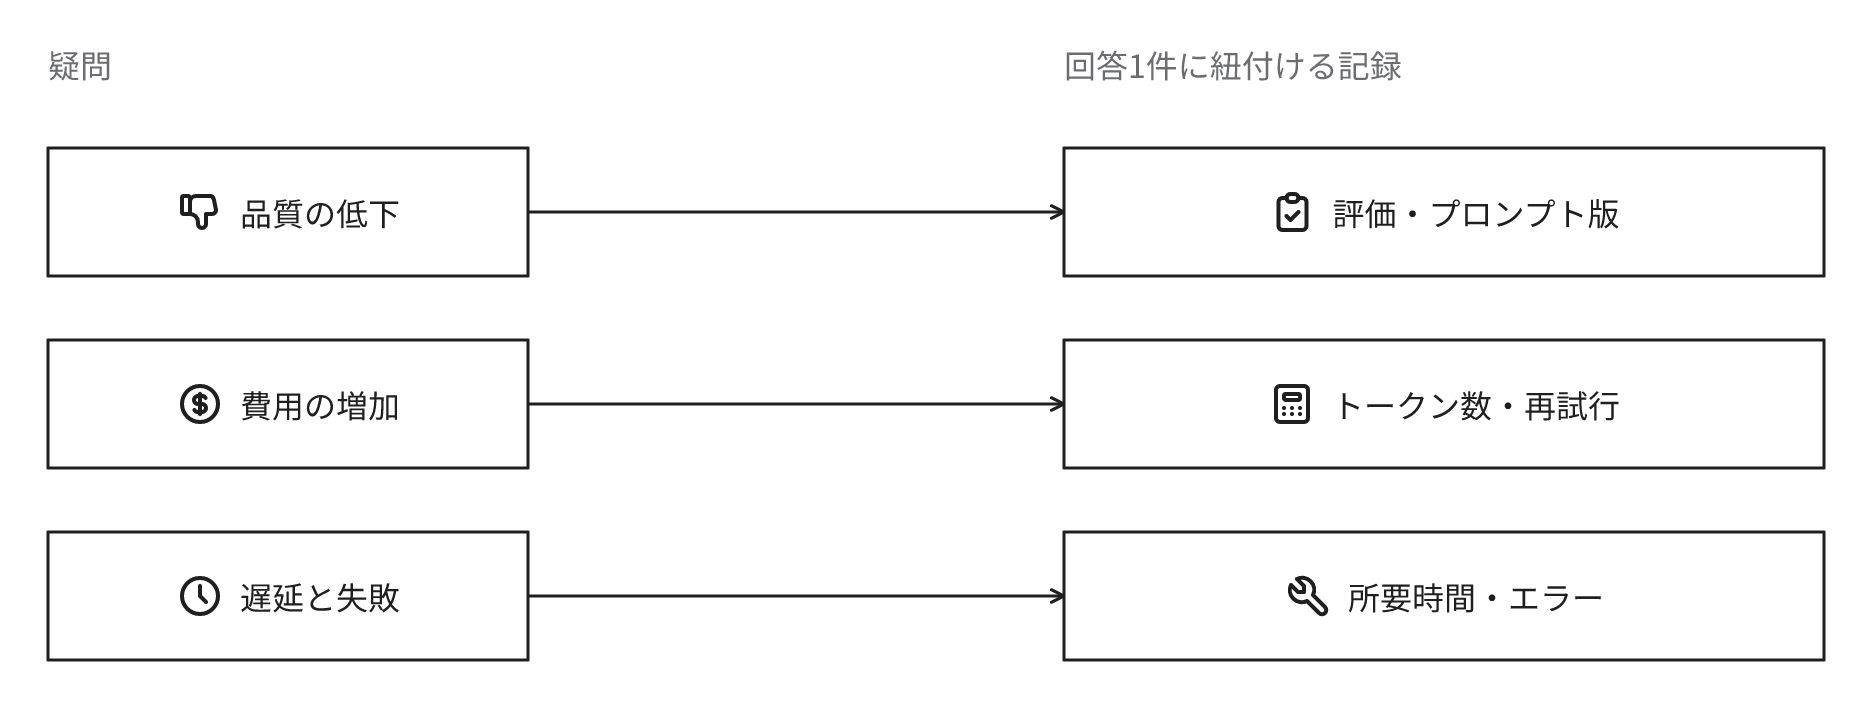
| 確認したいこと | 回答単位で管理する記録 | 判断への利用 |
|---|---|---|
| 回答の品質が低下した理由 | 回答の評価、モデル名、プロンプトや参照規程の版、検索結果 | 品質を低下させた変更や処理の調査 |
| 回答あたりの費用が増加した理由 | 入出力のトークン数、モデルの利用回数、再試行 | 費用が増加した処理の特定 |
| 回答が遅延・失敗した箇所 | 処理ごとの所要時間、エラー、ツールの実行結果 | 検索・生成・外部処理のどこを改善するかの判断 |
モデル名やトークン数などを共通の項目で記録する規約として、OpenTelemetryの生成AI向けの規約が整備されています[4]。共通の項目で記録すると対応する観測ツール間で記録を再利用しやすくなります。ただし、生成AI向けの共通規約は開発段階で、計測の実装には更新への対応が必要です[5]。
品質の評価には業務で重要な条件を正確に案内したかという基準を利用します。返品の例では返品可能な期間と対象商品の条件です。本番の出力を抽出して人が確認する方法や、LLM-as-a-Judgeによる採点があります。自動採点は人の判定との一致を確認して利用します[3:1]。品質が低下した事例は変更を公開する前の評価にも追加します。
効果とコスト・リスク
効果
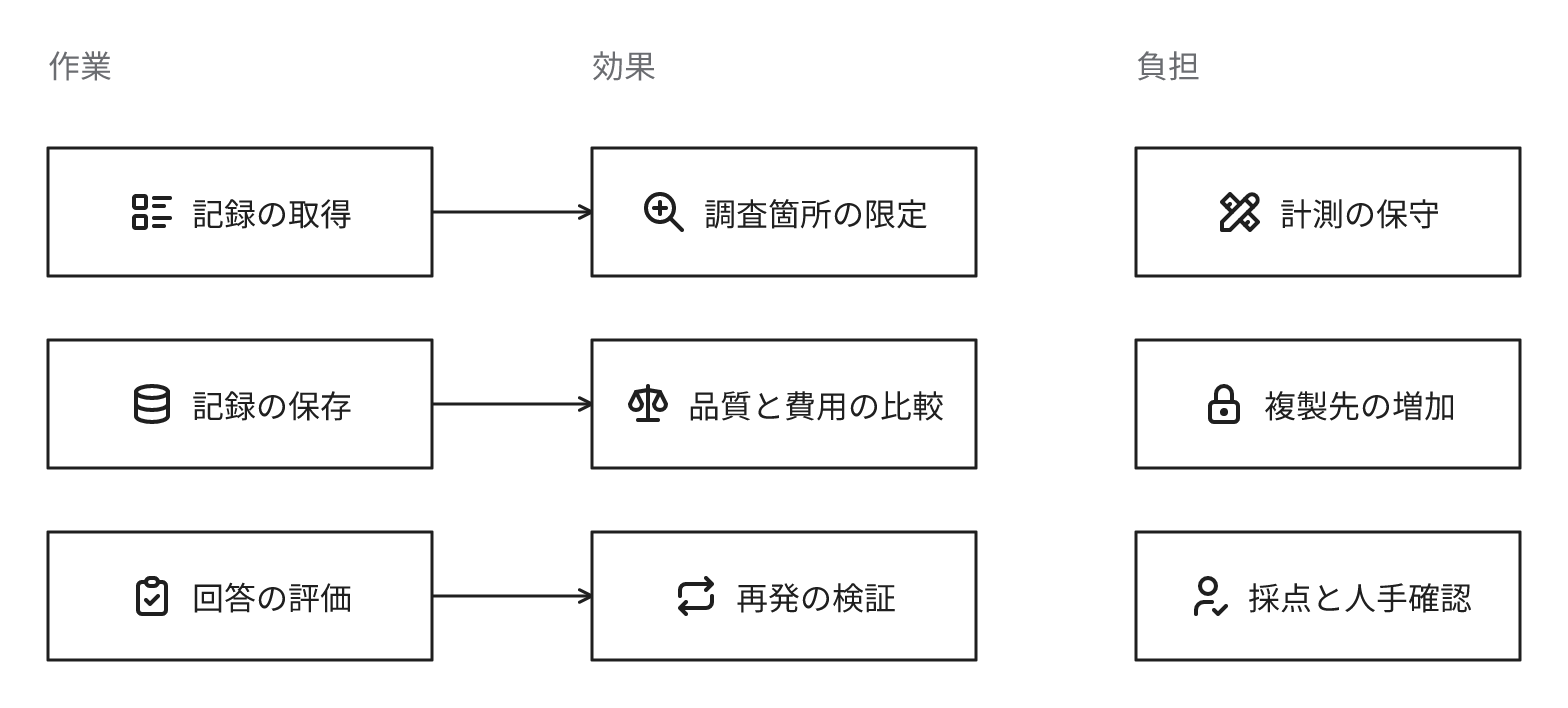
- 誤回答の報告を処理の記録と対応させ、調査する箇所を限定できる
- 品質と費用を同じ用途で比較し、改善対象を選択できる
- 本番で発生した失敗を評価用の課題に追加し、同種の失敗の再発を検証できる
コストとリスク
- 計測の実装と保守が必要で、モデルや処理を変更するたびに記録の欠落を確認する。記録の対象外の処理では誤りの原因を十分に調査できない場合がある
- 記録量と保存期間で変動する保存費用と、採点用モデルに応じた処理費用がかかる
- 業務を理解した担当者が回答と採点結果を確認し、評価基準を更新する時間が必要になる
- 顧客の入力や社内規程を記録すると、機密情報の複製先と管理対象が増加する
生成AI向けの観測ツールはどんな用途で必要か
顧客に直接回答する用途や、外部システムを更新するAIエージェントでは、本番の処理を追跡できるようにします。全用途に生成AI向けの観測ツールを導入する必要はありません。既存の監視や記録の仕組みで回答単位の処理と評価を確認できるなら、それを利用できます。
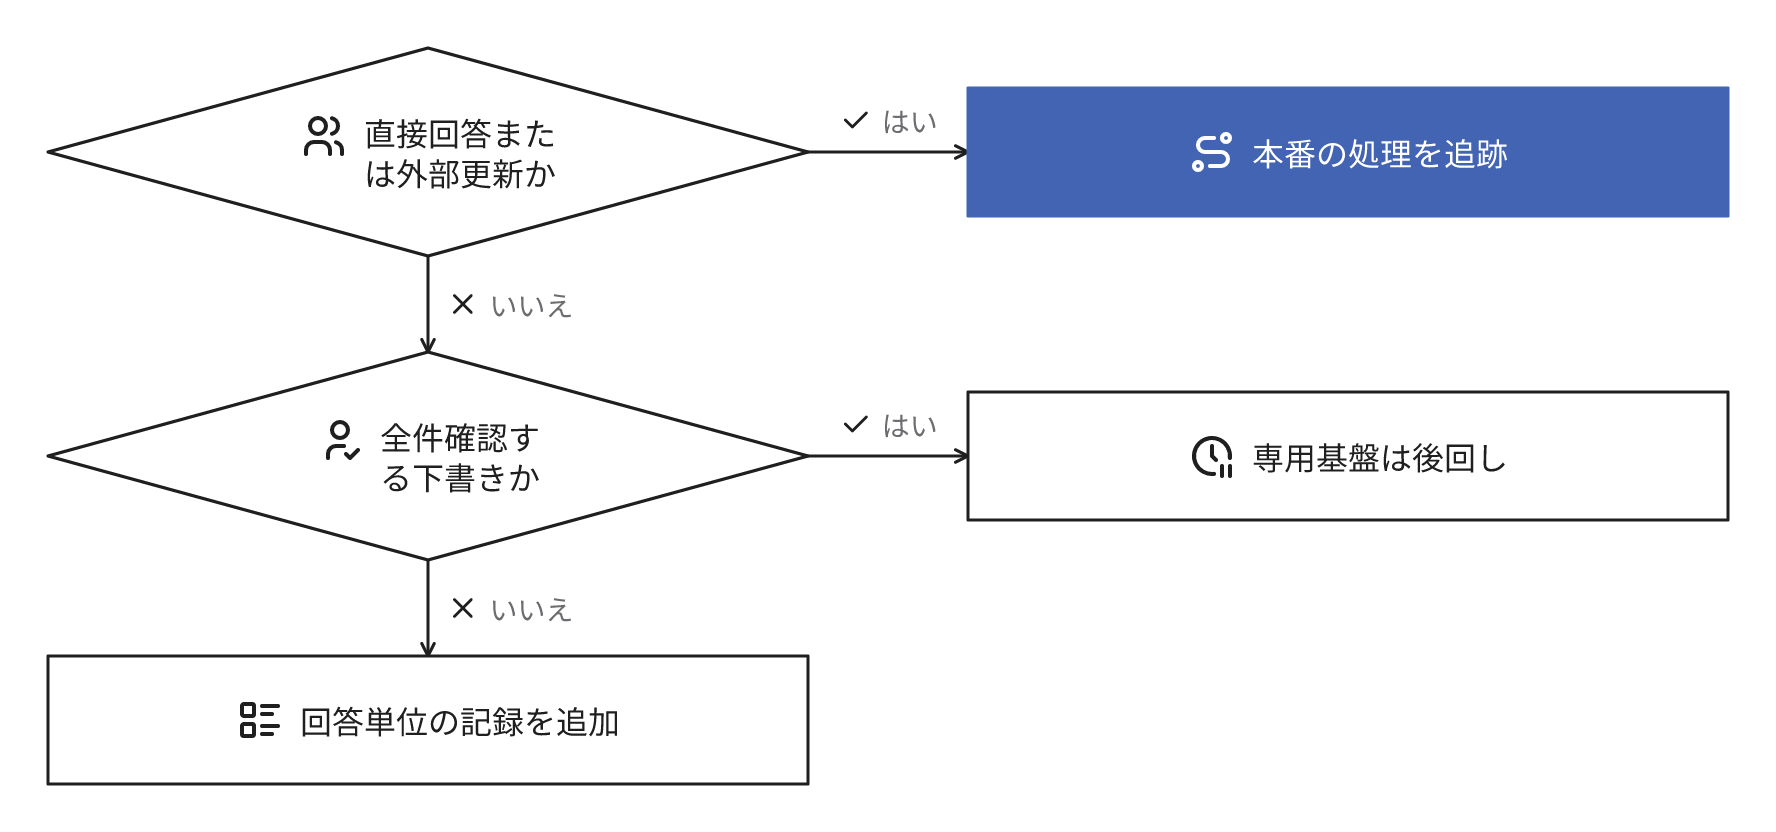
観測の範囲は誤りによる影響と、利用者の報告から原因を調査できるかで決定します。金額や契約条件に関係する回答では、条件の誤案内を表現の不備とは別に集計します。例えば返品不可の商品を返品可能と案内した誤りです。誤案内に従って顧客が返品手続きを開始すると、個別の対応が発生することがあります。この種の誤りは用途ごとに件数を確認し、増加した用途では人が確認してから回答する運用に変更します。外部システムを更新する用途では、AIが回答した完了の報告だけでなく、実際の処理結果も確認します。
一時的な資料の下書きで、人が全件を確認してから利用する用途では、専用の観測基盤の導入は後回しにできます。この用途でも反復利用が増加し、費用や誤回答・処理エラーの原因を調査できなくなったら、回答単位の記録を追加します。
入力や回答をどこまで保存すべきか
全文を一律に保存せず、調査と品質評価に必要な範囲を決定します。個人情報や機密情報を含む用途では、モデル名・使用量・処理時間などの記録と、入力や回答の本文を区別して管理します。本文が必要な場合は閲覧権限を限定した保存先を別に用意する方法もあります[6]。
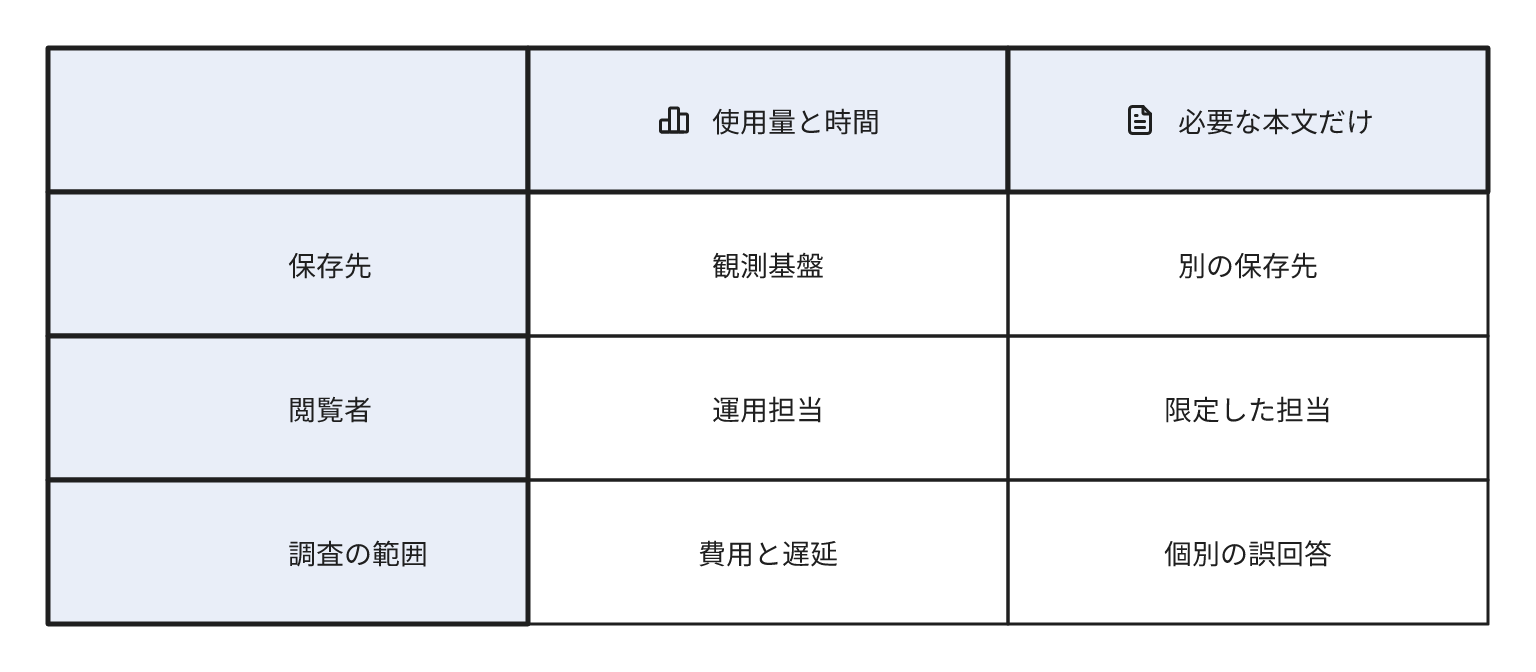
品質評価に不要な個人情報は、記録する前に除去できます。顧客の問合せに含まれる氏名や住所は、回答の品質評価に不要な場合があります。例えば返品の問合せではその部分を観測サービスへの送信前にマスキングで除去し、判断に必要な返品条件だけを記録します。送信前に機密情報を除去する機能は、観測ツールでも提供されています[7]。
LLM-as-a-Judgeを外部のモデルAPIで実行する場合は、その提供者にも評価対象の入力と回答が送信されます[8]。機密情報を含む用途では採点の送信先も保存先と同じ基準で確認します。
保存期間と閲覧できる担当者も同時に決定します。本文を保存しない方式では費用や遅延を調査できますが、個別の誤回答の原因は十分に検証できない場合があります。調査できる範囲の制約も含めて、何を保存するかを選択します。
よくある誤解
観測していれば誤回答や危険な操作を防止できる
観測の記録は発生した処理の把握と調査に利用します。回答の送信や操作の実行を制御するAIガードレール、人が承認するヒューマンインザループは別に設計します。観測によって意図しない送金や削除の実行を検知できても、既に実行した処理を復旧できるとは限りません。
What is AI observability?(IBM、2026年6月22日更新) ↩︎ ↩︎
AI Observability & Application Tracing(Langfuse) ↩︎ ↩︎
Evaluation Overview(Langfuse) ↩︎ ↩︎
Semantic conventions for generative AI client inference(OpenTelemetry) ↩︎
Semantic conventions for generative AI systems(OpenTelemetry) ↩︎
Semantic conventions for generative client AI spans(OpenTelemetry)。Capturing instructions, inputs, and outputs節 ↩︎
Masking sensitive LLM data(Langfuse) ↩︎
LLM-as-a-Judge(Langfuse)。評価に利用するモデルの接続先の設定。 ↩︎
関連用語
大規模言語モデル
成熟度:
生成AI
成熟度:
監視
成熟度:
LLMの評価(eval)
成熟度:
LLM-as-a-Judge
成熟度:
AIガードレール
成熟度:
AIエージェント
成熟度:
ハルシネーション
成熟度:
トークン(生成AI)
成熟度:
RAG
成熟度:
ヒューマンインザループ
成熟度:
運用・保守
成熟度:
同じ分野の用語
AI・機械学習の用語をすべて見るお問い合わせ・ご相談
システム開発、データ活用、プロダクトづくりのことならお気軽にご相談ください。要件が固まる前の整理や、お見積もりだけのご依頼も承ります。