
データレイクとは
データレイクは業務システムの記録、操作ログ、画像、PDFの文書、センサーの値など形式の異なるデータを、加工前の元の形式を含めて1か所に集約するデータの保管基盤です。
集約したデータは分析や機械学習の材料として利用します。
構成の一例としてクラウドのストレージにシステム別、日付別のフォルダを用意し、各システムが出力したファイルを定期的に追加していく形があります。
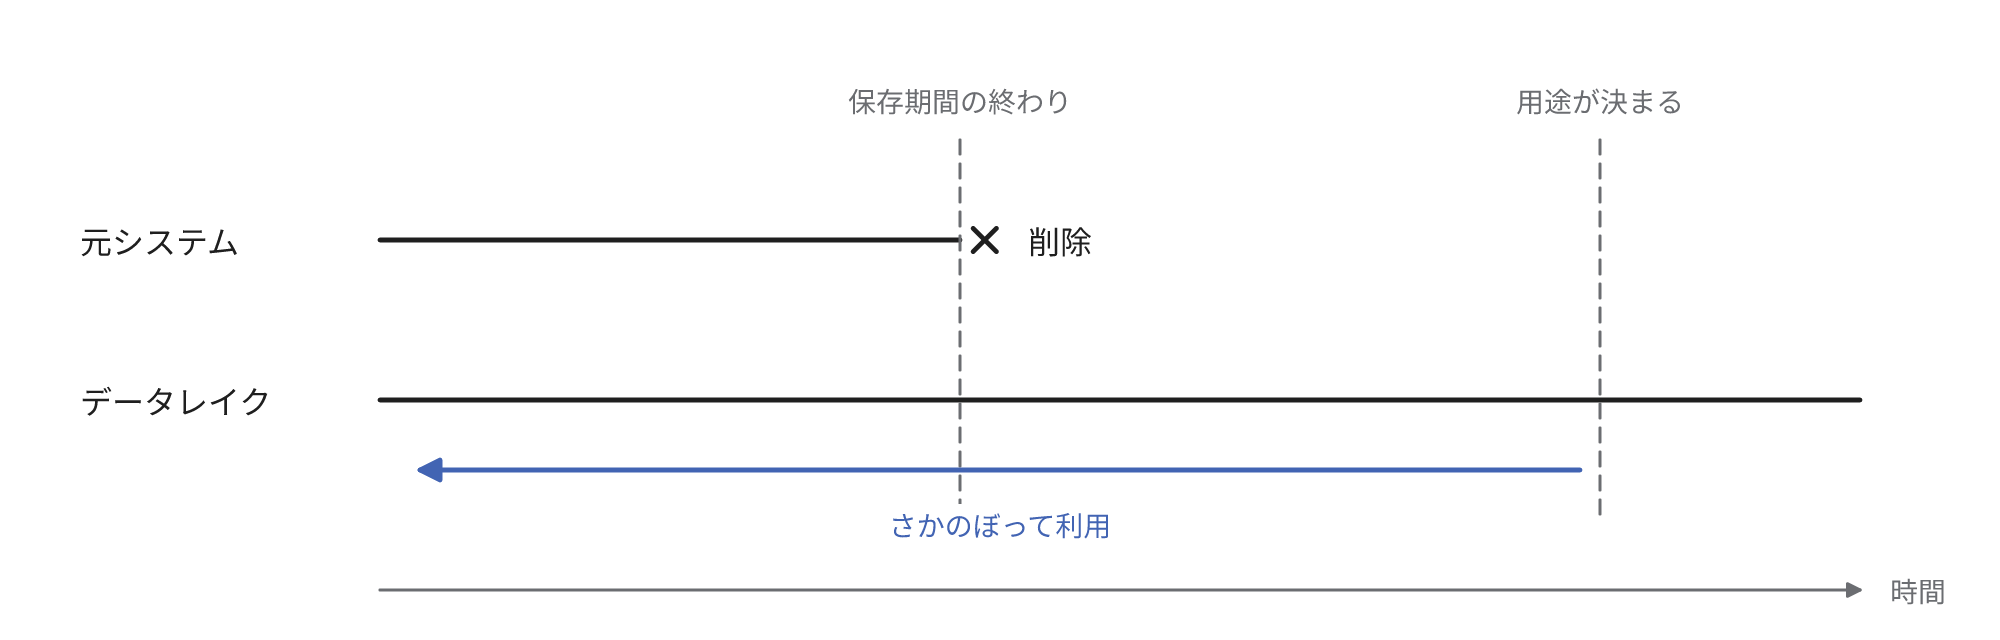
分析や機械学習の用途が後から確定した場合も、加工前の元データにまで遡及して利用できます。
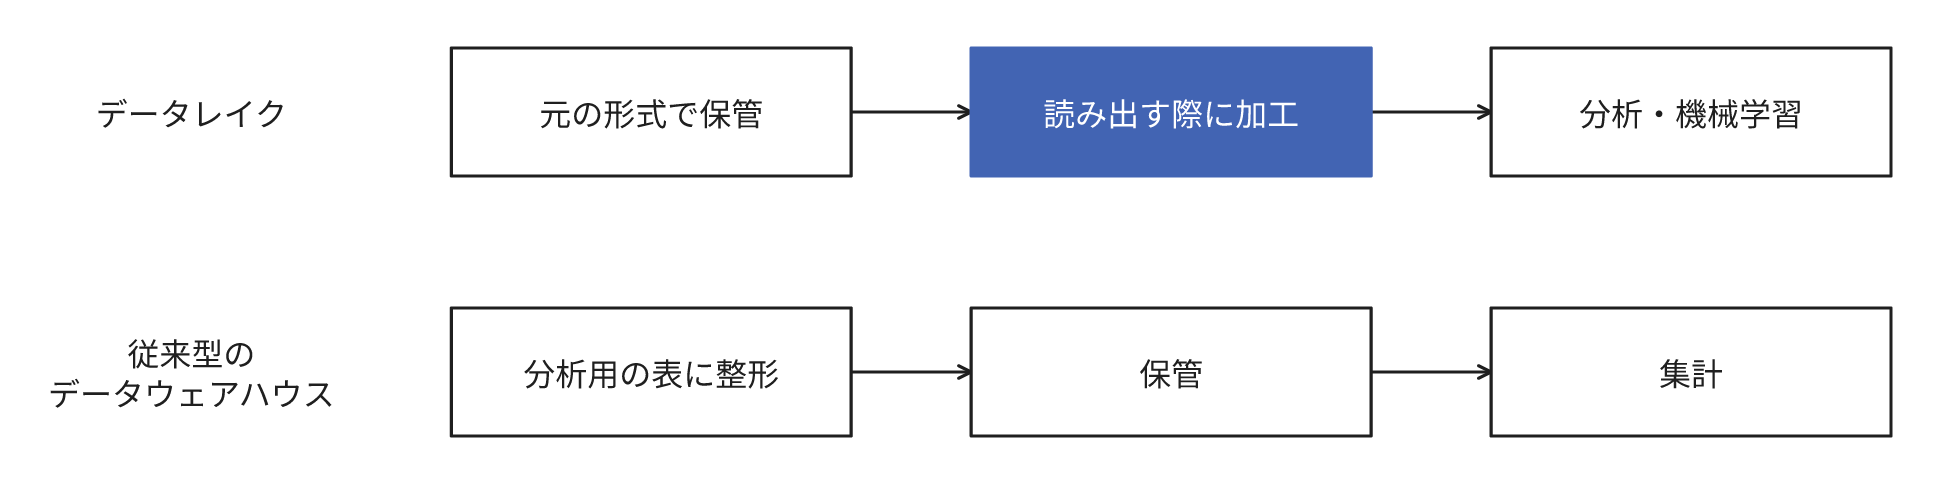
保存の時点では分析用の項目や、各項目が数値、日付、文字のどれにあたるかといったデータの種類をすべては統一せず、読み出しの際に解釈・加工するため、保存は容易ですが、そのままでは集計表になりません。
比較対象のデータウェアハウスは主に表の形に整理したデータの高速な集計に適合した分析基盤で、分析用に整形した表での集計が利用の中心です。
データレイクは元の形式のまま保管し、用途に応じて加工する点が異なります。
データウェアハウスが品目別に棚を指定した倉庫だとすれば、データレイクは荷物を箱のまま受け入れる保管庫に近いです。
箱に中身と送り主を記入しておかなければ、後から必要な荷物を特定できません。
用途が未定のデータも保存できる
従来のデータウェアハウスは保存前に項目を定義した表形式のデータを処理する仕組みです。
画像や文書のように表形式で表現できないデータの管理には不向きでした。
元のデータを別に保存していなければ、元システムの保存期間が経過した時点で削除され、後から新規の分析を計画しても、過去の期間を遡及して集計できない場合がありました。
データレイクはどの分析に利用するか未定のデータも安価なストレージにそのまま保管し、用途が確定した時点で取得する手段です。
分析の切り口が事前に分からない状況で有用と位置づけられています。
効果
- 元システムで削除される操作ログや履歴を、低い保管費用で長期間保管できる
- 表、ログ、画像、文書を、形式ごとに別の保管先を用意せず1か所に集約できる
- 機械学習やAIのモデルの学習に、加工前のデータを利用できる
- 新規の分析の切り口が確定した時点で、過去の期間を遡及して再集計できる
コストとリスク
- 中身の説明、出どころ、更新日を記録する仕組みがないと、データを検索できず信頼もできないデータスワンプになる
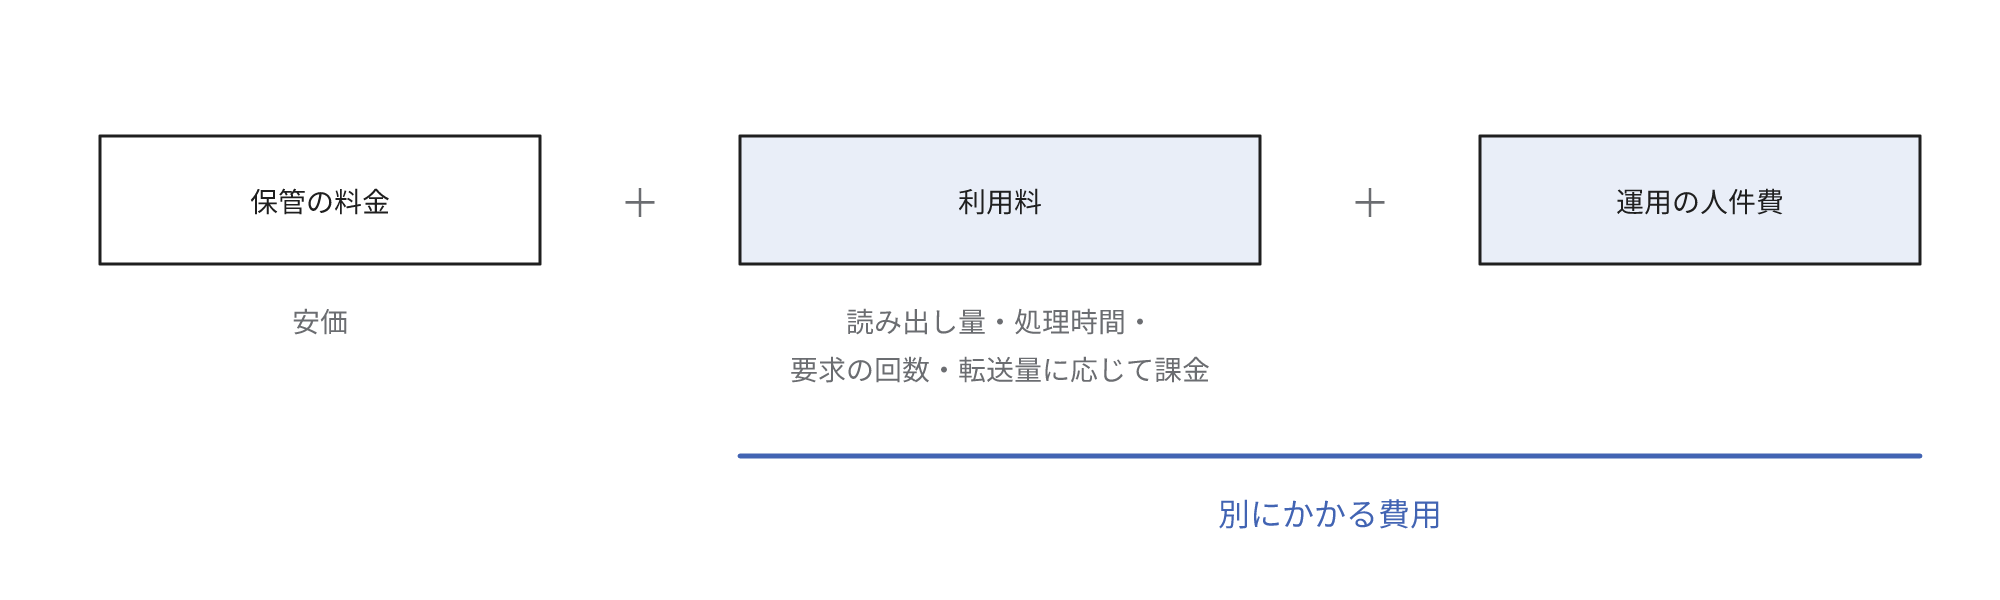
- ストレージの料金は安価でも、データの読み出し量、処理時間、要求の回数、転送量に応じて費用が増加する
- 個人情報や機密文書を含むデータを保管する場合は、参照できる人の管理と監査のほか、保存期限、削除、生成AIへの利用可否を複製先も含めて決定する必要がある
- データウェアハウスにも複製して集計する構成では、二系統の管理による遅延と不整合のリスクが生じる
- 取り込みの監視、フォルダ構成と保持期間の管理、利用部門からの問合せ対応に、運用担当が継続して必要になる
- 業務部門が利用するにはデータの整理や分析ツールの設定を別に用意する必要がある
データレイクを構築するかの判断
とりあえず全データを蓄積しておけば後で利用できるか
管理の情報を付与せずに蓄積したデータは、必要なものの検索も、利用の可否の決定も困難になります。
誰が何のために格納したかが不明なデータは、利用前の確認と整理に多大な工数が必要です。
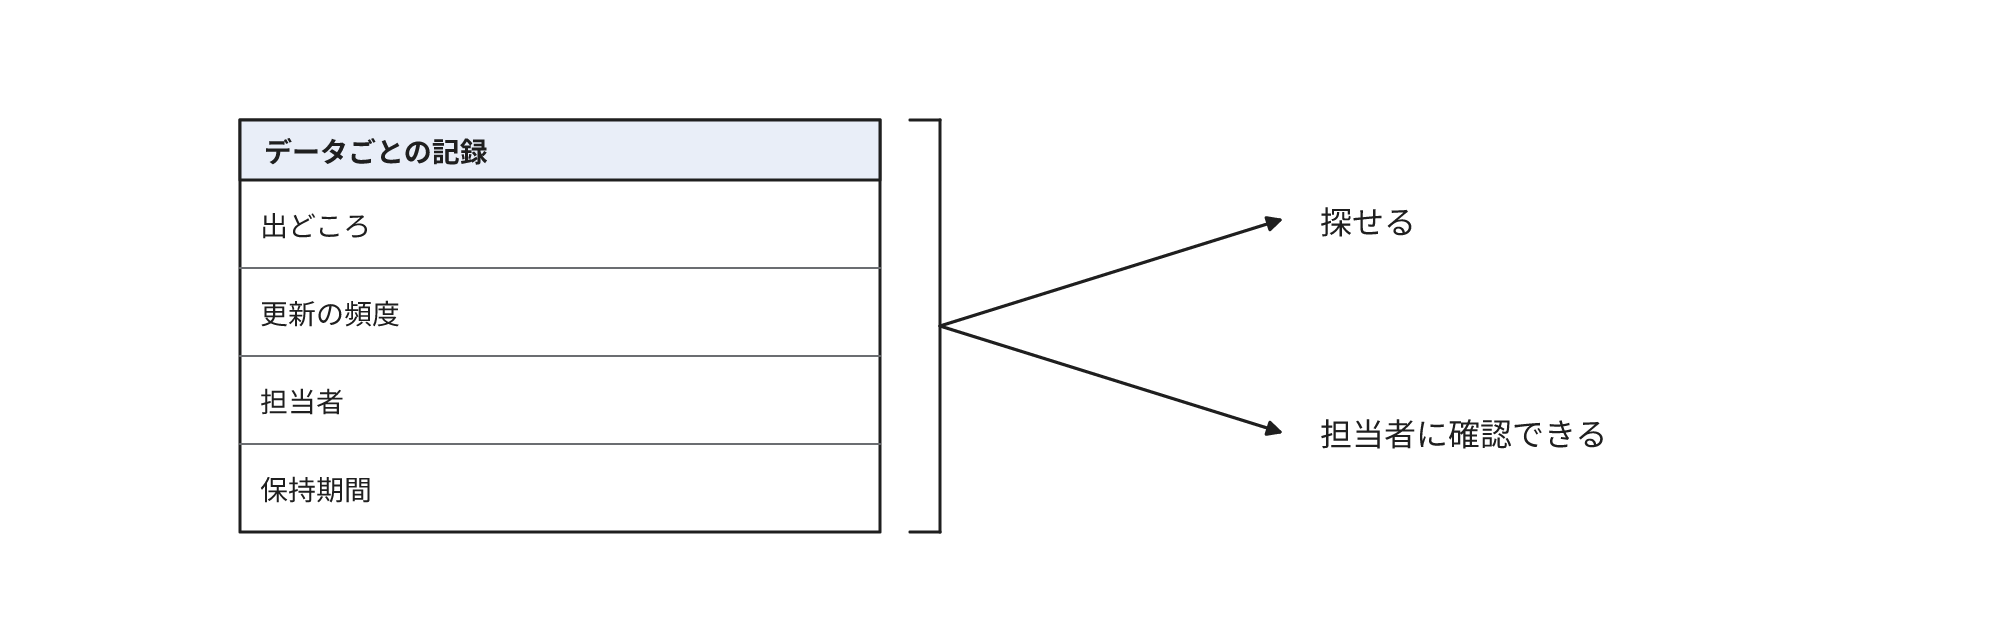
保管時にはデータごとに出どころ、更新の頻度、担当者、保持期間の4点を記録します。
4点が不足しているデータは、責任者を指定して補完するか、利用目的と法令上の保存義務を確認したうえで保管の要否を決定します。
4点は検索と担当者への確認の手掛かりです。
利用の可否は参照の権限や利用目的も確認して決定します。
データウェアハウスとどちらが必要か
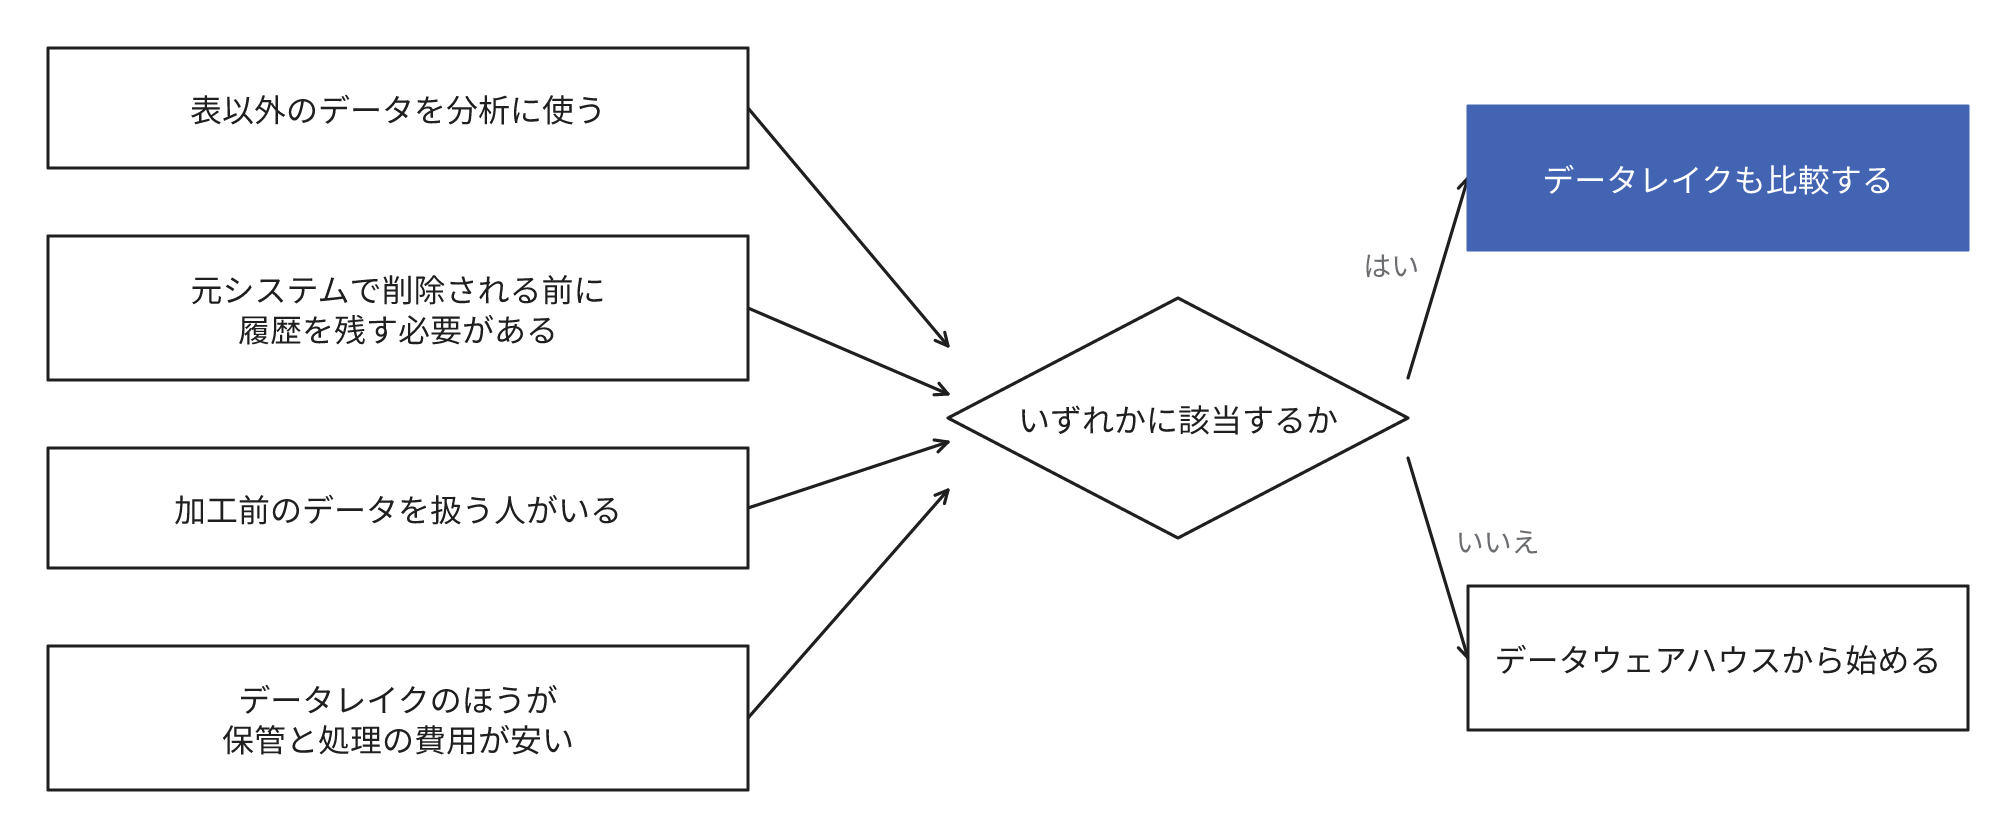
売上や在庫の集計表を部門で共有することが目的なら、データウェアハウスが先です。
受注や会計などの表形式のデータが中心なら、データウェアハウス単独で開始できることが多いです。
次のいずれかに該当する場合は、データレイクも比較の対象にします。
- 操作ログ、画像、音声、文書など表形式でないデータを分析や生成AIに利用する
- 元システムの保存期間が短く、削除される前に履歴を保存する必要がある
- データサイエンティストなど、加工前のデータを直接扱う利用者が社内にいる
- 長期に保管するデータが多く、保管と処理の費用を見積もるとデータウェアハウスへの格納より安価になる
データウェアハウスとデータレイクを両方保有する構成では、二系統の管理が生じます。
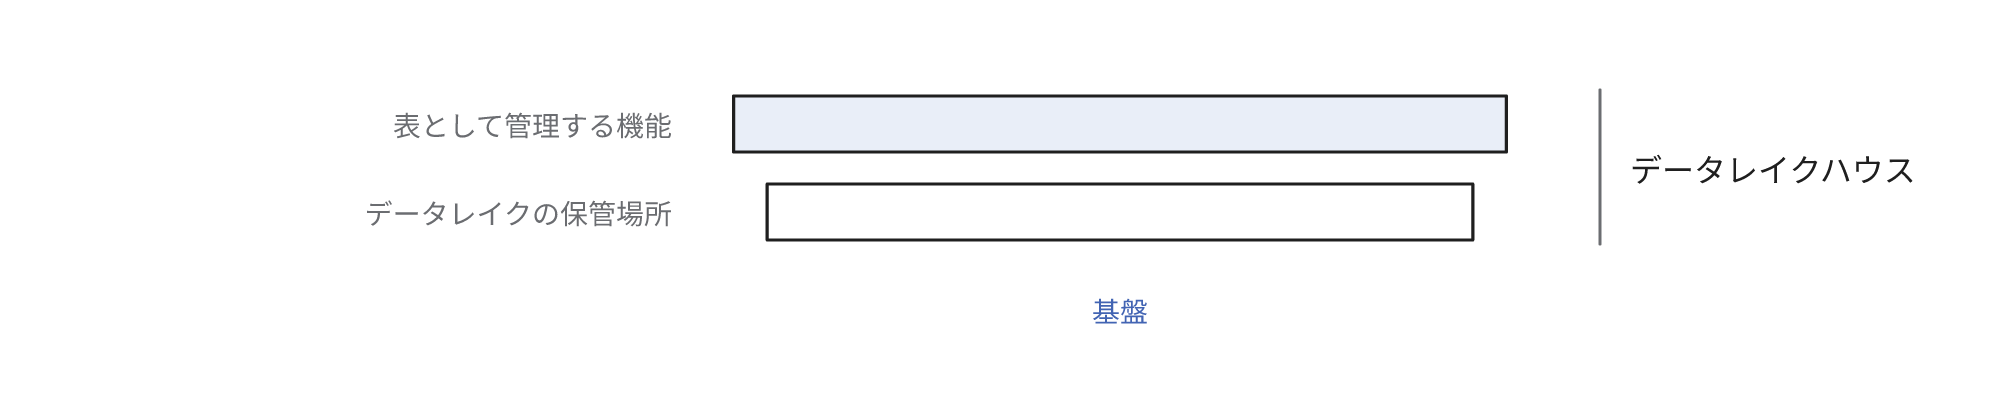
これを避ける構成としてデータレイク上にデータウェアハウスと同等の表の管理機能を実装し、データウェアハウスと同様の集計を可能にするデータレイクハウスが提唱されています。
既存のデータウェアハウスを維持したまま、データレイクハウスを併用する構成もあります。
集計表の共有と機械学習で同じデータを利用するなど、構成を統合する利点が顕著な場合に検討します。
利用されていないデータレイクを再建するには
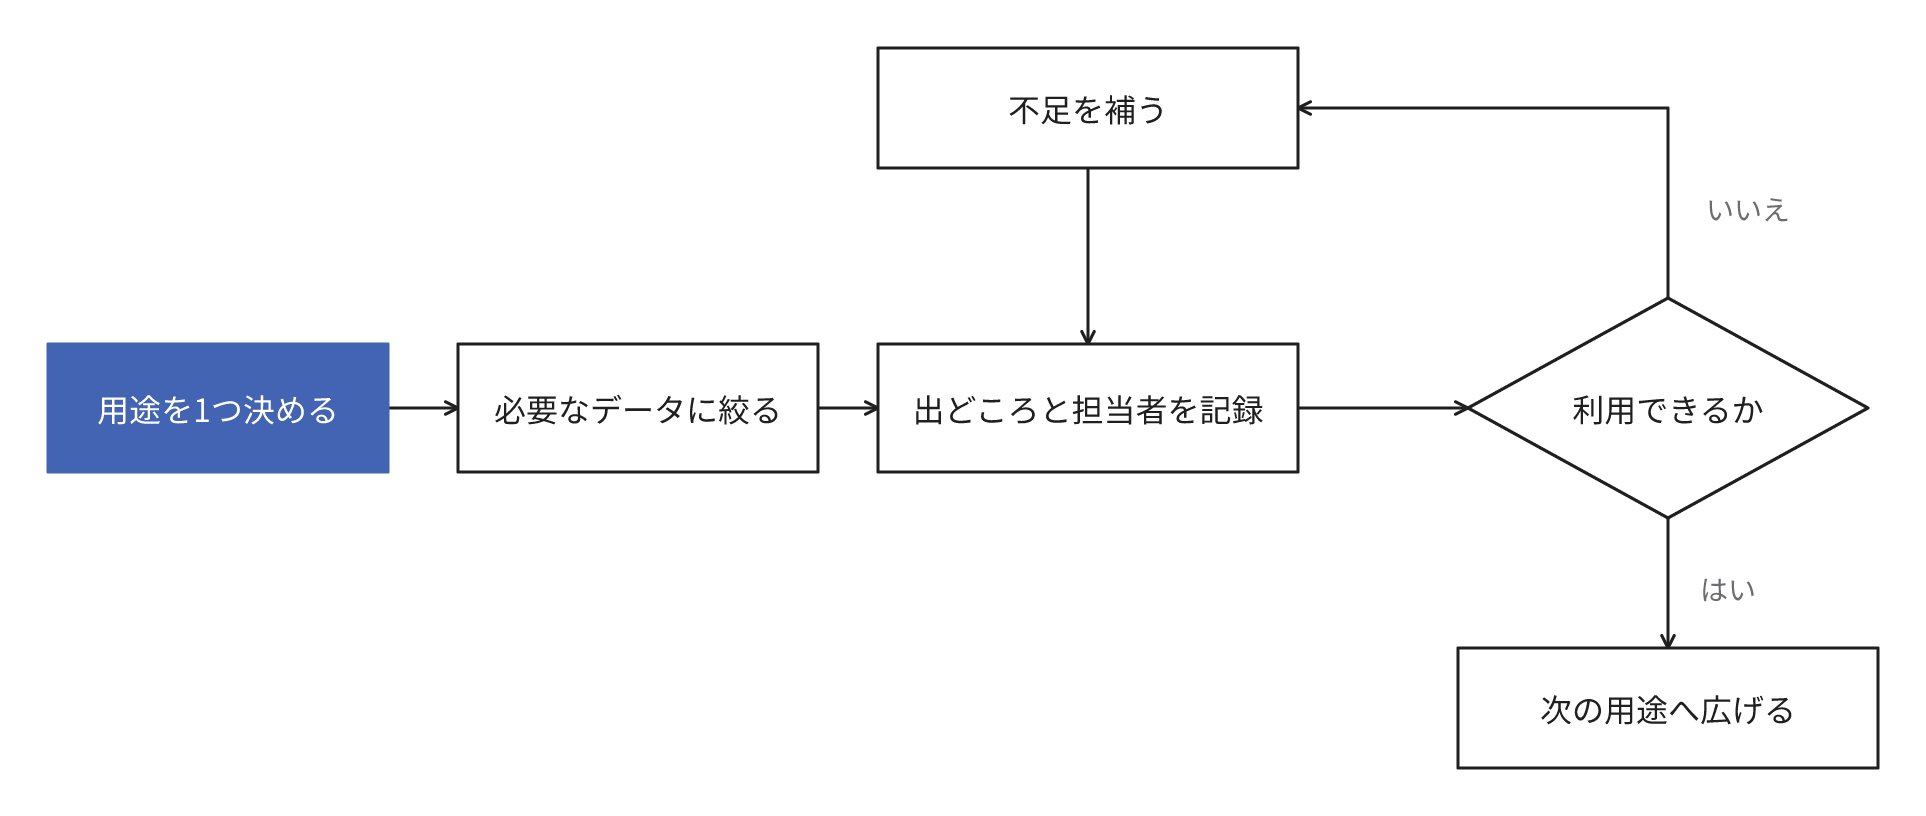
全体の整理から開始せず、現在利用されている、または利用したい用途を1つに限定し、その用途に必要なデータだけを管理対象にします。
管理対象のデータには出どころと担当者を記録し、利用できる状態を確認してから次の用途へ拡大します。
どの用途にも紐づかないデータは、法令上の保存義務を確認したうえで保持期間を決定し、低価格の保管階層へ移行するか削除します。
低価格の保管階層は取り出しに時間を要する、取り出しの料金や最低保管期間がある、といった制約を確認してから利用します。
保管しているだけで費用が増加するうえ、個人情報を含む場合は漏えい時の本人への影響も考慮する必要があります。
影響は含まれる情報の種類や件数などに基づいて評価します。
よくある誤解
ストレージが安価なので費用はほとんどかからない
保管の料金は安価ですが、データの格納、加工、読み出しの処理にかかる利用料と、運用担当の人件費が別に発生します。
保管の料金だけでなく、処理の量と運用の体制を含めて年間の費用を見積もります。
データレイクハウスの登場でデータレイクは旧式になった
データレイクハウスはデータレイクの保管場所にデータウェアハウスの管理機能を追加した構成です。データレイクの代替ではありません。
元のデータを安価に保管するデータレイクの役割を基盤として維持し、その上に分析用のデータを表として管理する機能を追加します。
クラウド事業者の製品の例では、Microsoftの分析サービスであるMicrosoft Fabricが利用環境ごとに1つのデータレイクであるOneLakeを自動で用意します。
データウェアハウスやレイクハウスのデータもOneLakeに格納する設計です。
データレイクハウスでは元のデータをデータレイクの安価な保管場所に保管したまま、その上で表の管理機能を利用できます。
お問合せ
事業の課題や技術的な悩みなどどんなことでもお聞かせください