テストパフォーマンスの最適化
こちらの文章は以下の記事を翻訳したものです。 https://github.com/HypothesisWorks/hypothesis/blob/master/HypothesisWorks.github.io/_posts/2016-04-29-testing-performance-optimizations.md
基本的なクラッシュバグをコードから除去した後、もっと興味深いテスト対象を見つける必要があります。
最もテストが容易なのは、すべての入力に対して正しい答えが既知であるコードです。
理論上、正しい答えが分かっている場合、そのコードを実行して検証することは可能です。しかし、それは検証しようとしている答えそのものであるため、あまり有用ではありません。
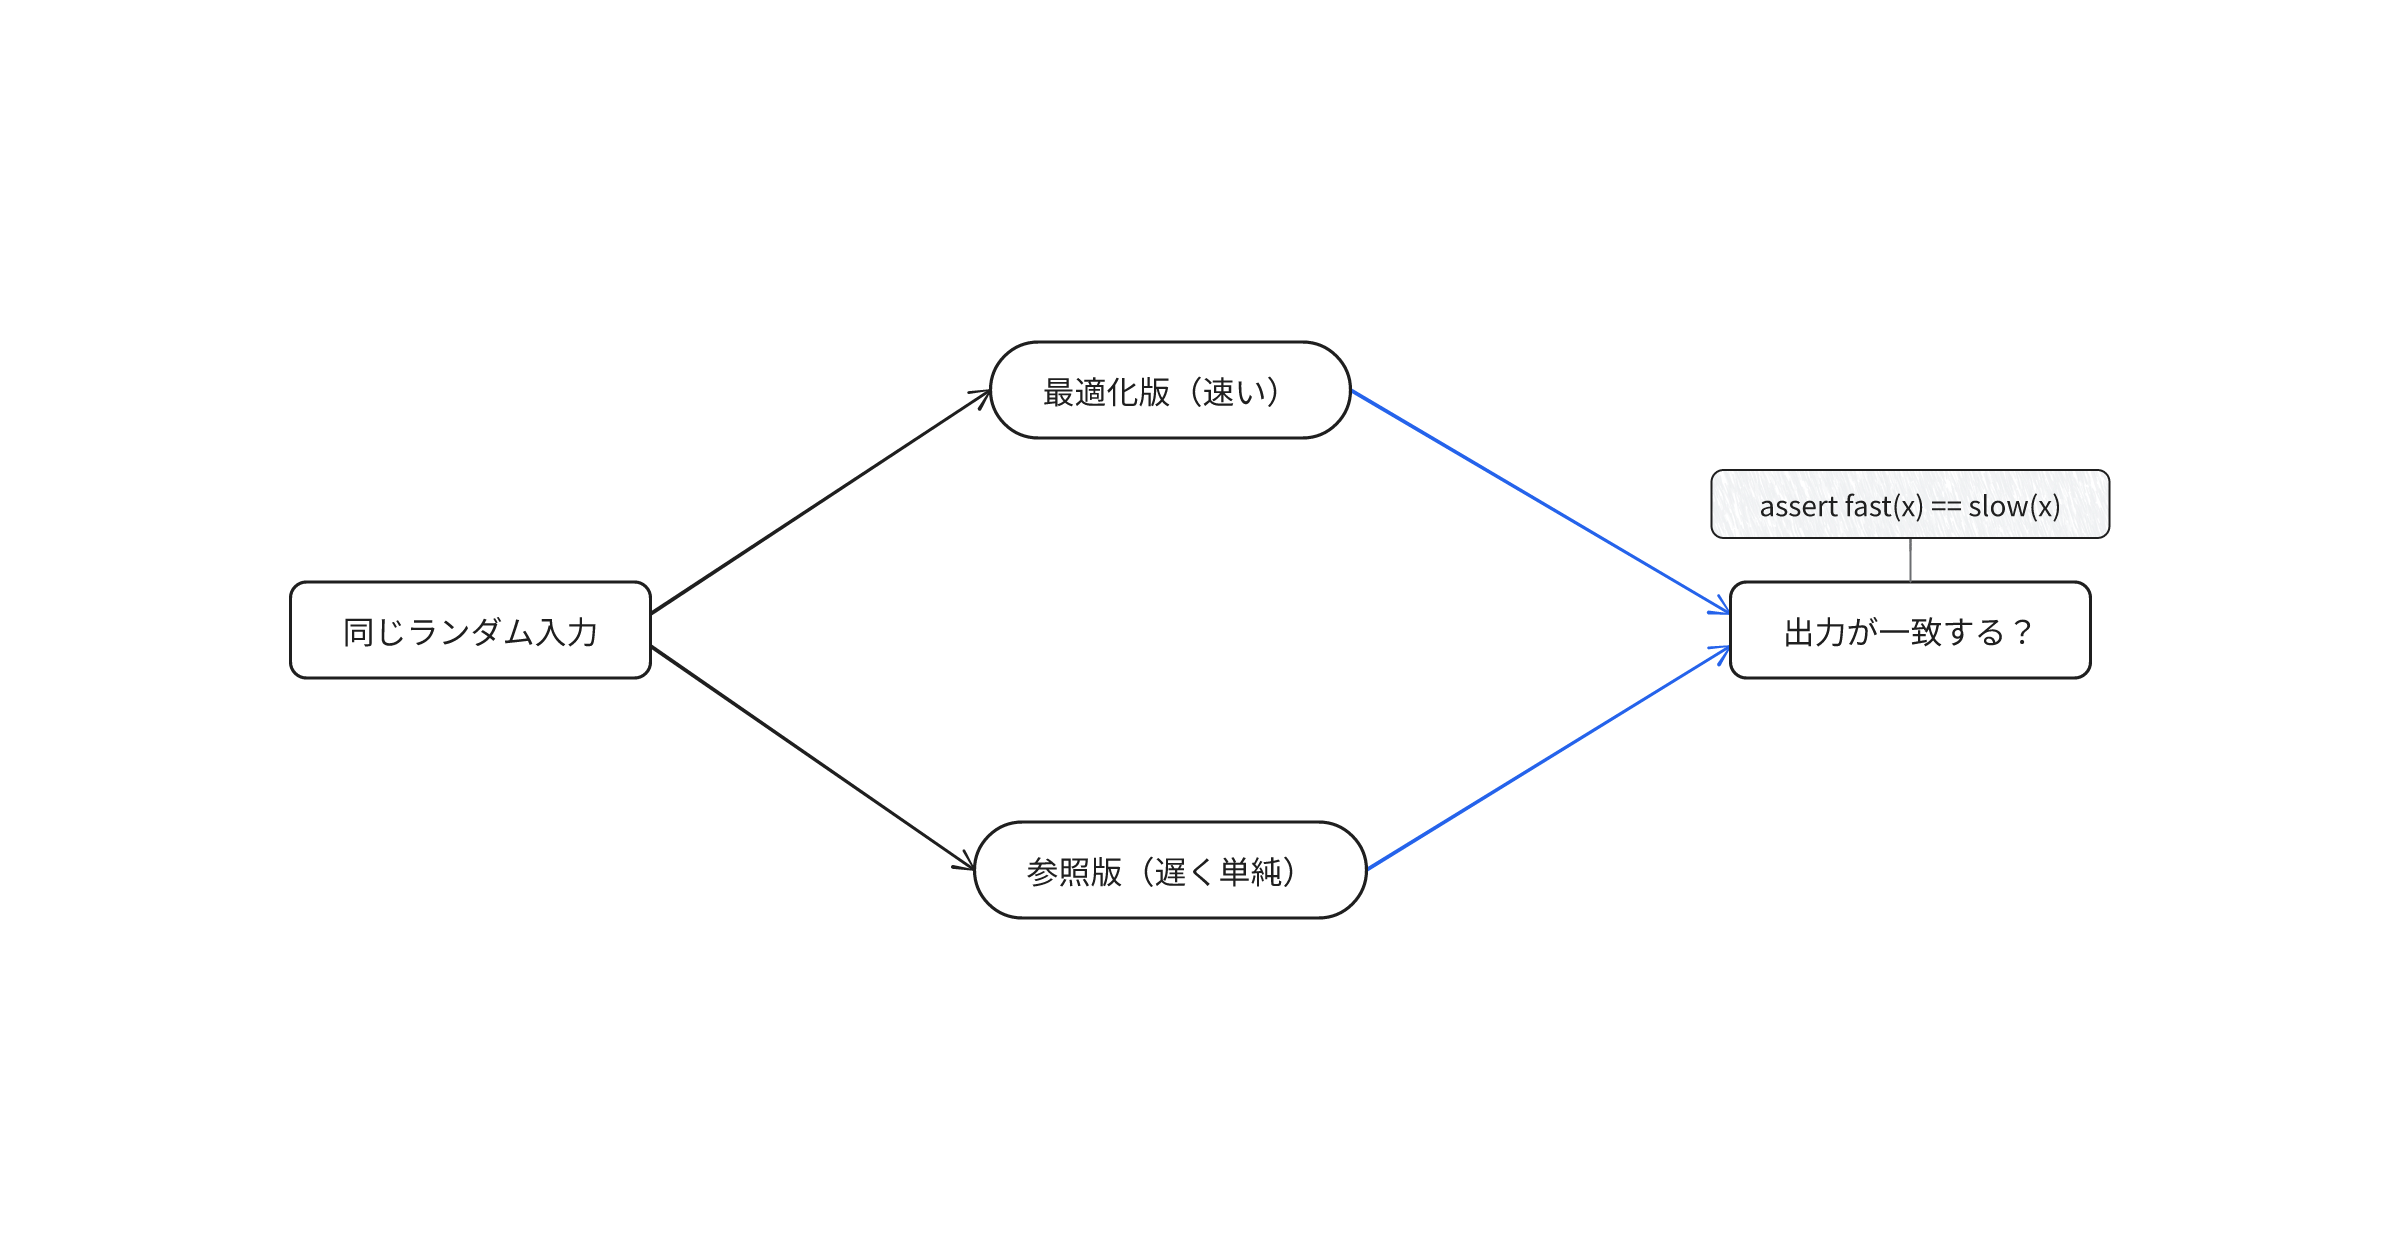
しかし、正しい答えを得る方法が複数存在する場合があります。そして、実際の運用で採用される方法が選ばれる理由は、異なる答えを提供するためではなく、同じ答えをより速く提供するためである可能性があります。
例えば、以下のような状況が考えられます。
- 複雑かつ高速なバージョンのアルゴリズムと、遅く、単純なバージョンのアルゴリズムが存在する場合。
- キャッシングレイヤーを導入しており、キャッシングを有効にした状態と無効にした状態、または異なるキャッシュのタイムアウト設定でコードを実行することができる場合。
- スケーラビリティを向上させるために新しいデータベースバックエンドに移行していても、移行が完了するまでは古いバックエンドのコードが使われている場合。
他にも様々な可能性が考えられますが、これらが最も一般的なケースのようです。
いずれにしても、これはプロパティベーステストに適した素晴らしいユースケースを提供します。なぜなら、2つの関数が常に同じ答えを返すべきだとされているときに、それをテストできる機会だからです。単純に同じデータを使って両方の関数を呼び出し、その結果が一致することを確認すれば良いのです。
例えば、高度なアルゴリズムの場合を想定してみましょう。たとえば、マージソートを実装したとします。
def merge_sort(ls):
    if len(ls) <= 1:
        return ls
    else:
        k = len(ls) // 2
        return merge_sorted_lists(merge_sort(ls[:k]), merge_sort(ls[k:]))

def merge_sorted_lists(x, y):
    result = []
    i = 0
    j = 0
    while i < len(x) and j < len(y):
        if x[i] <= y[j]:
            result.append(x[i])
            i += 1
        else:
            result.append(y[j])
            j += 1
    return result
テストの対象として使用するためのリファレンス実装が必要ですので、バブルソートも実装してみましょう。
def bubble_sort(ls):
    ls = list(ls)
    needs_sorting = True
    while needs_sorting:
        needs_sorting = False
        for i in range(1, len(ls)):
            if ls[i - 1] > ls[i]:
                needs_sorting = True
                ls[i - 1], ls[i] = ls[i], ls[i - 1]
    return ls
これらのコードは同じ結果を返すはずですので、テストしてみましょう。
@given(lists(integers()))
def test_bubble_sorting_is_same_as_merge_sorting(ls):
    assert bubble_sort(ls) == merge_sort(ls)
しかし、エラーが発生しました。
@given(lists(integers()))
    def test_bubble_sorting_is_same_as_merge_sorting(ls):
>       assert bubble_sort(ls) == merge_sort(ls)
E       assert [0, 0] == [0]
E         Left contains more items, first extra item: 0
E         Use -v to get the full diff

foo.py:43: AssertionError
----- Hypothesis -----
Falsifying example: test_bubble_sorting_is_same_as_merge_sorting(ls=[0, 0])
問題が発生したのは、merge_sorted_lists 関数の実装に誤りがあったためです。片方のリストが終了した後にもう片方のリストに残っている要素を含める処理が不足していました。その結果、リストから要素が失われ、より単純な実装では発生しない問題が発生しました。
以下の方法で修正を行いました。その後、テストが成功するようになりました:
def merge_sorted_lists(x, y):
    result = []
    i = 0
    j = 0
    while i < len(x) and j < len(y):
        if x[i] <= y[j]:
            result.append(x[i])
            i += 1
        else:
            result.append(y[j])
            j += 1
    result.extend(x[i:])
    result.extend(y[j:])
    return result
このテクニックは特にHypothesisのルールベースドステートフルテスティングと非常にうまく組み合わせることができます。なぜなら、これを使用して複雑なAPIの異なる実装をテストできるからです。例えば、Hypothesisはこのプロパティをステートフルテスティングと組み合わせて、異なる実装が同一の動作を示すことを検証しています。